2.10 深度估计 (Depth Estimation)
2.10 深度估计 (Depth Estimation)
本节摘要:单目摄像头缺深度信息。本节讲深度估计——从单目/双目估计距离,弥补 CV 测距弱的关键技术。
你能学到什么
阅读完本节,你应当能够:
- 理解深度估计的必要性
- 知道单目和双目深度估计
- 了解在自动驾驶的应用
概念脉络
为什么需要深度估计
摄像头缺深度信息(2D 图像无距离),但自动驾驶要知道目标多远。深度估计从图像推断距离,弥补 CV 测距弱。
深度估计方法
图 2-10 深度估计方法
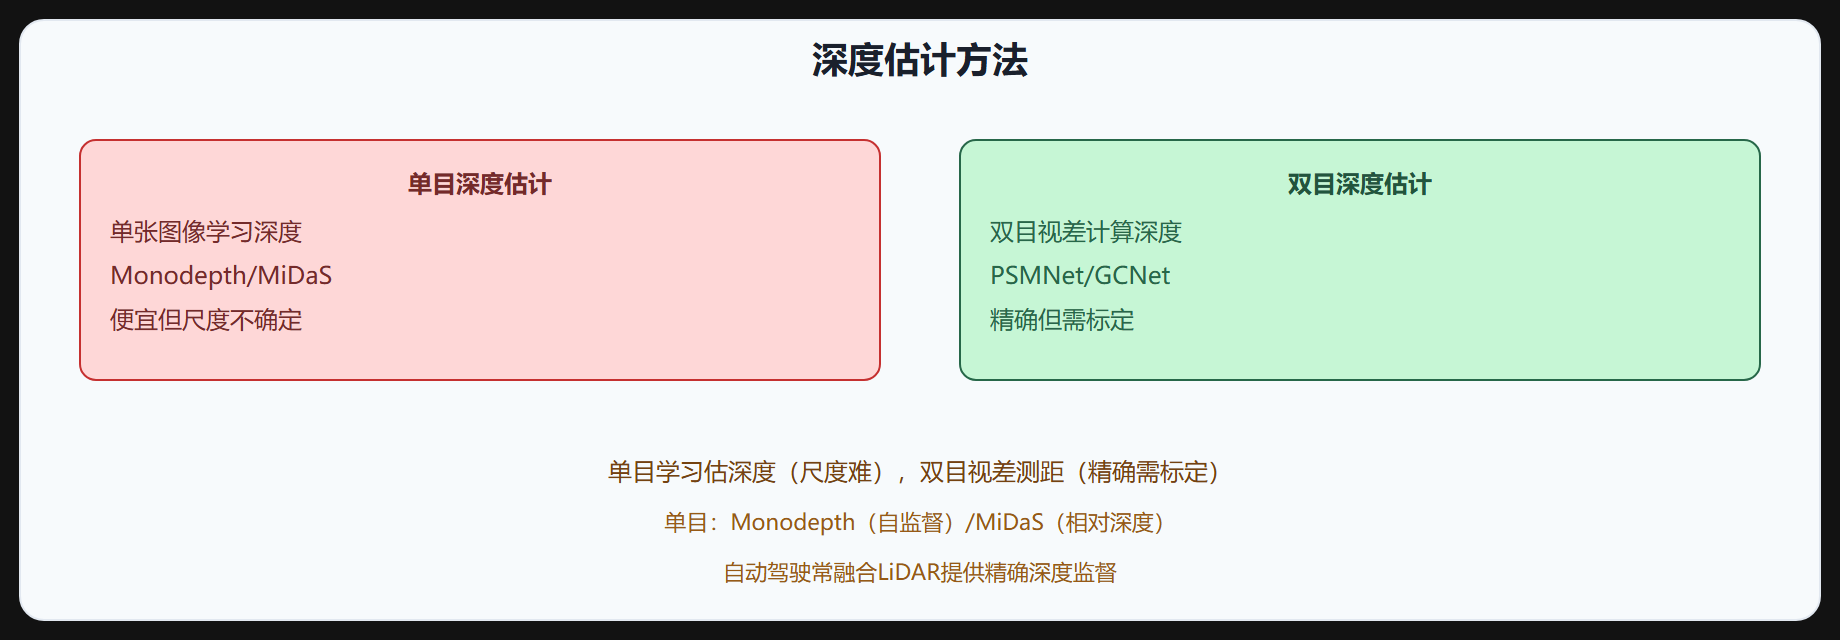
| 方法 | 特点 |
|---|---|
| 单目深度 | 单图学习深度,便宜但尺度不确定 |
| 双目深度 | 视差计算,精确但需标定 |
单目深度估计
单目从单张图像学习深度,本质是病态问题(2D 到 3D 有歧义),靠学习几何先验:
- Monodepth:自监督(用视频时序一致性)
- MiDaS:相对深度(不绝对,但鲁棒)
- DPT:Transformer 深度估计
单目深度尺度不确定(不知绝对距离),需其他传感器校准。
双目深度估计
双目用左右摄像头视差计算深度:
- f:焦距
- b:基线(两摄像头距离)
- \text{disparity}:视差
双目深度精确,但需精确标定,基线短则远距离误差大。
代表模型
- PSMNet:空间金字塔匹配
- GCNet:几何卷积
- StereoNet:实时双目
在自动驾驶的应用
- 障碍物距离:估计前车距离(ACC、AEB)
- 3D 检测辅助:深度估计 → 3D 位置
- 可行驶区域深度:前方道路深度
- 泊车:近距障碍深度
深度估计与 3D 检测
深度估计是 3D 检测(2.4 节)的基础:图像 + 深度 → 3D 位置。单目 3D 检测本质就是单目深度估计 + 检测。
与 LiDAR 的关系
单目/双目深度估计精度不如 LiDAR,但便宜。自动驾驶常:
- LiDAR 提供精确深度
- 用 LiDAR 深度监督训练单目深度(半监督)
- 部署时单目深度做 LiDAR 冗余
挑战
- 单目尺度:绝对距离难
- 远距离:远目标深度误差大
- 纹理弱区域:双目视差难算
- 实时:自动驾驶要快
⚠️ 单目深度尺度:单目深度估计尺度不确定,不知绝对距离。需 LiDAR 或其他传感器校准尺度,或用双目。
💡 关键直觉:深度估计弥补摄像头缺深度。单目学习估深度(尺度难,Monodepth/MiDaS),双目视差测距(精确需标定,PSMNet)。自动驾驶用 LiDAR 提供精确深度,或监督训练单目。深度是 3D 检测基础。
本章回顾
- 必要性:摄像头缺深度,需估计距离。
- 单目:单图学习深度,Monodepth/MiDaS/DPT,尺度不确定。
- 双目:视差计算 depth=fb/disparity,PSMNet/GCNet,精确需标定。
- 应用:障碍物距离、3D 检测辅助、可行驶区域深度、泊车。
- 与 3D 检测:深度是 3D 检测基础(图像+深度→3D 位置)。
- 与 LiDAR:LiDAR 精确深度,可监督训练单目,或做冗余。
- 挑战:单目尺度、远距离、纹理弱、实时。
下一节讲 SLAM。
单目深度的尺度与不确定性
单目深度估计最头疼的是"尺度不确定"——一张白墙照片,它可能是 2 米外的墙,也可能是 20 米外的墙,纯靠单帧图像无法区分。所以单目深度模型通常输出归一化或相对的深度顺序,而不是绝对米数。要让绝对尺度可信,工程上常用三种手段:一是接 LiDAR 稀疏深度做在线校准,二是利用车辆自身运动(自监督)建立尺度约束,三是在模型输出后做一个全局尺度缩放(估计车辆与地面的相对几何)。部署时还要显式输出每个像素深度的不确定性,供下游决定"多相信还是少相信"。
# 伪代码:LiDAR 稀疏深度校准单目尺度 sparse_depth = lidar_project_to_image(points) # LiDAR->图像 pred = mono_depth_model(image) # 相对深度 scale = median(sparse_depth / pred[valid]) # 求全局尺度 abs_depth = pred * scale # 转绝对深度
自监督与双目视差
Monodepth 这类自监督方法不需要深度真值:把视频前后帧的视图重建误差当作监督信号,模型学到的深度必须"能解释相邻帧视角的变化",这样训练数据可以无限采集,成本极低。双目深度则是显式几何:左右相机拍同一物体有视差,视差与深度成反比(depth = f·b/disparity)。立体匹配要在一个 4D 代价体上做聚合,计算量大,StereoNet 用多尺度方式把代价体压缩到低分辨率再上采样,才做到实时。深度与 3D 检测结合时,深度图通常作为"伪点云"——每个像素按其深度反投影成一个 3D 点,喂给点云检测器,相当于用相机白送了一个 LiDAR。