2.11 SLAM 与视觉定位
2.11 SLAM 与视觉定位
本节摘要:自动驾驶要知道"我在哪"。本节讲视觉 SLAM——边建图边定位,自动驾驶定位的核心技术之一。
阅读收获
阅读完本节,你应当能够:
- 理解 SLAM 的作用
- 知道视觉 SLAM 流程
- 了解在自动驾驶的应用
概念脉络
SLAM 是什么
SLAM(Simultaneous Localization and Mapping)= 同时定位与建图:在未知环境边建地图边定位自己。自动驾驶用它做局部定位和地图构建。
视觉 SLAM 流程
图 2-11 视觉 SLAM 流程
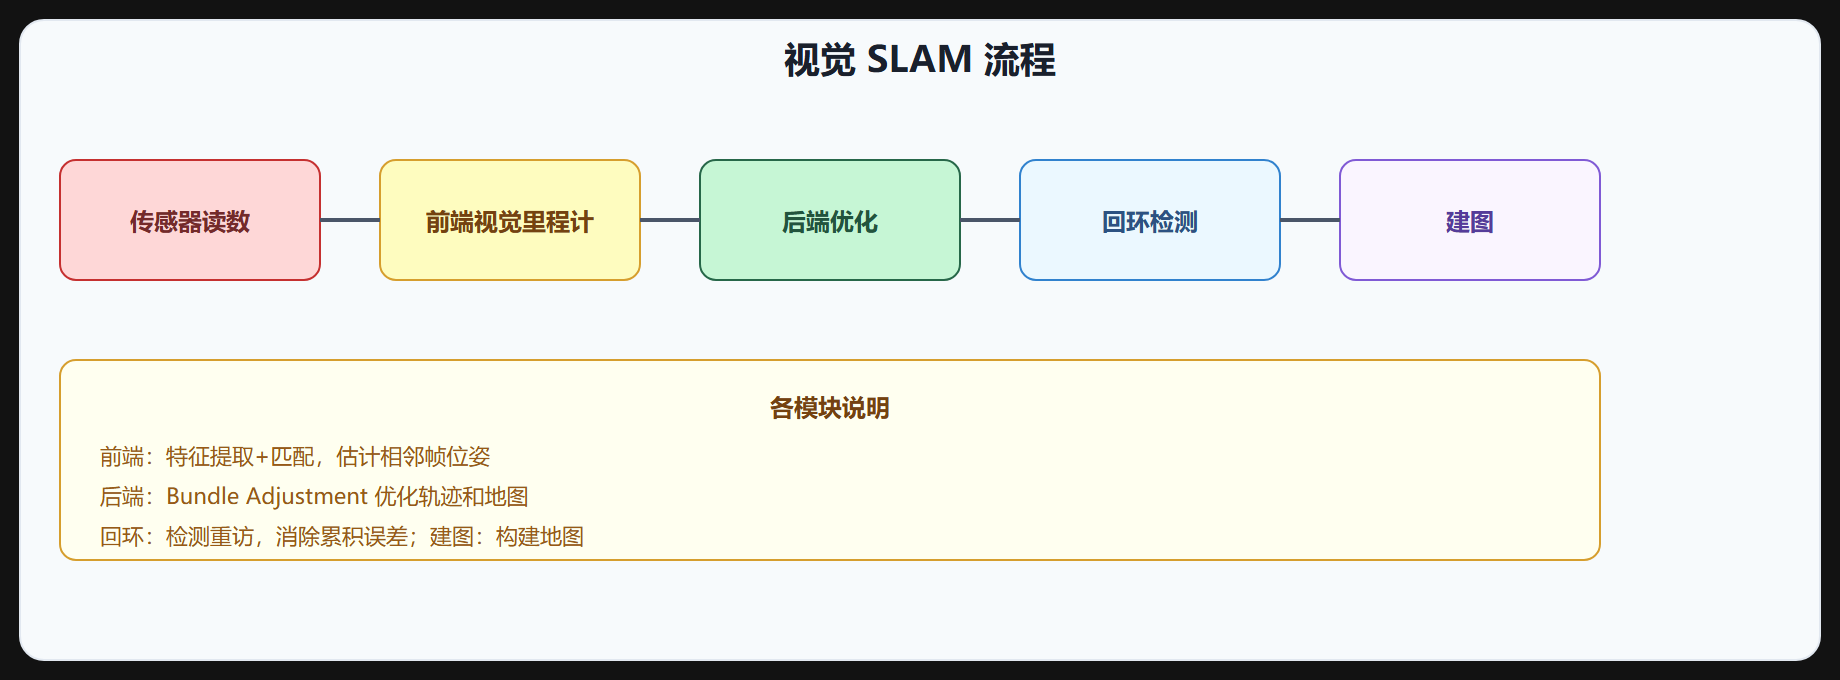
视觉 SLAM 四模块:
- 前端(视觉里程计):特征提取+匹配,估计相邻帧位姿
- 后端(优化):Bundle Adjustment 优化轨迹和地图
- 回环检测:检测重访,消除累积误差
- 建图:构建地图
代表 SLAM 系统
| 系统 | 特点 |
|---|---|
| ORB-SLAM | 特征点法,经典 |
| VINS-Mono/Fusion | 视觉+IMU 融合 |
| LSD-SLAM | 直接法 |
| DSO | 直接法稀疏 |
| KinectFusion | RGB-D |
自动驾驶常用 VINS(视觉+IMU)或 ORB-SLAM。
特征点法 vs 直接法
| 方法 | 特点 |
|---|---|
| 特征点法 | 提特征点匹配,ORB-SLAM |
| 直接法 | 用像素强度,LSD/DSO |
| 半直接法 | 结合,SVO |
特征点法稳定,直接法用全部信息但受光照影响。
视觉+IMU 融合
视觉 SLAM 常融合 IMU(VIO):
- IMU 提供高频运动
- 视觉提供尺度
- 互补,快速运动时视觉失效,IMU 兜底
VINS-Mono/Fusion 是视觉+IMU SLAM 代表。
在自动驾驶的应用
- 高精定位:在高精地图上定位(视觉+地图匹配)
- 建图:构建局部高精地图
- GPS 失效场景:隧道、地下车库
- 冗余:GPS/RTK 的冗余
SLAM vs 高精地图定位
自动驾驶定位两种方式:
- SLAM:边走边建图定位(适合未知环境)
- 高精地图定位:预建地图,实时视觉匹配定位(已知环境)
实际自动驾驶多用高精地图定位(地图预建),SLAM 用于建图和 GPS 失效场景。
挑战
- 动态环境:移动物体干扰
- 快速运动:模糊,特征丢失
- 纹理弱:白墙等少特征
- 回环:大场景回环检测难
- 实时:30Hz+
⚠️ SLAM vs 高精地图:自动驾驶已知道路多用高精地图定位(地图预建),SLAM 用于建图和 GPS 失效(隧道)场景,不是主定位方式。
💡 关键直觉:SLAM 边建图边定位,四模块(前端里程计/后端优化/回环/建图)。视觉+IMU(VINS)互补。自动驾驶用高精地图定位为主,SLAM 用于建图和 GPS 失效。挑战动态环境/快速运动/纹理弱。
要点串联
- SLAM:同时定位与建图。
- 四模块:前端(视觉里程计)→后端(BA 优化)→回环检测→建图。
- 系统:ORB-SLAM(特征点)、VINS(视觉+IMU)、LSD/DSO(直接法)。
- 特征点 vs 直接法:特征点稳定,直接法用全部信息受光照影响。
- VIO:视觉+IMU 融合,互补,快速运动 IMU 兜底。
- 应用:高精定位、建图、GPS 失效(隧道)、冗余。
- vs 高精地图:已知环境用高精地图定位,SLAM 用于建图和失效场景。
- 挑战:动态环境、快速运动、纹理弱、回环、实时。
第 2 章结束。下一章讲传感器与数据。
从光流到位姿估计
视觉里程计的核心是从两帧图像估计相机运动。特征点法的流程:提取关键点(ORB 角点)→ 特征描述子匹配 → 用对极几何(本质矩阵)或 PnP 求解相对位姿 → RANSAC 剔除误匹配。直接法则不走特征匹配,而是最小化两帧之间像素光度误差,能利用所有像素信息,在纹理稀疏环境更稳,但对光照和相机参数敏感。半直接法(SVO)介于两者之间。工程上 ORB-SLAM 系列的特征点方案因鲁棒性和可复现性好,被用到最多。
关键帧1, 关键帧2 -> 特征提取与匹配(ORB) -> 本质矩阵/PnP 求相对位姿 -> RANSAC 剔误匹配 -> 局部 BA: 同时优化位姿与地图点 -> 回环候选: 词袋检索 -> 位姿图优化 -> 全局一致
回环检测与高精地图定位
长时间 SLAM 会累积漂移——转了一圈,估计的位置可能偏了几米。回环检测用词袋(BoW)把帧的视觉特征聚成词汇,当前帧在词袋里检索到已访问过的关键帧,就建立回环约束,在位姿图上做全局优化,把漂移拉回来。自动驾驶实际落地时,多数场景走"高精地图定位"路线:地图在建图阶段已经做好,运行时只用视觉(或视觉加激光)与地图匹配,算出精确位姿,计算量比实时 SLAM 小得多,精度也更稳定。SLAM 的价值体现在没有地图的地方——地下车库、隧道、园区新道路,这也是"记忆泊车"这类功能的底层支撑。选择特征点法还是直接法,还要考虑算力平台:特征提取和匹配在 GPU 与 DSP 上有成熟算子,直接法虽然有更多像素信息,但迭代优化对实时算力的要求更高。多数车规级方案最终是"视觉里程计加 IMU 预积分加词袋回环"的组合,兼顾精度、鲁棒性和可部署性。