3.3 数据集与标注 (Datasets & Annotation)
3.3 数据集与标注 (Datasets & Annotation)
本节摘要:训练自动驾驶感知要数据。本节讲 KITTI、Waymo、nuScenes 等数据集和标注方法——感知模型的"粮食"。
上手前先明确
阅读完本节,你应当能够:
- 知道主流自动驾驶数据集
- 理解标注类型
- 了解标注工具和挑战
概念脉络
自动驾驶数据集
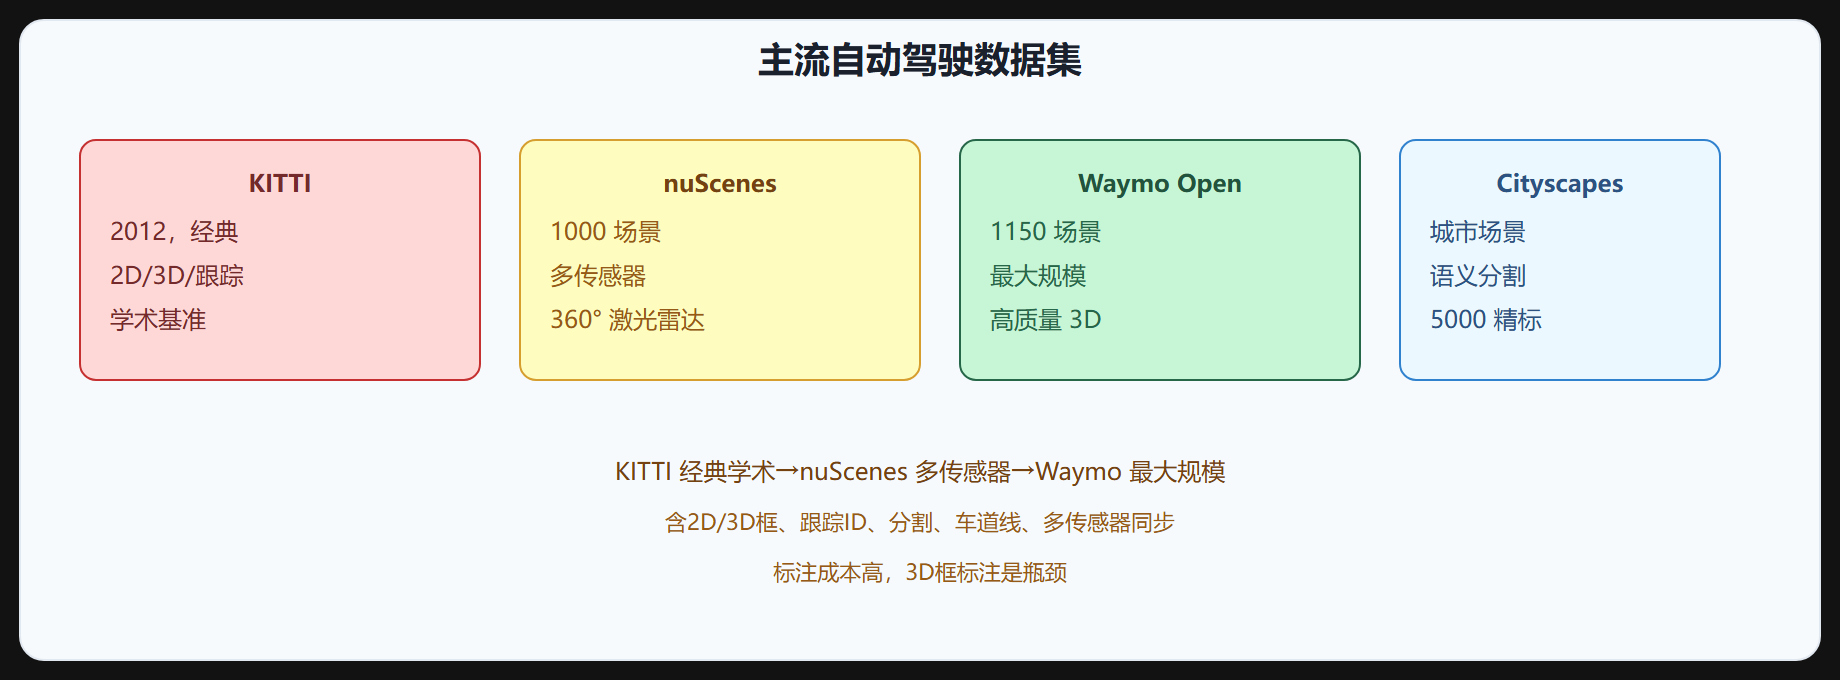
自动驾驶数据集比通用检测数据集复杂,含多传感器、3D 标注、时序。
图 3-3 主流自动驾驶数据集
| 数据集 | 特点 |
|---|---|
| KITTI | 2012 经典,学术基准 |
| nuScenes | 1000 场景,多传感器 |
| Waymo Open | 1150 场景,最大规模 |
| Cityscapes | 城市场景,语义分割 |
| Lyft Level 5 | 大规模 |
| BDD100K | 多任务,大规模 |
标注类型
自动驾驶标注比通用检测复杂:
| 标注 | 说明 |
|---|---|
| 2D 框 | 图像边界框 |
| 3D 框 | 3D 位置+尺寸+朝向 |
| 跟踪 ID | 时序关联 |
| 语义分割 | 像素级类别 |
| 实例分割 | 像素+实例 |
| 车道线 | 曲线参数 |
| 多传感器 | 同步多传感器标注 |
标注挑战
- 3D 框标注难:需在点云和图像对齐,成本高
- 时序标注:跟踪 ID 跨帧,工作量大
- 长尾场景:罕见场景标注少
- 多传感器对齐:图像、点云、雷达同步标注
- 成本:3D 标注成本是 2D 的 10 倍
标注工具
| 工具 | 特点 |
|---|---|
| CVAT | 开源在线,支持 3D |
| Scale AI | 商业,自动驾驶专用 |
| SAMA | 商业,高精度 |
| Latte | 开源 3D 标注 |
| Voxel51 | 数据管理 |
半自动标注
为降成本,用半自动标注:
- 模型预标注,人工修正
- 主动学习,选难例人工标
- 跨帧传播(标一帧,跟踪传播)
数据集使用
- 训练:用大规模数据集(Waymo/nuScenes)训练
- 基准对比:在 KITTI/nuScenes 测试集对比
- 迁移:预训练+自定义数据微调
- 仿真补充:合成数据补长尾(3.4 节)
数据隐私与合规
自动驾驶数据含行人、车牌等隐私,需:
- 人脸/车牌模糊
- 数据脱敏
- 合规存储
⚠️ 3D 标注成本:3D 框标注需在点云和图像对齐,成本是 2D 的 10 倍。用半自动标注(模型预标+人工修正)降成本。
💡 关键直觉:自动驾驶数据集含多传感器+3D+时序(KITTI/nuScenes/Waymo)。标注类型多(2D/3D/跟踪/分割/车道线)。3D 标注贵,用半自动降成本。隐私需脱敏。训练用大规模,对比用基准,仿真补长尾。
核心回顾
- 数据集:KITTI(经典)、nuScenes(多传感器)、Waymo(最大)、Cityscapes(分割)、BDD100K。
- 标注类型:2D 框、3D 框、跟踪 ID、语义/实例分割、车道线、多传感器同步。
- 挑战:3D 框标注难(点云图像对齐)、时序、长尾、多传感器对齐、成本高。
- 工具:CVAT、Scale AI、SAMA、Latte、Voxel51。
- 半自动:模型预标+人工修正、主动学习、跨帧传播,降成本。
- 使用:大规模训练、基准对比、迁移微调、仿真补充。
- 隐私:人脸/车牌模糊、脱敏、合规。
下一节讲数据增强与合成数据。
数据集的设计:规模、标注与评测协议
自动驾驶数据集的价值体现在三个维度。规模:Waymo Open 提供约 1150 个驾驶片段、数亿张图像,涵盖不同城市和天气;nuScenes 有 1000 个 20 秒片段,多传感器完整同步;KITTI 虽然只有约 1.5 万帧标注,但作为最早的基准数据集,评测协议被沿用至今。标注:3D 框要在点云和图像上同时核对,标注员先框点云再投影到图像检查边界,一帧 3D 标注的成本是 2D 的十倍量级。评测协议:数据集定义哪些类别参与评测、IoU 阈值取多少、速度与朝向误差怎么算,这些细节决定模型排名的可信度,训练团队必须严格按协议评测才能横向对比。
Waymo Open : 1150 场景 / 多城市 / 多传感器 nuScenes : 1000 场景 / 7类传感器 / NDS评分 KITTI : 经典基准 / 评测协议沿用 BDD100K : 10万帧 / 多任务标注
数据闭环与难例回流
对量产团队来说,数据集不是静态资产,而是一个闭环:路测中收集长尾案例(奇特车型、罕见天气、少见姿态)→ 筛选标注 → 加入训练集 → 迭代模型 → 再路测验证。这个"数据闭环"是模型持续进化的发动机。主动学习在其中扮演关键角色:模型在未标注数据上的置信度低或特征新颖的样本优先送标,避免为重复数据付标注费。配合仿真生成的合成数据补齐极端场景,真实数据与合成数据按比例混合训练,是当下兼顾成本与性能的标准做法。另外,隐私合规贯穿数据集全流程:人脸、车牌要模糊处理,地图数据按法规要求脱敏,原始数据存储与标注人员权限都要有审核机制。合规不是事后补救,而是在采集、标注、发布三个阶段都嵌入检查点。