4.3 循环神经网络 (RNNs) 与序列模型
4.3 循环神经网络 (RNNs) 与序列模型
本节摘要:自动驾驶要处理时序(轨迹、视频)。本节讲 RNN/LSTM/GRU 和序列模型——时序感知和预测的工具。
本节目标
阅读完本节,你应当能够:
- 理解 RNN 在时序的作用
- 知道 LSTM/GRU
- 了解在自动驾驶的应用
概念脉络
为什么需要序列模型
自动驾驶很多数据是时序:跟踪轨迹、行为预测、视频理解。RNN 专为时序设计,记忆历史信息。
RNN 基础
RNN(循环神经网络)处理序列,每步输出依赖前步:
- h_t:当前隐状态(记忆)
- x_t:当前输入
LSTM 和 GRU
图 4-3 RNN 与序列模型
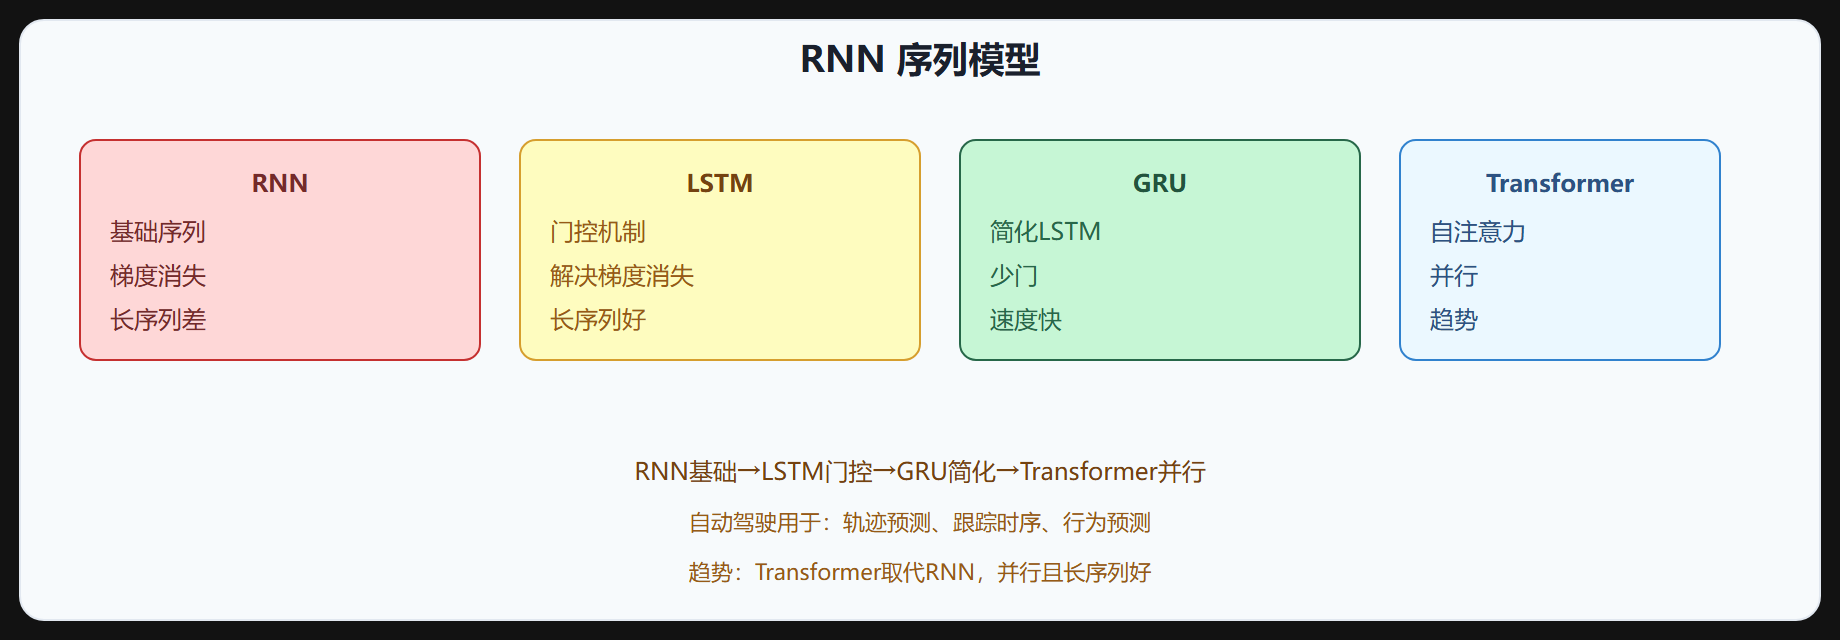
RNN 有梯度消失问题,长序列记忆差。LSTM 和 GRU 用门控解决:
LSTM
LSTM(长短期记忆)用三个门:
- 遗忘门:决定丢弃什么
- 输入门:决定存什么
- 输出门:决定输出什么
LSTM 解决梯度消失,长序列好。
GRU
GRU(门控循环单元)简化 LSTM,少一个门,速度快,效果接近。
在自动驾驶的应用
| 应用 | 说明 |
|---|---|
| 轨迹预测 | 历史轨迹推未来 |
| 多目标跟踪 | 时序关联 |
| 行为预测 | 时序行为识别 |
| 视频理解 | 时序场景理解 |
| 信号灯状态 | 时序确认状态 |
轨迹预测示例
# LSTM 轨迹预测 lstm = nn.LSTM(input_size=2, hidden_size=64, batch_first=True) # 输入历史轨迹 (batch, seq_len, 2) out, (h, c) = lstm(history_trajectory) # 预测未来轨迹 future = decoder(h) # 未来 N 步位置
RNN vs Transformer
| 维度 | RNN | Transformer |
|---|---|---|
| 并行 | 串行,慢 | 并行,快 |
| 长序列 | LSTM 较好 | 自注意力好 |
| 计算 | O(n) | O(n²) |
| 趋势 | 被 Transformer 取代 | 主流 |
Transformer 在时序任务逐渐取代 RNN(并行、长序列好)。
挑战
- 梯度消失:RNN 长 序列差(LSTM/GRU 改善)
- 串行计算:RNN 串行慢
- 长序列:超长序列仍有限
- 实时:自动驾驶要快
序列到序列
轨迹预测是序列到序列任务(历史序列→未来序列),可用 Encoder-Decoder:
- Encoder 编码历史
- Decoder 解码未来
- 注意力增强(Seq2Seq+Attention)
⚠️ RNN 被取代:Transformer 在时序任务逐渐取代 RNN(并行、长序列好)。新自动驾驶感知多用 Transformer,RNN/LSTM 仍有用但非主流。
💡 关键直觉:RNN 处理时序(轨迹/跟踪/行为预测),LSTM/GRU 门控解决梯度消失。自动驾驶用于轨迹预测、跟踪时序。趋势是 Transformer 取代 RNN(并行、长序列好)。
温故知新
- 作用:处理时序数据(轨迹、跟踪、行为)。
- RNN:基础序列,梯度消失,长序列差。
- LSTM:三门(遗忘/输入/输出),解决梯度消失。
- GRU:简化 LSTM,少门,快,效果接近。
- 应用:轨迹预测、多目标跟踪、行为预测、视频理解、信号灯时序。
- vs Transformer:RNN 串行慢,Transformer 并行快长序列好,趋势取代。
- 挑战:梯度消失、串行、长序列、实时。
- Seq2Seq:轨迹预测是序列到序列,Encoder-Decoder+注意力。
下一节讲 GAN。
RNN 的前向计算与门控设计
RNN 每步计算 ht = tanh(W·[ht-1, xt] + b),把上一时刻的隐藏状态和当前输入一起"折叠"进新的隐藏状态。理论上 RNN 能记住任意长的历史,但实际训练时,梯度沿时间反向传播会连乘很多次权重矩阵,导致梯度指数级缩小(梯度消失)或爆炸(梯度爆炸)。LSTM 用三个门把"记忆"和"输入输出"分开:遗忘门决定旧记忆保留多少,输入门决定新信息写入多少,输出门决定当前输出多少。记忆通过细胞状态以逐元素相加的方式传递,梯度可以直接沿这条"直线"回流,从而缓解消失问题。GRU 把输入门和遗忘门合并成更新门,参数更少、训练更快。
# LSTM 前向(简化) f = sigmoid(Wf @ [h_prev, x]) # 遗忘门 i = sigmoid(Wi @ [h_prev, x]) # 输入门 c = f * c_prev + i * tanh(Wc @ [h_prev, x]) o = sigmoid(Wo @ [h_prev, x]) h = o * tanh(c)
序列模型在自动驾驶里的定位
虽然 Transformer 在时序任务上逐渐成为主流,RNN 与 LSTM 仍有一席之地:一是轻量——LSTM 单步计算简单,适合 10Hz 的预测模块;二是增量推理——RNN 天然按时间步推进,不需要像 Transformer 那样缓存整段历史;三是和检测器解耦方便,老代码栈迁移成本低。实际落地时,轨迹预测模块常把 LSTM 输出与车道线特征拼接后接一个 MLP 输出未来轨迹,这个简单结构在不少量产方案里依然可靠。训练上要注意时序数据的分段(按场景切段而不是随机切片)、标签的归一化(用相对坐标而不是绝对坐标),以及多步递推预测时的误差累积处理。对 RNN 类模型,推理时的长度泛化也是个坑:训练时序列长度固定,部署时历史轨迹长短不一。常见做法是把输入轨迹固定到最近 30 步,不足的补零并给 mask,超过的截断,保证推理与训练分布一致。
补充一个评价视角:判断一个时序任务该用 RNN 还是 Transformer,先看序列长度和实时性要求。轨迹预测的输入序列通常只有 10-30 步,LSTM 完全够用且延迟低;而 BEV 感知要同时建模多帧多视角的时空关系,序列长、结构复杂,Transformer 更合适。另一个实用角度是推理硬件:RNN 的串行依赖在 GPU 上并行度低,但在 CPU 或 NPU 上跑起来反而简单;Transformer 的矩阵乘法天然并行,更适合 GPU 架构。选型时把"序列结构、实时性、硬件架构"三件事一起摆上桌,结论通常就清楚了。