4.2 Transformer 模型及其应用
4.2 Transformer 模型及其应用
本节摘要:Transformer 从 NLP 走进 CV,改变自动驾驶感知。本节讲 Transformer 在感知的应用——BEV、DETR、时序预测的新范式。
学习目标
阅读完本节,你应当能够:
- 理解 Transformer 在 CV 的优势
- 知道 BEV 和 DETR
- 了解在自动驾驶的应用
概念脉络
Transformer 在 CV 的兴起
Transformer 原为 NLP 设计,ViT(Vision Transformer)证明在 CV 有效。Transformer 的自注意力能建模全局依赖,弥补 CNN 局部的局限,在自动驾驶感知兴起。
Transformer 的优势
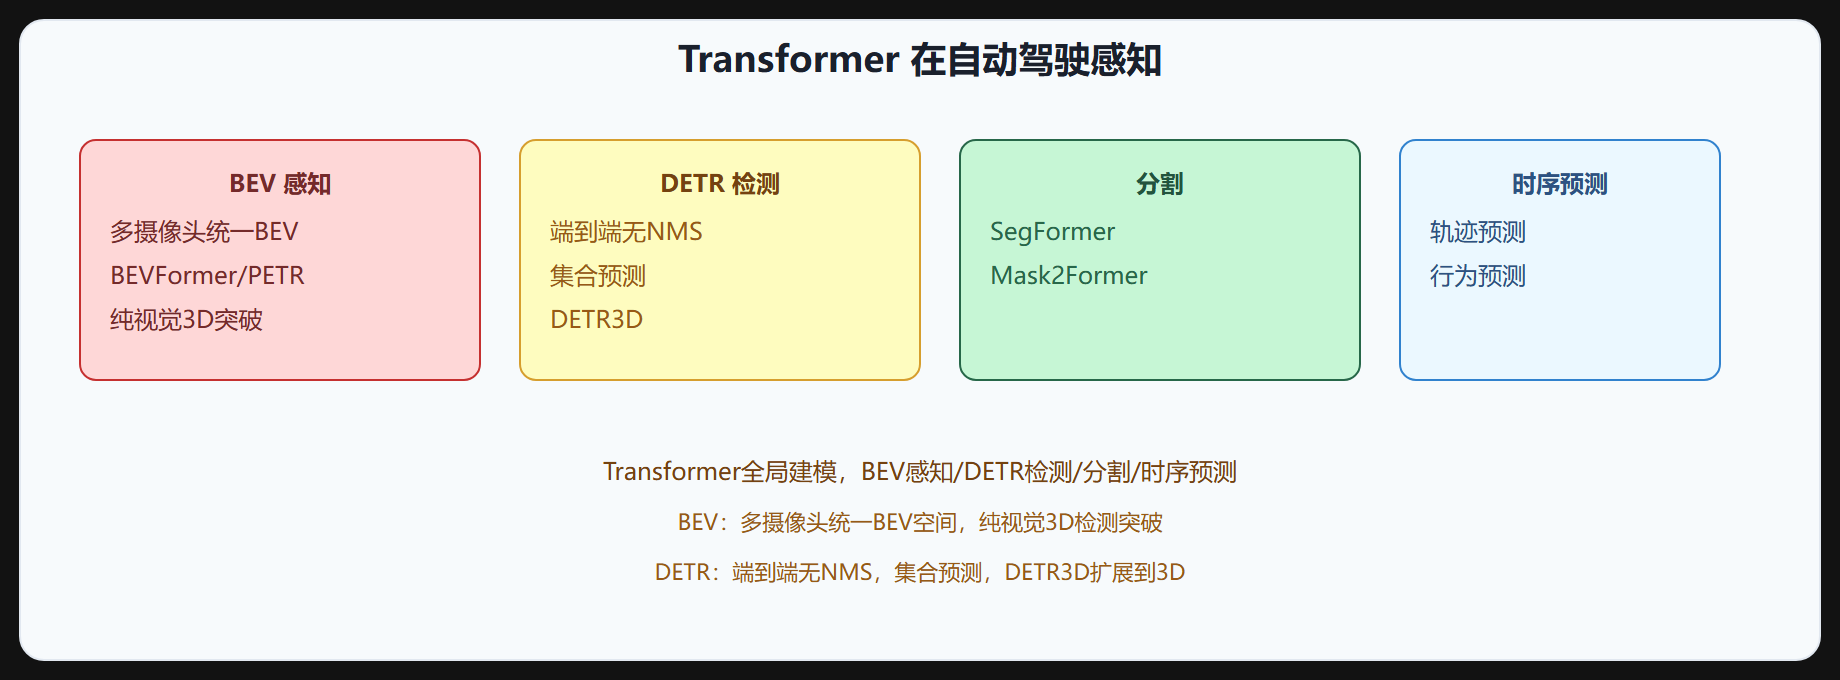
图 4-2 Transformer 在自动驾驶
- 全局建模:自注意力看全图,长距离依赖强
- 灵活:处理多模态、多视角、时序
- 端到端:DETR 无 NMS
BEV 感知(最重要)
BEV(鸟瞰图)感知是 Transformer 在自动驾驶的最大应用:
- 多摄像头特征用 Transformer 采到 BEV 空间
- 在 BEV 做 3D 检测/分割
- 类似激光雷达视角,纯视觉 3D 突破
代表:
- BEVFormer:时序 BEV,多摄像头 3D 检测
- PETR/PETRv2:位置嵌入变换
- BEVDet:BEV 检测
DETR 检测
DETR 用 Transformer 做端到端检测:
- 无锚点、无 NMS
- 集合预测(匈牙利匹配)
- 全局注意力直接预测框
DETR3D 扩展到 3D,多摄像头 3D 检测。
分割
- SegFormer:Transformer 分割,轻量高效
- Mask2Former:统一分割框架
时序预测
Transformer 处理时序,用于轨迹和行为预测:
- 自注意力建模时序依赖
- 多模态预测(多种可能轨迹)
ViT 骨干
ViT(Vision Transformer)作为骨干:
- 图像分 patch,Transformer 编码
- 全局建模强
- 大数据预训练效果好
挑战
- 计算量大:注意力 O(n²),高分辨率重
- 数据需求大:需大数据预训练
- 部署难:注意力算子在硬件加速难
CNN + Transformer 融合
实际常融合 CNN 和 Transformer:
- CNN 提局部特征
- Transformer 建模全局
- 兼顾效率和效果
⚠️ Transformer 计算量大:自注意力 O(n²),高分辨率计算爆炸。用窗口注意力(Swin)、降采样 patch 减计算。
💡 关键直觉:Transformer 全局建模,在自动驾驶用于 BEV 感知(多摄像头统一 BEV,纯视觉 3D 突破)、DETR(端到端无 NMS)、分割、时序预测。挑战计算量大,常与 CNN 融合。BEV 是最大应用。
要点串联
- 兴起:ViT 证明 Transformer 在 CV 有效,全局建模优势。
- 优势:全局建模、灵活(多模态/视角/时序)、端到端。
- BEV 感知:多摄像头统一 BEV,纯视觉 3D 突破(BEVFormer/PETR/BEVDet),最重要应用。
- DETR:端到端无 NMS,集合预测,DETR3D 扩展 3D。
- 分割:SegFormer、Mask2Former。
- 时序预测:轨迹和行为预测,多模态。
- ViT 骨干:patch+Transformer,全局强,需大数据。
- 挑战:计算量 O(n²)、数据需求大、部署难。
- 融合:CNN 局部+Transformer 全局,兼顾效率效果。
下一节讲 RNN。
自注意力与 BEV 查询的机制
Transformer 的核心是自注意力:每个 token(图像 patch、BEV 网格、物体查询)都与其他所有 token 计算相关性并加权聚合。这让模型能直接建模"远处的小车"与"近处的卡车"的关系,而不是像 CNN 那样靠层数堆叠去扩大感受野。BEV 感知就是把"BEV 网格上的每个查询"看作一个 token,让每个查询去图像特征里"采"内容——先通过相机参数把查询投影到各相机的图像位置,再采样对应特征,最后经过注意力聚合。这条"查询、采样、聚合"的链路,就是 BEVFormer 等模型能跨视角统一特征的原因。
BEV网格查询(200x200) -> 投影到 N 路相机的图像坐标 -> 采样图像特征(可变形注意力) -> 跨相机聚合 -> BEV 特征 -> 检测/分割头
计算优化:窗口、稀疏与线性注意力
注意力 O(n²) 的复杂度在图像上很快失控——一张 224×224 的图像切 patch 后有 196 个 token 还好,BEV 的 200×200 网格直接查询全部 token 会爆炸。工业界的对策有三类:窗口注意力(Swin)把注意力限制在局部窗口内,计算量与图像大小近似线性;可变形注意力(Deformable DETR)只让查询关注少量采样点而非全图;线性注意力用核技巧把 O(n²) 降到 O(n)。这些优化让 Transformer 在算力有限的车载平台上变得可用。目前量产感知的趋势是"CNN 提局部特征加 Transformer 做跨视角与时序建模"的混合结构,在效果和算力之间取得平衡。Transformer 还有一个工程优势:天然适合多模态输入。查询机制可以把文本(交通指令)、时序(历史帧)、几何(点云)都转成 token 参与注意力,这让"多传感器加时序加地图先验"的统一建模变得自然,也是端到端感知架构普遍采用 Transformer 的原因。
补充一个数据层面的观察:Transformer 相比 CNN 通常需要更大的训练数据和更长的训练周期才能发挥优势,小数据下反而不如 CNN 稳。量产团队的做法通常是先在仿真或大规模无监督数据上预训练,再在真实标注数据上微调。这个"预训练加微调"的范式,让 Transformer 在标注成本昂贵的自动驾驶领域也能落地,也是它和迁移学习(4.5 节)天然衔接的原因。理解这一点,就理解了为什么很多新模型论文都强调预训练数据的规模。