4.5 领域适应与迁移学习
4.5 领域适应与迁移学习
本节摘要:自动驾驶场景多变,模型要适应新场景。本节讲迁移学习和领域适应——让模型在新数据/新场景上也好用。
阅读收获
阅读完本节,你应当能够:
- 理解迁移学习的价值
- 知道领域适应方法
- 了解在自动驾驶的应用
概念脉络
为什么需要迁移学习
自动驾驶场景多变:不同城市、天气、车型。在 A 城训练的模型到 B 城可能掉点。迁移学习让模型适应新场景,减少重新标注训练成本。
迁移学习
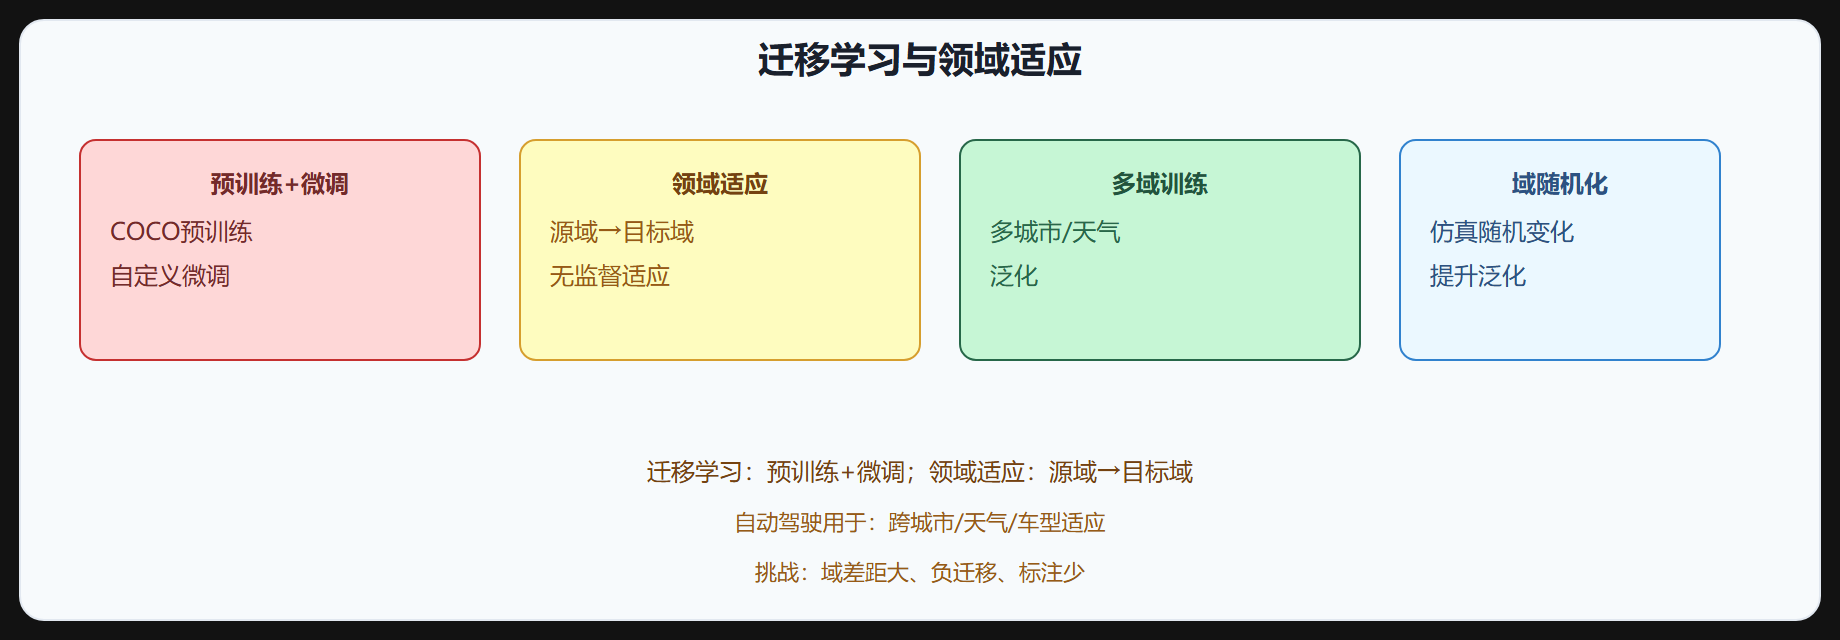
图 4-5 迁移学习与领域适应
迁移学习最常用形式:
- 预训练:在大数据集(COCO、ImageNet)训练
- 微调:在自定义数据集微调
# 加载 COCO 预训练 YOLOv5,微调 model = torch.hub.load('ultralytics/yolov5', 'yolov5s', pretrained=True) model.train(data='custom_city.yaml', epochs=100)
迁移学习让小数据集也能训出好模型。
领域适应(Domain Adaptation)
领域适应是迁移学习特例,源域和目标域分布不同:
- 源域:有标注(如 A 城)
- 目标域:无或少标注(如 B 城)
- 目标:让源域训练的模型在目标域也好
方法
- 对抗领域适应:学域不变特征(DANN)
- 自训练:源域模型在目标域伪标注,迭代
- 风格转换:用 GAN 把源域转目标域风格
在自动驾驶的应用
| 场景 | 说明 |
|---|---|
| 跨城市 | A 城模型适应 B 城 |
| 跨天气 | 晴天模型适应雨雪 |
| 跨车型 | 不同车型摄像头 |
| Sim2Real | 仿真模型适应真实 |
| 跨国家 | 左舵→右舵 |
多域训练
直接在多域数据训练,提升泛化:
- 多城市数据混合训练
- 多天气数据训练
- 模型见多场景,泛化好
域随机化
仿真训练时大量随机变化:
- 随机光照、天气、纹理
- 随机目标位置、数量
- 提升对真实变化的泛化
挑战
- 域差距大:源目标差异大,适应难
- 负迁移:迁移可能让性能下降
- 标注少:目标域标注少
- 评估:目标域无标注难评估
自监督学习
自监督(如 MoCo、SimCLR)用无标注数据预训练,减少对标注依赖,是迁移学习新趋势。
⚠️ 负迁移:源域和目标域差异大时,迁移可能让性能下降(负迁移)。要评估迁移效果,必要时从零训练。
💡 关键直觉:迁移学习预训练+微调,让小数据训好。领域适应源域→目标域(跨城市/天气/Sim2Real)。多域训练和域随机化提升泛化。挑战域差距/负迁移/标注少。自监督是新趋势。
一节小结
- 迁移学习:预训练(COCO/ImageNet)+微调(自定义),小数据训好。
- 领域适应:源域有标注→目标域无/少标注,对抗/自训练/风格转换。
- 应用:跨城市、跨天气、跨车型、Sim2Real、跨国家。
- 多域训练:多城市/天气混合训练,泛化好。
- 域随机化:仿真随机变化,提升泛化。
- 挑战:域差距大、负迁移、标注少、评估难。
- 自监督:MoCo/SimCLR 无标注预训练,新趋势。
下一节讲轻量化。
微调策略与灾难性遗忘
迁移学习落地最常踩的坑是"微调过头"。在源域(如 COCO)预训练后,直接用小学习率微调全模型通常效果不错,但如果目标域数据很少,微调时间过长,模型会遗忘源域学到的通用特征,这叫灾难性遗忘。常用对策:一是冻结骨干、只训练任务头(线性探测),适用于目标域极小的情况;二是分阶段微调——先冻结骨干训练新头,再解冻骨干小学习率整体微调;三是加正则约束权重不要偏离预训练值太远。实际经验是"学习率比预训练低一到两个数量级,微调轮数宁少勿多"。
策略1 冻结骨干: 骨干(冻结) + 任务头(训练) -> 数据极少时 策略2 两阶段: 先训头 -> 再整体微调(低LR) -> 数据适中 策略3 约束微调: 损失加 ||W - W_pretrain|| -> 防遗忘
对抗域适应与自训练
当目标域连标注都没有时,就要做无监督域适应。对抗域适应(DANN)的思路是:让特征提取器既骗过"域判别器"(分不清特征来自源域还是目标域),又让分类器在源域上分类正确,这样学到的特征就是"域不变"的——分类器就能直接用在目标域。自训练则走"伪标签"路线:源域模型先在目标域上预测,高置信度的预测当作伪标签,混合真实源域数据迭代再训练,逐步把目标域分布"拉"进模型。两者各有短板:对抗方法对域差距大的场景不稳定,自训练对伪标签噪声敏感,需要配合置信度过滤和类别均衡策略。跨城市、跨天气、Sim2Real 这类场景,往往要组合多种域适应手段并配合数据增强,才能把性能差距压到可接受范围。