4.6 轻量化与模型压缩
4.6 轻量化与模型压缩
本节摘要:自动驾驶算力有限,模型要轻。本节讲轻量化设计和模型压缩——让感知模型在车载设备跑得快。
先说结论
阅读完本节,你应当能够:
- 知道轻量化网络设计
- 理解剪枝和蒸馏
- 了解在自动驾驶的应用
概念脉络
为什么需要轻量化
自动驾驶车载算力有限(如 NVIDIA Orin 200TOPS),但感知要实时(30Hz)。大模型跑不动,要轻量化和压缩。
轻量化网络设计
图 4-6 轻量化与压缩
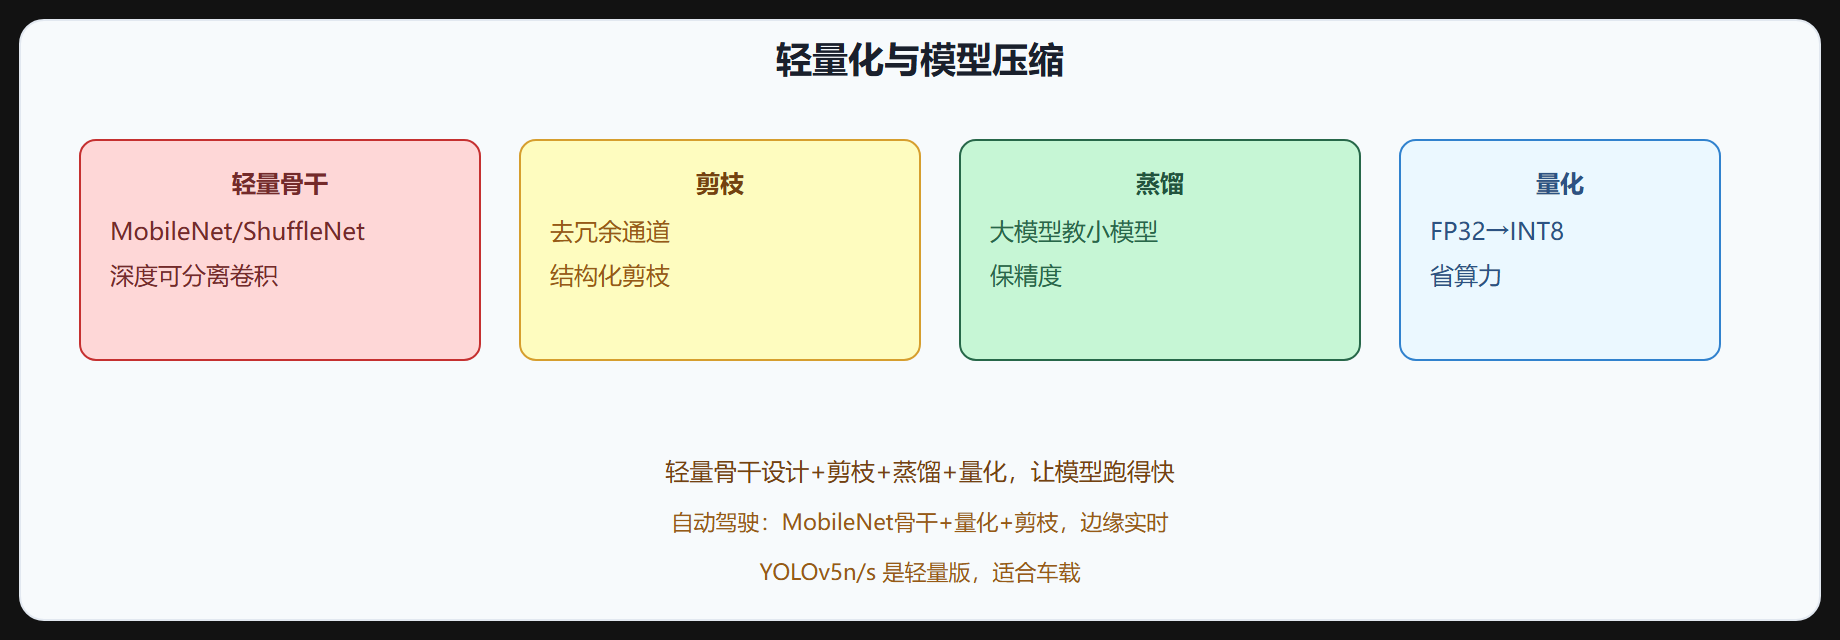
设计轻量网络:
| 网络 | 技术 |
|---|---|
| MobileNet | 深度可分离卷积 |
| ShuffleNet | 通道洗牌 |
| GhostNet | 廉价特征生成 |
| SqueezeNet | 1x1 卷积压缩 |
| EfficientNet-Lite | 轻量 EfficientNet |
模型剪枝
剪枝去掉冗余参数:
- 非结构化剪枝:去单个权重,稀疏但硬件难加速
- 结构化剪枝:去整个通道/层,硬件友好,常用
剪枝后微调恢复精度。
知识蒸馏
蒸馏用大模型(教师)指导小模型(学生):
- 教师软标签 + 真实硬标签
- 学生学教师输出分布
- 小模型接近大模型精度
loss = α * soft_loss(student, teacher) + (1-α) * hard_loss(student, labels)
量化(详见 4.7)
量化把 FP32 降到 INT8/FP16,省算力,4.7 节详述。
轻量化检测器
自动驾驶用轻量检测器:
- YOLOv5n/s:轻量版,车载实时
- YOLOv6:工业部署优化
- PP-YOLOE:百度轻量
- NanoDet:超轻量
NAS 自动搜索
神经架构搜索(NAS)自动找轻量高效结构:
- EfficientNet(NAS 缩放)
- MobileNetV3(NAS)
部署优化组合
实际部署常组合多种技术:
- 轻量骨干(MobileNet)
- 蒸馏(大模型教小模型)
- 剪枝(去冗余)
- 量化(INT8)
- TensorRT 加速
挑战
- 精度损失:轻量化可能掉精度
- 硬件适配:不同芯片优化不同
- 训练复杂:蒸馏/剪枝流程复杂
车载硬件
| 硬件 | 算力 |
|---|---|
| NVIDIA Orin | 200 TOPS |
| 地平线 J5 | 128 TOPS |
| 华为 MDC | 算力档位 |
| Tesla FSD | 自研 |
⚠️ 精度损失:轻量化可能掉几个 mAP,关键场景用蒸馏+QAT 保精度,或用稍大模型(YOLOv5m)。
💡 关键直觉:自动驾驶算力有限,要轻量化。轻量骨干(MobileNet/ShuffleNet)+剪枝(去冗余)+蒸馏(大教小)+量化(INT8)+TensorRT。YOLOv5n/s 是车载轻量版。组合多种技术部署。
核心回顾
- 需求:车载算力有限,感知要实时,需轻量化。
- 轻量骨干:MobileNet(深度可分离)、ShuffleNet(通道洗牌)、GhostNet、EfficientNet-Lite。
- 剪枝:结构化剪枝去冗余通道,硬件友好,剪后微调。
- 蒸馏:教师软标签+硬标签指导学生,小模型接近大模型。
- 量化:FP32→INT8,4.7 节详述。
- 轻量检测器:YOLOv5n/s、YOLOv6、PP-YOLOE、NanoDet。
- NAS:自动搜索轻量结构(EfficientNet/MobileNetV3)。
- 组合:轻量骨干+蒸馏+剪枝+量化+TensorRT。
- 硬件:NVIDIA Orin/地平线 J5/华为 MDC/Tesla FSD。
下一节讲量化与部署。
结构化剪枝的完整流程
结构化剪枝的目标是去掉冗余通道,让模型变窄。流程通常是:训练好基线模型 → 评估每个通道的重要性(常见指标有通道权重范数、输出激活贡献、BN 缩放因子 gamma 的大小)→ 剪掉不重要的通道 → 微调恢复精度 → 重复迭代。BN 的 gamma 作为剪枝指标很流行:gamma 小的通道对输出贡献弱,可以直接裁掉,训练时可以在损失里加一个对 gamma 的稀疏正则,让"冗余通道"自然暴露出来。
训练基线 -> 通道重要性评估(权重范数/BN gamma) -> 剪枝(去掉低贡献通道) -> 微调(恢复精度) -> 转 INT8 量化 + TensorRT
知识蒸馏:从教师到学生
蒸馏的本质是"软标签比硬标签信息更多"。教师模型的概率分布里,不仅"这是轿车"是正确的,还隐含了"这有点像 SUV"这样的相似性信息。学生模型用 KL 散度逼近教师的软输出,同时用交叉熵学真实标签,就能在远小于教师模型的容量下逼近教师精度。温度 T 控制软标签的"软度"——T 越高分布越平滑,越能暴露类间关系。工程上学生一般用轻量骨干,教师用大模型或集成模型,蒸馏数据既可以用训练集,也可以用大规模未标注数据(教师预测伪标签给学生学),后者能显著提升学生模型在长尾分布上的表现。最后提醒一个组合陷阱:剪枝和量化叠加可能造成精度损失的复合放大。合理的顺序是先做蒸馏得到小模型,再剪枝微调,最后量化(最好量化感知训练 QAT),每一步都用评测集把关。把"轻量设计、蒸馏、剪枝、量化"当成一条流水线而非孤立技巧,是量产部署里更稳妥的做法。
补充一个关于收益预期的常识:压缩手段的收益是递减的。从零开始做轻量设计往往能获得最大的算力下降(数倍量级),蒸馏次之,剪枝和量化通常各带来 20% 到 50% 的收益。因此工程上推荐"先设计轻量骨架,再叠加压缩"的顺序,而不是在重模型上硬压——后者的精度损失曲线更陡,调优代价更高。还有一个常被忽略的点:压缩后的模型要重新过一遍校准集和评测协议,指标波动超过阈值就得回退,压缩不是一次性动作,而是带着评测门槛的持续迭代。