4.7 模型量化与部署
4.7 模型量化与部署
本节摘要:训练好的模型要部署到车。本节讲量化和端到端部署——让感知模型在车载硬件实时运行。
核心问题
阅读完本节,你应当能够:
- 理解量化原理和类型
- 知道部署流程
- 了解车载部署优化
概念脉络
模型量化
量化把 FP32 权重降到低精度,省算力和内存:
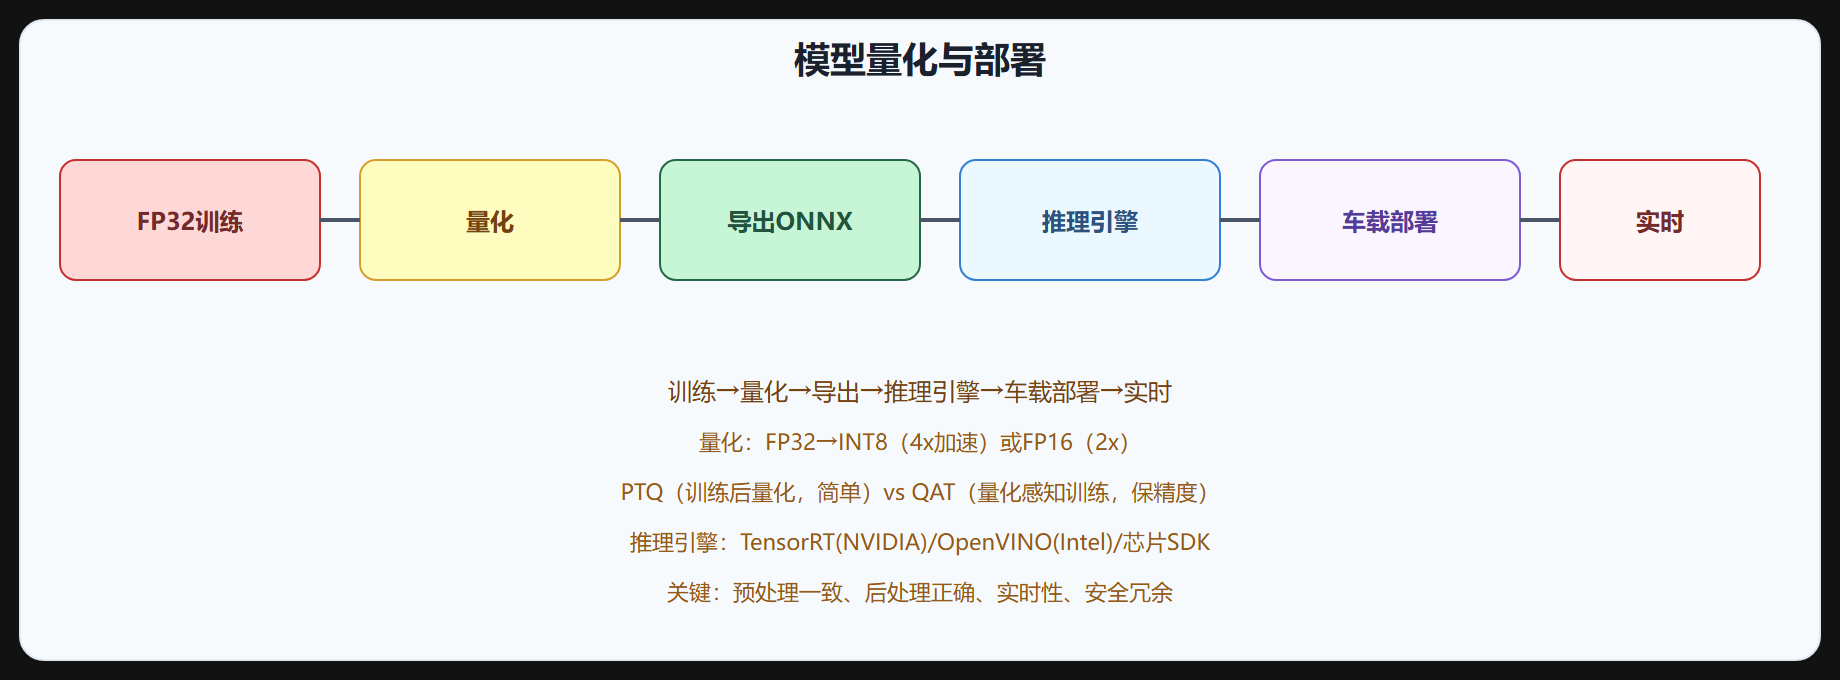
图 4-7 量化与部署
| 精度 | 加速 | 精度损失 |
|---|---|---|
| FP32 | 1x | 无 |
| FP16 | 2x | 极小 |
| INT8 | 4x | 小(QAT 可控) |
| INT4 | 8x | 明显 |
量化类型
- 训练后量化(PTQ):训练完直接量化,简单,精度略降
- 量化感知训练(QAT):训练时模拟量化,精度保持好
# PyTorch QAT model.qconfig = torch.quantization.get_default_qconfig('fbgemm') model = torch.quantization.prepare_qat(model) # 训练后转换 model = torch.quantization.convert(model)
端到端部署流程
- 训练:FP32 训练高精度模型
- 量化:PTQ 或 QAT 转 INT8
- 导出:转 ONNX 中间格式
- 推理引擎:TensorRT/OpenVINO/芯片 SDK 优化
- 车载部署:集成到感知系统
- 实时推理:30Hz 运行
推理引擎
| 引擎 | 平台 |
|---|---|
| TensorRT | NVIDIA GPU |
| OpenVINO | Intel CPU |
| ONNX Runtime | 跨平台 |
| 芯片 SDK | 地平线/华为/特斯拉自研 |
车载部署特殊性
自动驾驶部署比通用部署严:
- 实时性:30Hz+,延迟 <33ms
- 安全冗余:多模型冗余,ASIL 安全等级
- 车规级:温度、振动、寿命要求
- OTA 更新:远程模型更新
- 监控:运行状态监控
部署优化
- 层融合:合并连续层
- 内核自动调优:TensorRT 自动选最优内核
- 内存优化:减少内存拷贝
- 流水线:多任务并行流水
部署注意事项
- 预处理一致:部署预处理和训练严格一致(归一化、resize)
- 后处理正确:NMS、框解码实现正确
- 版本管理:模型版本化,灰度发布
- A/B 测试:新模型对比验证
- 回滚机制:出问题能回滚
BEV 模型部署挑战
BEV 模型(Transformer)部署比 CNN 难:
- 注意力算子在硬件加速难
- 内存占用大
- 需专用优化
端到端 vs 模块化部署
| 部署 | 特点 |
|---|---|
| 模块化 | 各任务独立部署,可解释 |
| 端到端 | 图像直接到控制,黑盒 |
自动驾驶多用模块化部署(可调试、安全)。
⚠️ 预处理一致:部署预处理和训练不一致是部署最常见 bug(归一化值不同,精度暴跌)。必须严格一致。
💡 关键直觉:量化 FP32→INT8(4x 加速),PTQ 简单、QAT 保精度。部署流程:训练→量化→导出 ONNX→推理引擎→车载。车载部署严(实时/安全冗余/车规/OTA)。预处理一致是关键。
本节速览
- 量化:FP32→FP16(2x)/INT8(4x)/INT4(8x),省算力。
- 类型:PTQ(训练后,简单)、QAT(量化感知,保精度)。
- 部署流程:训练→量化→导出 ONNX→推理引擎→车载→实时。
- 推理引擎:TensorRT(NVIDIA)、OpenVINO(Intel)、ONNX Runtime、芯片 SDK。
- 车载特殊性:实时 30Hz、安全冗余、车规级、OTA、监控。
- 优化:层融合、内核调优、内存优化、流水线。
- 注意:预处理一致、后处理正确、版本管理、A/B 测试、回滚。
- BEV 部署:Transformer 注意力算子加速难,需专用优化。
- 模块化 vs 端到端:模块化可调试安全,主流。
第 4 章结束。本教程全部完成。
量化的原理与精度控制
FP32 模型在硬件上做 32 位浮点乘加,INT8 量化把权重和激活都映射到 8 位整数,单个算子的计算量降到约四分之一,内存占用也同步下降。量化的关键是找到合适的缩放因子 scale = (max - min) / 255,把浮点范围映射到负 128 到 127。误差主要来自两部分:一是权重和激活的分布不是均匀的,极端值会把范围拉大,导致大部分数值落在低精度区间——用 KL 散度(校准集上最小化量化前后分布的差异)选截断阈值可以缓解;二是敏感算子(如注意力里的 softmax、归一化层)不适合量化,需要保留 FP16 或 FP32。
# 校准:用校准集统计激活分布,选量化阈值 calibrator = Calibrator(calib_data) model = prepare(model, calibrator) # 插入量化节点 calibrator.collect(model) # 跑校准集 scale = calibrator.compute_scale() # KL/最大绝对值法
PTQ 与 QAT 的选择
训练后量化(PTQ)最简单:训练完直接转换,跑一小段校准集统计分布,一般能保住大部分精度,但对分布敏感的任务可能掉点。量化感知训练(QAT)在训练阶段就模拟量化噪声——前向用量化后的权重和激活,反向仍然用浮点,让网络"适应"量化误差,精度最好,但训练成本高、流程复杂。实际量产常走"先 PTQ 试跑,掉点多再升级 QAT"。部署时还要注意推理引擎的算子支持:TensorRT、OpenVINO、地平线或华为的芯片 SDK 各有各的算子库,模型里不支持的算子会被拆成慢路径,性能可能打回原形。因此从模型设计阶段就要考虑算子友好性,比如避免某些自定义层,这也是"设计时就要想到部署"的最直接体现。