2.1 声学模型的作用与目标
2.1 声学模型的作用与目标
声学模型是 ASR 的耳朵,它的唯一职责是回答"这段声音更像在念哪个音素状态"。它的输入是一串一帧一帧的声学特征向量,输出是每一帧在全部建模单元上的概率分布。本节先把输入输出、单位、以及"为何要对状态打分而不是对词打分"讲清楚,为全章定调。
学习目标
- 能说出声学模型的输入是特征帧序列、输出是建模单元的概率分布。
- 能解释为什么声学模型一般不对词、而对比词更小的音素状态打分。
- 能说明 HMM 状态、音素、词在发音词典帮助下如何串成一条链。
- 能理解特征设计的两难:如何在国内信息与噪声之间取舍。
一、先定准口径:模型收到的和吐出的
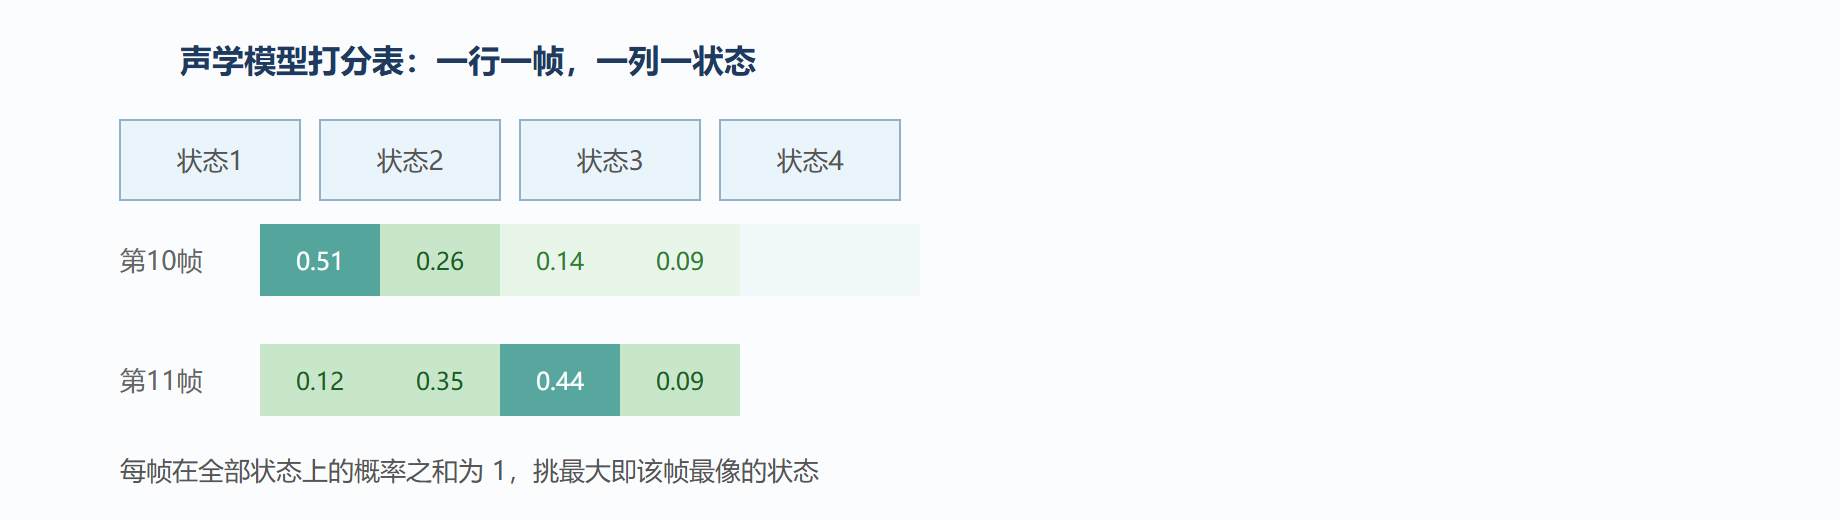
很多竞赛排名会让人误以为声学模型直接输出文字。实际上传统声学模型的输入是一个特征帧序列,例如一秒钟里的 100 帧,每帧一个几十维的 MFCC 向量;输出则是每一帧在众多建模单元上的一个概率分布,比如第 13 帧属于"音素 /a/ 的第二状态"、属于"音素 /i/ 的第一状态"等等各得多少分。把它叫"打分"更直白:这帧声音更像哪个音素状态,就给哪个状态更高的分。
这条口径有两个要紧的后果。其一,声学模型的输出严格说来是一张按时间排列的打分表,不是一句话;是后续的搜索环节拿这张表去拼句子。其二,它比"直接出词"多了无数组合可能,把折腾留给了后端的解码器。理解了输入输出,就理解了为什么新手常把"识别错"归功于"声学模型差"——其实很多时候是打分表本身没错,是后续拼接出了问题。
二、为什么对"状态"打分,而不是对词
直接对词打分省事,可词的数量是几十万个,仅靠声音把词抠出来几乎不可能:同音词、连读、口音都会让同一个词的声音五花八门。于是工程界退而求其次,先对比词更小的单位打分。音素是语言的基元,汉语大约几十个声母加韵母的组合,量级远比词小;而一个音素还会再细分成几个 HMM 状态,用来刻画它从开始到结束的过渡。
于是形成三层堆叠:发音词典把词写成音素串,音素再拆成若干 HMM 状态,声学模型精确地对状态打分,再顺着这条链层层还原到词。状态这一层的存在,起初是为了让时序建模有足够的分辨率;三音素(考虑前后邻居约束的三元组)则进一步解决了同音素在不同上下文里发音不同的问题。这些我们放到 2.4 细讲,这里只需建立"声学模型对状态打分"的正确心智。
三、特征设计的两难
声学模型能美美地打分,前提是喂进去的特征足够"扎手":要让不同音素的特征尽量分开,又不能让同音素因说话人差异散得太开。这其实是个账号统一与区分并存的平衡——提高区分度,常见搭配会让同音素被误判;强调鲁棒性,又会把该有的差别也抹平。第 2.3 节讲的梅尔标度、倒谱均值归一化,本质上都是在这两端之间找平衡。理解了这个两难,很多"为什么特征要这么折腾"的困惑会自行消失。
声学模型打分表示意
四、拿一个音素把账算明白
空谈打分容易飘,用一个具体的音素走一遍就有手感。说"ba",爆破音声门一开、气流冲出,尾随元音再过渡。把它切成几个 HMM 状态,常用的是左中右三个:一个管起声(爆破开到元音还没成型)、一个管中段(元音最稳的当口)、一个管收声(滑向下一个音素)。声学模型对每一帧说的话,就是这样一张表:这一帧更像"ba"的起声状态、中段状态,还是更像"ma"的中间状态……每个候选状态占一列,每过一帧填一行。
于是整段"ba"会走出一条从左到右穿过状态的概率轨迹,波形上每帧取当前最可能的那个状态,串起来就是这条音素的"最可能走法"。
五、两套口径,工程里别混着说
同样是"声学模型",在训练和推理两头的口径并不一样,混着说会上当。训练时往往把"这一帧到底属于哪个状态"当成标签来监督;推理时才真正把它当"在所有状态上的分布"来打分。下面这张表把两边摆平:
| 环节 | 手里拿着 | 问的是 | 用的对象 |
|---|---|---|---|
| 训练 | 知道句子说什么 | 这一帧该算哪个状态 | 求最可能的对齐 |
| 推理 | 只有声音 | 在候选状态上怎么分布 | 给它打分再交给解码 |
| 评测 | 标注好的答案 | 我说的状态对不对 | 状态正确率、音素错误率 |
理解了这两套口径,后面读训练和评估的章节(2.7、2.8)就顺手了。所谓"声学模型好/坏",其实可以精确地说成:它在推理时把打分表排对没有,以及在训练时有没有被对齐带偏。
六、一张打分表能读出什么
打分表不是终点,而是给下一道工序看的"线索板"。仍拿"ba"这句说,若你拿到一帧的分布,最自然的读法是"这一帧落在哪个状态分最高"——那多半是起声、中段、收声里该走的位置。可真正高价值的读法不止于此:要比较"有没有第二名咬得很紧"。设某帧对"ba 中段"给 0.5、对"ma 中段"给 0.48,两者只差 0.02——这说明声学上这段话正处在"b"和"m"两个音素都说得通的地带;此时谁胜出,绝不取决于声学模型本身,而取决于第 4 章里语言模型与解码器怎么裁决。相反,若某帧 0.9 对 0.05 一脸笃定,说明声学上毫无悬念,任谁调 λ 都翻不了案。
看懂"分明"与"胶着"两种行,就把声学模型的价值读对了:它真正的本事不是替所有问题拍板,而是诚实地告诉下游"这一帧我有多大把握"。把握大的地方少折腾,把握小的地方留给语言与解码去救。这一层读法,会让我在第 4、5 章做排错时比别人多一双眼睛,也让你明白为什么后面的章节总在强调"要分辨是耳朵听岔了,还是本该听岔、靠别处救"。
这一读法还能反过来用来体检:当你怀疑声学模型本身不行时,别急着重训,先翻一翻"胶着行"占整张表多大比例。若胶着行占了绝大多数,说明特征根本没把音素分开,问题多半出在第 2.2、2.3 节的特征链上;若只是个别口音、个别连读被胶着,那多是数据覆盖不全。把"分明度"当成声学模型的体检指标,能帮你省掉大量靠感觉乱调重训的时间——也正好接上 2.8 节要讲的评估指标。
本节要点回顾
- 输入输出:特征帧序列进,音素状态概率分布出。
- 打分层级:对状态打分,状态拼成音素,音素经词典拼成词。
- 三层堆叠:词典负责词到音素,音素到 HMM 状态,状态是打分的基本单位。
- 为什么不做直接出词:词集合太大,同音与连读使纯声音分不清。
- 特征两难:区分同素与鲁棒不兼容,须靠特征工程在两端平衡。
下一节开始亲手走一帧:采样、预加重、分帧、加窗,把原始波形切成一列可计算的小段。