2.2 语音信号处理与特征提取
2.2 语音信号处理与特征提取
声学模型对着一串数字特征打分,可这些数字不会从天上掉下来。把一段波形切成能喂模型的帧,需要先经历数字化、预加重、分帧、加窗、傅里叶变换到功率谱这几道工序。本节不赶进度,一帧一帧地把每道工序的动机与代价讲明白,你就知道"为什么不能直接把波形丢给模型"。
学习目标
- 能解释采样率与量化精度分别限定了什么,举出语音常用的 16kHz 采样率对应的奈奎斯特频率。
- 能说出预加重的目的与典型系数,知其补偿高频衰减的原理。
- 能说清分帧的帧长帧移如何取、加窗为何能抑制频谱泄漏。
- 能看懂从时域波形到功率谱的转换,并知道为什么只需保留频谱前半。
一、把模拟声音变成数字
真实世界的声音是连续变化的模拟信号,电脑只能先把它数字化。采样是在时间轴上每隔一小段取一个点,按奈奎斯特定理,采样率决定能表示的最高频率;语音任务常用 8kHz 电话音质或 16kHz 宽带音质,16kHz 也就意味着能忠实保留到 8kHz 的频率成分。量化是用固定位数的整数去逼近每个采样点的幅度,位数决定动态范围。一句话,采样管"更细",量化管"更真"。
这一道工序看似机械,却是整套流水的地基。采样率低估、频率成分丢失,后面怎样特征工程都救不回来;好在这里几乎不犯错,达标设备都能做好。
二、预加重:把高频拉回正轨
一开口,人的声门脉冲和唇齿辐射会让高频成分天然衰减下降,辅音的高频细节常被压得很小。若直接分析,这些本该有大用处的细节会被淹没在低频里。预加重用一个简单的高通差分把它拉回来:新样本等于原样本减去系数乘以前一个样本,系数典型取 0.95 到 0.97 之间。它等于给频谱先"押上"一个高速放大,让高频不再吃亏。
别小看这个动作,它几乎零成本,却显著提升后续频谱分析的平坦度。许多初学拿来就分帧,跳过预加重,频谱往往歪得厉害。
三、分帧与加窗:切出"准平稳"的小段
语音在整句话尺度上是剧烈变化的,但在几十毫秒的微观尺度近似平稳,专业叫准平稳。于是把它切成若干短帧,典型的帧长 25 毫秒、帧移 10 毫秒;在 16kHz 下,25 毫秒对应 400 个采样点,10 毫秒对应 160 个采样点,相邻帧重叠约 60%。重叠是为了不让恰好卡在帧边界的语音突然断掉。
切帧如果硬生生截断,频谱会因边界突变而漏到邻近频率,这就是频谱泄漏。解法是加窗:用一个在两端衰减为 0 的窗函数(如汉明窗)给每帧乘一下,让起止平滑过渡到 0。加窗顺耳,却也有代价——它会稍稍抹平波形边沿,信息有一点损失,但这损失远小于泄漏的危害。下面这张图把"波形→分帧→加窗→功率谱"串起来看。
波形到功率谱示意图
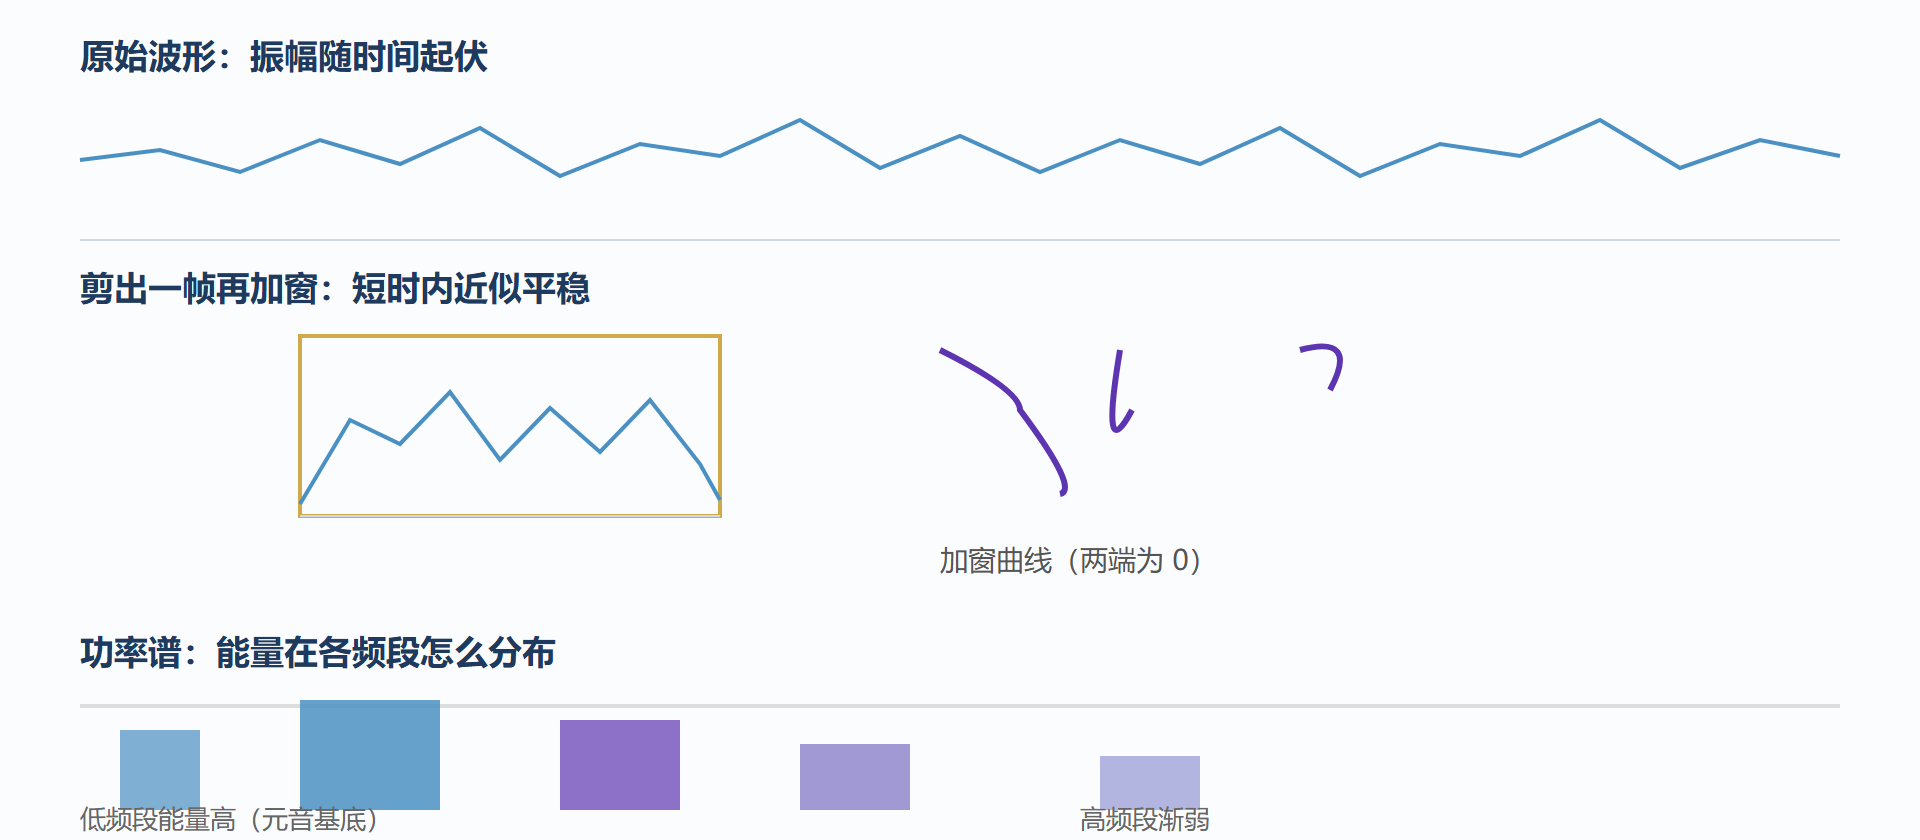
上图是三段式哑剧:上方是原波形,中间是被窗函数罩住的单帧,下方是该帧的功率谱隆起——能量集中在低频,高频渐弱。
四、傅里叶变换到功率谱
加窗后的每帧喂给快速傅里叶变换 FFT,从时域切到频域,得到各频率成分的幅度与相位。语音识别更关心能量分布,所以进一步取功率谱:把各频率的幅度平方。因为语音是实数信号,频谱关于原点共轭对称,后半部分纯属镜像,只保留前半(0 到奈奎斯特频率)即可,这能省一半存储。
小账本:一秒语音到底切出多少帧
把这点账算清,后面读代码才不慌。以宽带音质 16kHz 为例:一帧 25 毫秒 = 400 个采样点,帧移 10 毫秒 = 160 个采样点。一秒里有 1000 毫秒,帧移 10 毫秒意味着每秒约有 100 个帧窗起步;又因为相邻帧重叠 60%,一帧一帧往下滑,实际一秒钟大概切出 100 帧。换句话说,一句三秒的话,会变成约 300 个帧,每个帧再往后炼成一个几十维的特征向量——这就是声学模型"逐帧打分"时手里那串东西的数量级。
把两个常用参数组合摆开看,帧长与帧移的取舍就清楚了:
| 选择 | 帧长 | 帧移 | 每秒约帧数 | 能容纳的变化 |
|---|---|---|---|---|
| 保守稳 | 25 毫秒(400 点) | 15 毫秒 | 66 | 帧内更准平稳 |
| 常用均衡 | 25 毫秒(400 点) | 10 毫秒 | 100 | 兼顾时序分辨率 |
| 更细粒度 | 20 毫秒(320 点) | 10 毫秒 | 100 | 帧更短、边沿信息更多 |
帧长取得太长,会把两个不同音素吞进同一帧,破坏准平稳假设;取得太短,单帧内信息量不足,频率分辨率又变差。这又在跟"时间分辨率"和"频率分辨率"这对天然对手做取舍,跟 2.1 里讲的"区分度与鲁棒性"是同一种味道的两难。
五、这一帧路线的性价比
这道工序看似繁琐,胜在每步都有数学依据、几乎不吃训练数据。预加重和加窗是零成本的地基,FFT 是教科书级的成熟算法,功率谱只截一半是纯数学优化。把它们串起来,你手里已经有了一份能进第 2.3 节继续炼制的"频谱半成品"。相比直接拿波形给模型,这套处理把信号里跟发音最相关的部分亮出来,把无关相位与冗余丢掉,为后续特征工程省了大量功夫。
六、一次临场的地基自查
把这道工序变成可自查的清单,遇到"声音进模型就废"的怪病时,能直接从源头排查。第一问:采样率对了吗?拿到的音频若是 8kHz 电话音质,却按 16kHz 去提特征,频谱就只有一半,特征全错位。第二问:帧长帧移选对了吗?语速极快的连读,用 25 毫秒长帧会吞掉两个音素,赶不上变化。第三问:预加重做了吗?跳过它,高频细节被压没,辅音信息跟着丢。第四问:加窗了吗?不加固窗,频谱泄漏会把能量糊到邻近频带。这四问的答案,几乎决定了后面每一道特征工程的底座稳不稳——地基歪一寸,模型的塔楼就会歪一丈。多数"模型明明没动、识别却变差"的翻车,查来查去都落在这第一步数字化的地基上。
本节要点回顾
- 数字化:采样管频率上限(16kHz 对应 8kHz 奈奎斯特频率),量化管动态范围。
- 预加重:高通差分,系数 0.95 到 0.97,补偿高频衰减。
- 分帧:帧长 25 毫秒、帧移 10 毫秒,用于制造准平稳小段。
- 加窗:汉明窗两端趋 0,抑制频谱泄漏,代价是轻微抹平。
- FFT 与功率谱:转频域取能量,只留频谱前半减半存储。
帧已经切好,频谱也算出来了。下一节把这些功率谱,一步步炼成 MFCC 与 Fbank 这两张不同的驾驶证。