2.7 声学模型训练
2.7 声学模型训练
理论说了一堆,落到地上就是"拿什么喂、怎么对齐、用什么损失函数、在哪踩坑"。这一节把声学模型训练当做饭来拆:先从对齐说起,因为语音只有文字标签、没有帧级标签;再看最大似然与判别式两种训练准则,最后上一桌常见的失败菜与撤菜方案。
学习目标
- 能解释为什么语音训练缺"帧级标签",以及对齐(force alignment)怎么补这个洞。
- 能区分最大似然训练与判别式训练的出发点差异。
- 能举出至少三个声学模型训练中常见的失败模式及对应排错。
- 能理解数据质量与说话人多样性对训练的直接影响。
一、缺的不是标签,是"帧级"标签
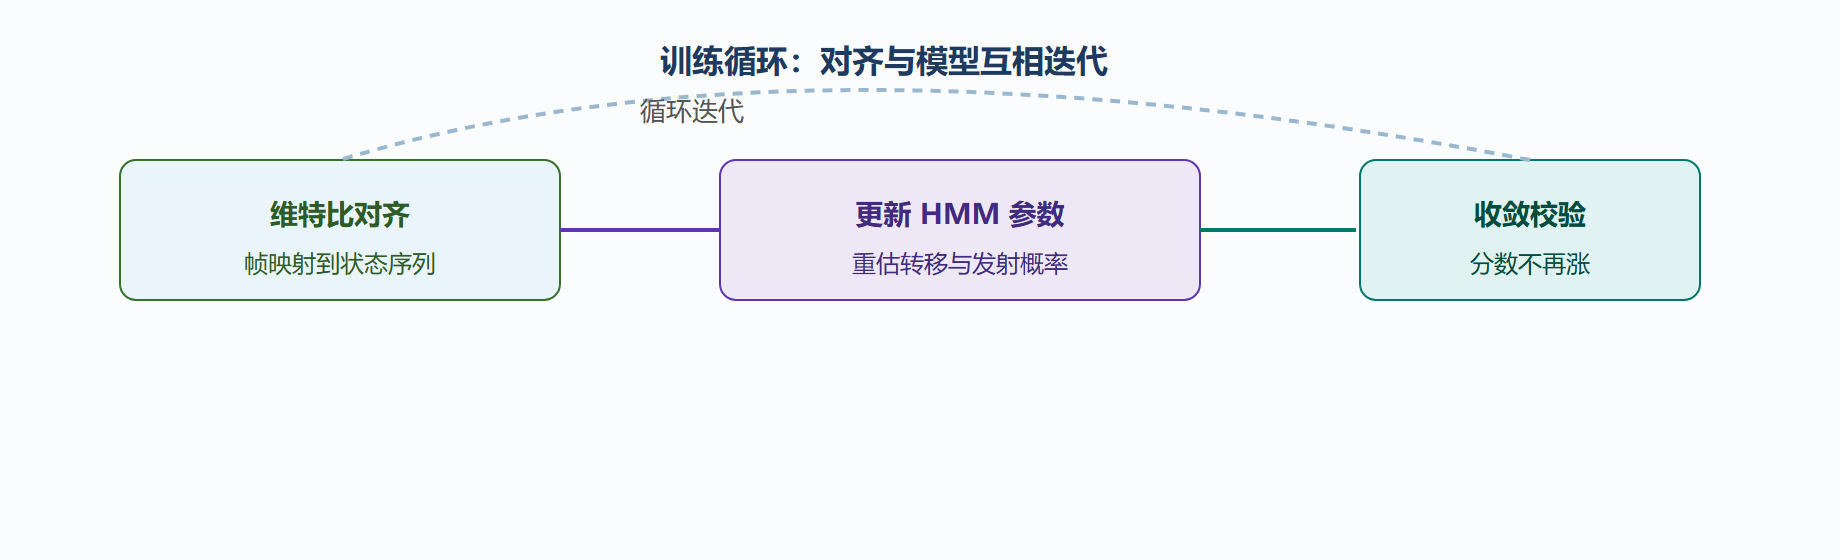
训练声学模型最头疼的不是没标签,而是标签太粗。拿来一段语音,附带的是整句文字标注,却没有"第几帧对应第几个音素状态"这种帧级标签。模型要对状态打分,训练时就得先知道每帧的真值状态。对齐(alignment)正是用来补这个洞:先用一套初始化模型,把每帧语音映射到合理的状态序列上,把这个"对齐结果"当作帧级标签去更新模型。老路子常用维特比对齐反复迭代,最新的式子在训练里面做隐对齐。总之,这一层是横在声学模型面前的天然台阶,务必理解到位。
二、训练准则:最大似然还是判别式
有了对齐,后面就是定优化目标。最常见的准则是最大似然:让给定参数下出现训练数据的概率尽量大,思路直观、收敛稳定,是 GMM-HMM 时代的主力。它的缺点是只求"像",不直接求"分得开"——一个也许能分小心别的状态,未必把"该是 A 的帧"与"该是 B 的帧"拉开距离。
判别式准则则把目标改成"尽量把正确状态拉高、错误状态压低",让模型的边界对准了"如何分得清"而不是"如何像"。主流深度声学模型往往就是在做判别式学习,常配合 CTC 之类的序列损失——那里,迫近一步见分晓的正是"整句别错而不仅仅单帧像"。两条路并没有谁能一招制胜,而是要看数据量与任务性质。
三、三种常吃到的教训
- 对齐漂移:当初次初始模型就不准,对齐洒了,后面的训练全在错误地基上盖楼。排查时盯住"早期对齐结果是否合理",异常就换多验一次模型初始化。
- 类别不均衡:语料里大量是常见音素,稀有音素出现得太少,模型对稀有类懵圈。解法是过采样稀有类别、调整加权,或干脆检查语料构成。
- 说话人单一:数据都来自同一个人,模型会把自己连成"私人订制",换个人就崩。这时要在训练前后加说话人自适应,或者拉多说话人数据。
这三条几乎是每个项目都会撞的连珠坑,提前写了排雷手册,至少能少走一个来回。
四、数据质量:一锅端的好料
特征工程、模型结构、损失函数都是手艺,可如果食材本身是馊的,手艺再好也白搭。声学模型的食材是"语音加文字"。转录与音频不同步、背景噪声或重音过重、说话人覆盖单一,都会悄悄把模型带偏。理论上,同样的模型和数据量,数据质量好的训练能省出不少事。别急着加模型层数,先问一句:这份对齐数据到底干不干净?
训练对齐迭代示意
五、一张可执行的训练草图
把上面的思路落成一帧代码,理解会更牢。以一段"伪 Python"为例——它不是能直接跑的产品代码,而是把流程说破的骨架:
# 伪代码:声学模型训练主循环(理解用,非可运行实现) samples = load_pair("train.tsv") # 每行:音频路径 + 整句转写 model = init_from_false_triphone() # 初始化模型 + 发音词典 for epoch in range(12): for audio_path, transcript in samples: states = force_align(model, audio_path, transcript) # 补帧级标签 feats = mfcc(audio_path) # 提特征 loss = sequence_loss(model(feats), states) # 经典或判别式 backward(loss) # 反向传播 if epoch % 3 == 0: model = re_align(model, samples) # 用新模型重新对齐 eval(model, alt_dev_set) # 在预留集上量体温
读这段就看懂了三个要点:每一步都要先对齐再训练,整个训练被包裹在"对齐→更新→再对齐"的外层循环里;损失函数既可以是逐帧的也可以是整句的;预留一个与训练集不同的开发集来量体温,比盯训练集损失靠谱得多。
超参数方面,给一张能照抄的起点配方:批大小 3264 帧序列、学习率 1e-3 起并随轮次衰减、轮数 815、说话人覆盖至少几十人。这些数字不是铁律,而是"从这出发再调"的经验值。
六、对齐这步棋,多数坑都栽在这
一张声学模型训练图,最常出问题、也最该先查的往往不是损失函数,而是对齐——因为后面所有训练都默认对齐是"对的",一旦第一轮初始化模型太糙,硬塞进去的对齐结果就会把整段训练钉死在错误轨道上。三个具体的排雷动作:训练前拿一段已知声音肉耳听一遍对齐输出,帧与音素大致对得上才放心往下走;把对齐结果画成"对齐轨迹图",看状态是平滑推进还是莫名其妙反复横跳;别指望一轮对齐就完事,要用训练中期的模型再对齐一次甚至几次,收敛后再对齐往往还能再榨出一点精度。记住一句话:声学模型的成败,一半取决于你养的对齐准不准,另一半才是网络充不充分。把这两样各抱紧一头,很多"玄学掉点"就都有了可查的抓手。
对齐还有一层常被忽略的附加作用:它顺带暴露了"训练数据到底脏不脏"。若你在可视化对齐时发现大量帧落在与转写无关的状态上,别急着怪模型,先回头查这段音频的转写对不对得上、有没有口误或重复被标错。换句话说,对齐不只是喂模型的燃料,也是给数据质检的一台透视镜。能主动用这台透视镜的工程师,往往能在别人忙着反复重训的时候,一锅端掉最底层的病灶。
本节要点回顾
- 帧级标签缺失:语音只有句级文字标注,靠对齐补出帧级标签。
- 最大似然:求"整段数据最像",稳,但未必把类分开。
- 判别式/序列损失:直接求"把对的路拉高错的压下去",是深度主流。
- 纠错三坑:对齐漂移、类别不均衡、说话人单一。
- 数据质量:转录同步、噪声、说话人覆盖,直接决定模型下限。
下一节收个尾:用一套指标给声学模型单独体个检——它和最终 WER 到底什么关系。