2.6 深度声学模型
2.6 深度声学模型
GMM 的天花板,正是神经网络瞄准的突破口。深度声学模型以一发 DNN 替换 GMM 去做发射概率,随后又从 CNN、RNN 一路演化到自注意力结构,把"逐帧独立"的老毛病一并治了。本节讲清楚从 DNN-HMM 到 Transformer 这条路的每一步在治什么病,并重点对排雷式对比 GMM 与 DNN 的差异。
学习目标
- 能说出 DNN 替换 GMM 后,到底改进了哪个环节(发射概率建模)。
- 能理解 DNN 输出后验概率为何要转成发射概率(贝叶斯除法)。
- 能对比说明 CNN、RNN、Transformer 各补足了 DNN 的哪个短板。
- 能客观评价深度声学模型对数据、算力的要求跟传统模型有何不同。
一、起点:DNN 抗下发射概率这杆枪
把 GMM-HMM 里的 GMM 换成 DNN,就得到 DNN-HMM。DNN 输入是特征帧(一般还会拼上左右各几帧做上下文),输出层对应所有状态后验概率 P(状态|特征)。注意这是后验概率,跟我们要的发射概率 P(特征|状态)方向反了。训练和解码时要按贝叶斯除一下,用先验状态概率把它换算回去。这一步听着绕,却是 DNN-HMM 哪怕概念上最别扭、也必须落实的地方。
DNN 相比 GMM 的杀手锏是深层的非线性拟合能力加判别式训练:它直接学"怎么把状态分开",而不是先假该分布长得像哪个高斯。深度越深,越能把 MFCC 或 Fbank 里纠缠的众多因素拉成一列干净的判别空间。
二、从 DNN 到 CNN 与 RNN:逐个医短
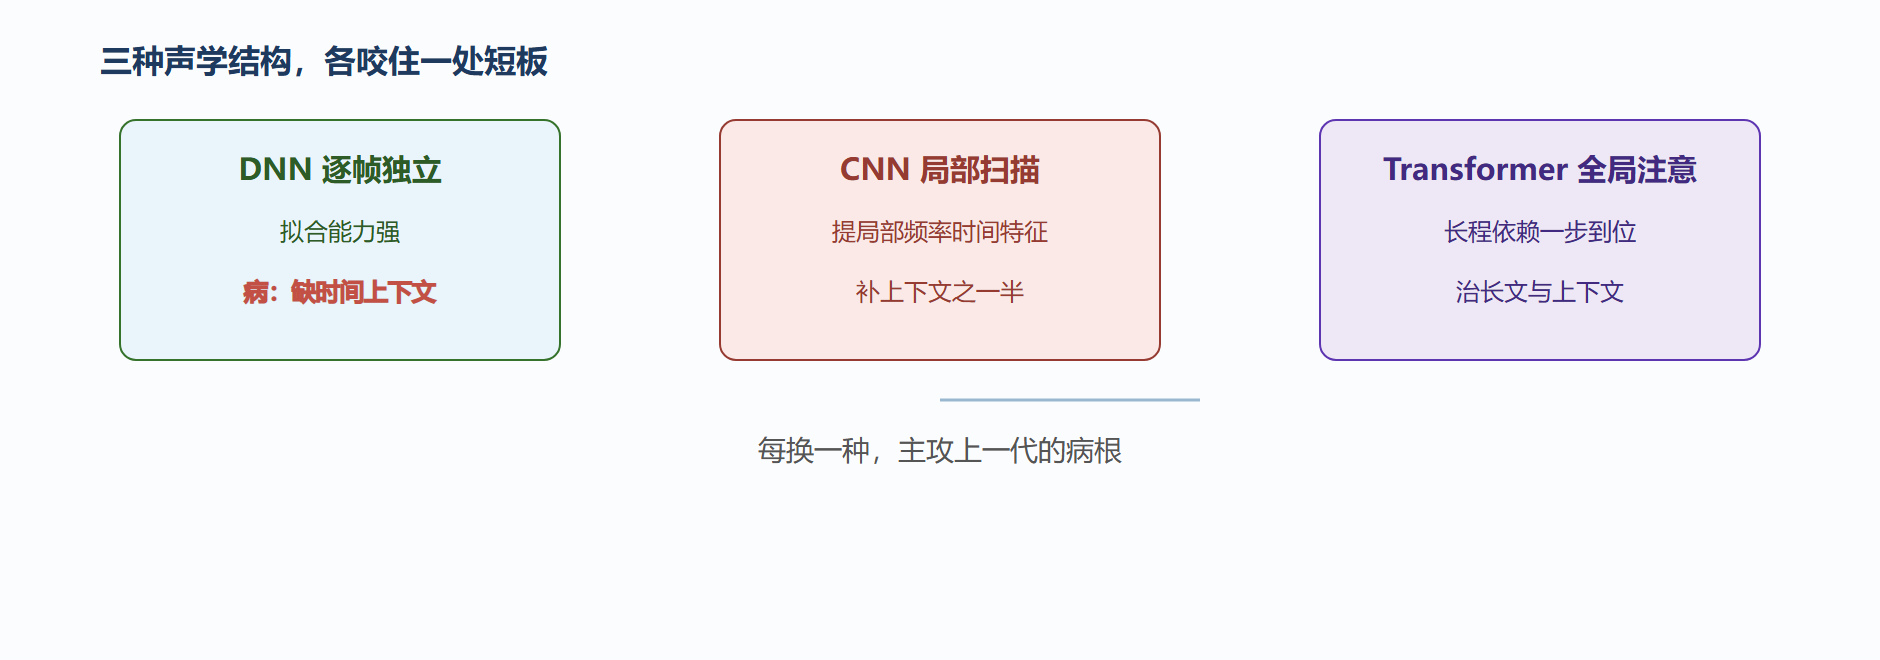
DNN 自己也有病:它逐帧独立处理,凑不出帧与帧的时间上下文。为了治这病,工程界把两种结构加进来。
CNN 卷积网络最适合处理频率轴上与时间轴上局部相关的 Fbank,它共享参数又能并行扫描,常用作整个模型的前端卷积层。RNN 循环网络则直接把时序一条条串起来,靠隐藏状态记住过去的信息,几乎是为时间序列量身定做;比普通 RNN 更能记住长程依赖的 LSTM、更轻量收敛更快的 GRU,则成了各地的主力配置。深度声学模型的标配变成了"CNN 打底提局部特征 + RNN 串联时序"的混合结构。
三、进入 Transformer 世代
再往后,自注意力机制动摇了 RNN 的统治。Transformer 靠注意力直接看整条序列,任意位置之间的依赖一步到位,不再受梯度消逝和串行慢速的牵制。对语音识别来说,句子长、上下文广时,Transformer 捕捉长程结构比 RNN 更从容。SNR-bert 里那套编码器够深,靠上下文帧的注意力建模整句的声学结构。
上图画的是这条路的收尾形态:特征进,一整串状态概率出。
三种结构接力示意
四、深度声学模型的代价
廉价的食欲换来了显贵的胃口:深度模型动辄需要海量标注语音,一张一帧一帧地对状态打标的语音集,成本不菲。好消息是,自监督预训练、半监督学习以及大量公开数据集的普及,大大降低了入门门槛。坏消息是,模型真的在变深变大,对 GPU 算力的胃口与日俱增。选型时一味追新很容易被算力和数据按在地上摩擦,务必清醒。
五、各家模型的出牌对照
把这一路演化放进一张表,每换一次结构到底在补哪块短板、要付什么代价,一目了然:
| 结构 | 修的毛病 | 强项 | 拿手的短板 |
|---|---|---|---|
| GMM | 基础发射概率 | 简单直观、好上手 | 维度独立假设、数据稀疏易跪 |
| DNN | GMM 的拟合 | 判别式、非线性强 | 逐帧孤立、不看上下文 |
| CNN | DNN 的局部 | 提局部 Fbank 特征、并行快 | 只看局部窗口 |
| RNN/LSTM | CNN 的长程 | 记忆时序、天然顺序 | 串行慢、难并行 |
| Transformer | RNN 的长程与串行 | 自注意力一步到位、可并行 | 数据与算力要求极高 |
读这张表就懂了两件事:传统与深度并不是"谁彻底淘汰谁",而是每一代都在接力地修上一代留下的某根断腿;而到了端到端时代,模型对数据与算力的胃口反而成了新的瓶颈,已经不是单纯堆层数能糊弄过去的。
六、把后验换成发射,这一步别偷懒
DNN 输出的后验概率 P(状态|特征) 和声学模型要用的发射概率 P(特征|状态),方向正好相反,很多人以为"反着读就行"、一偷懒就出错。规范的换算是一次标准的贝叶斯除法:先统计每个状态在训练集里出现的先验概率,再拿它去除 DNN 给出的逐帧后验,顺带乘一个与状态无关的公共项。为什么不能直接拿后验当发射概率用?因为解码合并时,每条候选词串覆盖的状态个数不一,若不先除以先验,那些少见状态会被系统性压下去,识别就会莫名其妙地偏向高频词。
用一个比方把性质钉死:后验是你"听到这段声音后,倒着猜它是什么状态";发射概率是"在说这个状态时,声音本应长什么样"。前者好算、直接来自网络输出,后者才是声学模型请解码器吃的正餐。所以工程里的规范做法永远是在进入解码前先做这一次除法,宁可慢一拍,也不把方向拧反。这也提醒你,读任何"模型输出"时先问一句:它吐出来的到底是后验还是发射概率?方向一错,后面所有分数合成都跟着错位——第 4.3 节讲权重合并时,你会再次撞见这道坎。
再补一个工程里的常见误区:有人为了省那一次除法,直接把 DNN 的后验当发射概率用,还拿"反正解码时所有候选都乘同一套,抵消了"来自我安慰。其实抵消不了——每条候选的状态组成不同,先验偏斜的影响随候选变化,不可能用一个公共常数磨平。所以这条换算不是可选项,而是必须做的步骤;忘了它,你在验证集上看到的任何调参结论都不可信。把这一步刻进肌肉记忆,比记任何一层网络结构都更救命。
本节要点回顾
- 主线:深度声学模型 = 用 DNN/CNN/RNN/Transformer 顶替 GMM 做发射概率。
- 后验与发射:DNN 先给后验,再按贝叶斯转化成发射概率,别弄混方向。
- 三脚接力:DNN 补拟合、CNN 补局部、RNN 与 Transformer 补时序与长程。
- 代价:数据与算力胃口大,选型忌无脑追新。
- 不错的归宿:CNN 打底加 RNN 或 Transformer 串联,是实用的主流组合。
模型机制讲清楚了,下一节就该把它喂饱:训练里那套"对齐—损失—数据"的功夫仗该怎么打。