3.2 语言建模单元
3.2 语言建模单元
语言模型的运算单位选多少,直接决定新词的覆盖、数据稀疏与在 ASR 里的对接方式。这一节比较整词、字符与字节级子词三种单元,讲清它们在覆盖率、数据量、与识别系统的耦合三方面的取舍,并给出选型判断。
读完该会什么
- 能说出整词建模的优势与致命弱点(新词覆盖)。
- 能解释子词(如 BPE)如何处理罕见词与自造词。
- 能说明在中文 ASR 里常用什么单元,以及单元粒度如何影响切分与重打分。
- 能结合 ASR 场景说出自己的选型主张。
一、为什么不能一股脑都用整词
整词模型的直觉最顺:语言模型本来就该按词算概率。现代化词库动辄数十万、百万词条,语料里却总是冒出生僻词、新造词、第三人称专名。整词单元对没见过的词永远是零概率,只能靠回退,覆盖上不去的词库在开放领域很吃亏。于是工程界开始思考:干脆把大词拆成小块,用有限的块拼出无限的词。
二、子词:用有限的碎片拼无限的词
字节级子词,典型代表就是 BPE(字节对编码)。它把语料里高频的字节对一次次合并成子词,最终得到一批中等粒度的词块:常见长词保留为主子词,罕见长词拆成几个高频碎片。用子词做单元,新词、专名都能用已有碎片拼出来,不再出现"零概率硬伤"——这个优势,是整词单元拖不动的。
代价也有:子词单元数量上升、模型序列变长、可读性变差,重打分时还得处理好"一个词被切成几块再拼回去"的麻烦。不过对付开放领域,几乎人人都愿意付这个代价。
三、中文 ASR 的天然差异
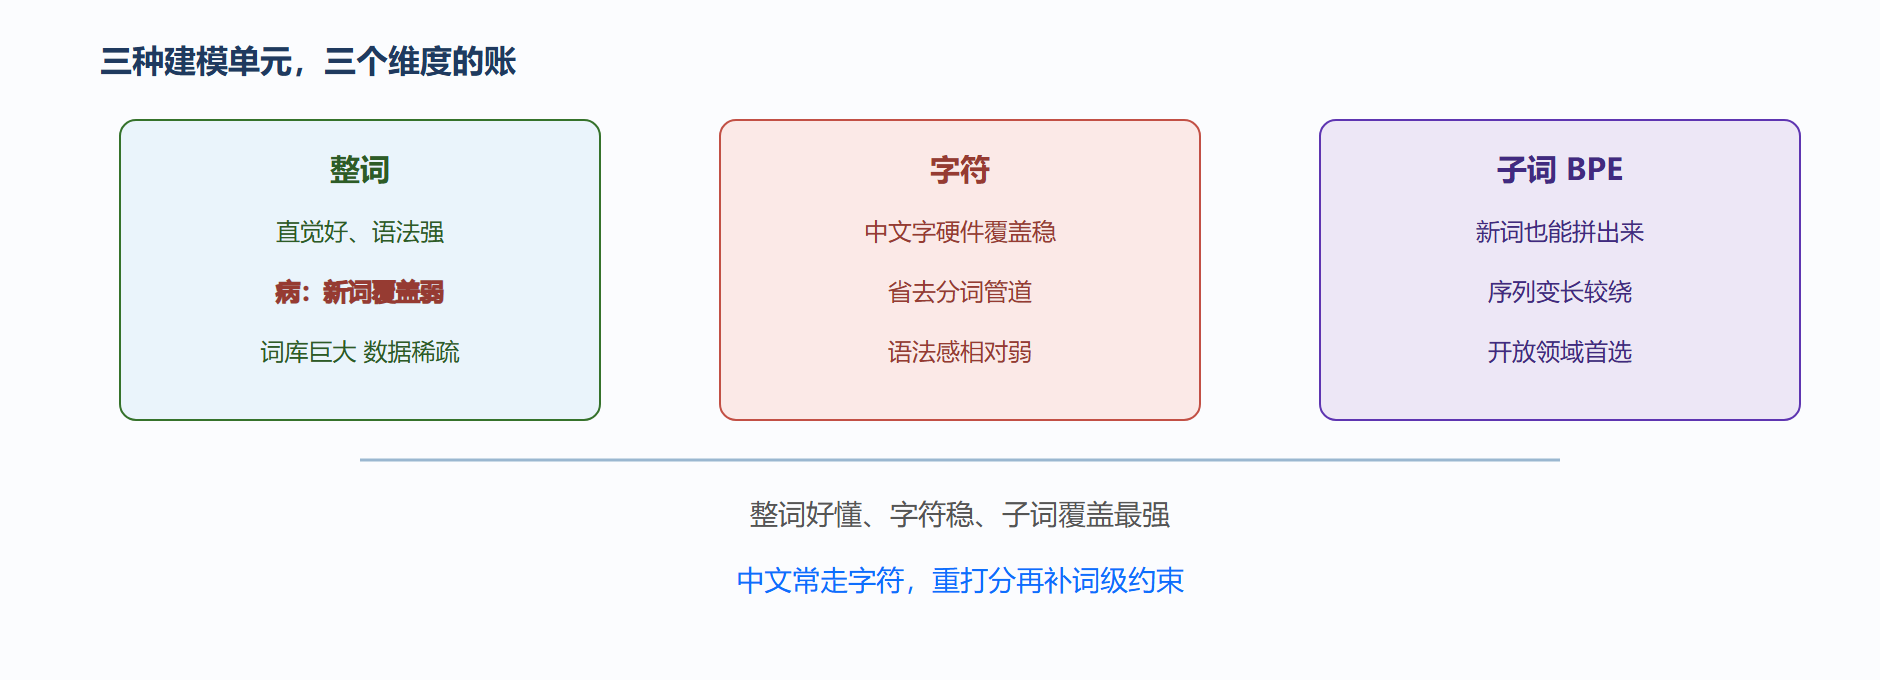
中文词与英文词的作用机制不完全一样。中文以字为基本书写单位,词的信息高度压缩进有限的字库里(约几千个常用字),字符建模就能覆盖几乎所有文本。因此中文 ASR 的语言模型既可以用字建模型,也可以用分词后的词建模型,还可以用子词。字模型的优点是覆盖稳、无需分词管道;词模型则语法感更强,但依赖分词质量与牛气词库。实际工程里,字符单位因为省心常被选中,重打分阶段再加词级约束补足语法感。
整词、字符、子词三选一
四、单元也影响与 ASR 的对接
建模单元不只是语言模型内部的喜好,还牵扯到与识别系统怎么对接。整词/子词模型直接喂解码器,用发声词典把词转回音素串;字符模型则常常安排一个额外的"词切分"步骤,把字符识别结果再重组成词,或在重打分时把字符序列切回候选词来算分。单元选得越贴近识别输出,个头越小但拼接越麻烦。权衡的标尺,始终是覆盖率与工程便利。
五、用一个生僻专名走一遍
摊开三种单元在"遇到没见过的词"时的反应,比抽象的优劣对比清楚得多。假设语音里出现一个科技公司的生僻专名"明汀科技"。整词模型里这个词根本不在词表,它只能给出零概率或退回到某几个字符,识别表现很差;BPE 子词模型恰好认识这个词里常见的碎片,如"明""汀""科技",于是能靠碎片把它拼出来,给一个说得过去的概率;字符模型则更保险,因为它本来就只识汉字,无论来什么新词都能用字符兜住。
三个单元的差异摆到一张表,选型的要领就出来了:
| 单元 | 新词 OOV | 序列长度 | 中文是否需分词 | 典型场景 |
|---|---|---|---|---|
| 整词 | 几乎必现、只能回退 | 短 | 需 | 词表稳定的垂直领域 |
| 子词 BPE | 可拼出来 | 较长 | 需 | 开放通用、专名多 |
| 字符 | 天然覆盖 | 长 | 不必 | 中文省心之选 |
顺便一提,子词虽好,但"一个词被切成几块"会在重打分时带来拼接开销;字符虽稳,语法感却弱。选型没有标准答案,只有"我的领域词表稳不稳、要不要对抗专名"这两个问题先答清楚。
六、切分接口的一句话账
子词模型看着是"语言模型内部的事",可在 ASR 里最磨人的其实是接口:识别系统吞的是词,语言模型给的却是字符或子词分。设一句"明汀科技发布了新产品",整词模型能一条词序列直接喂进去;子词模型却要先切成"明 汀 科 技 发 布 了 新 产 品",再在重打分时把这些子词严丝合缝地拼回候选词、对回词典。切分不一致、拼接对不齐,是这个接口最常见的翻车点——词侧与子词侧各出各的,最后拼不上就只能回退。这也是为什么很多工程宁可多付训练成本,也要让语言模型和词典用同一套单元,图的就是省掉那层来回换算。
再补一句 BPE 到底怎么"拼出来"的体感。假设语料里反复出现"科技""新""新品",BPE 第一轮统计相邻字节对的出现次数,把最高频的合并——比如"新"和"品"合成"新品";第二轮在合并后的序列上继续统计,把"科技"这样的常见长块也收了进去。合并的次数越多,子词块越大、序列越短;设得越低,块越碎、序列越长但 OOV 越少。这个"合并多少轮"的旋钮,就是子词粒度最直接的调节器,也是你调"覆盖稳不稳 vs 拼不拼得顺"时的第一把抓手。
拿个类比收口:整词是"整块砖",子词是"可拆的乐高块",字符是"素砖"。整块砖搭得快,可来了异形件就搭不上;乐高能拼任意形状,但要先把每块砖按图纸拆到位;素砖最万能,只是每栋楼都得从零起。ASR 里没有绝对最优的砖,只有"你的图纸稳不稳、要不要常接异形件"这一个问题。把这本账记牢,第 3.5 节重打分里那些"切了又拼、拼了又切"的操作,你就不会觉得是多余的手续了。
最后留意一个反向的细节:单元选得越碎,模型对"词的语法感"就越弱,重打分阶段就越依赖把字符或子词重新拼回词的那一步来补。所以选单元不是定格一次就完事,它决定了你后面每一处对接口要不要多写一层换算。判断自己选没选对,就看一句很朴实的验证:换一批领域语料、或换一组生僻专名,单元还能不能稳定地把你要的那些词兜住。能兜住,说明这层选择稳固;兜不住,就该回头重选,而不是硬在后端打补丁——地基的错不该让房顶来背。
一句收尾提醒:单元粒度这笔账,不用急着第一个定死——它和语言模型结构、词典、重打分方式往往牵一发而动全身。等把 3.3 到 3.5 都读完,再回头重看这一节,你会更清楚当初那三选一到底替后面省了多少功夫。
本节要点回顾
- 整词:直觉好但新词零概率,词库臃肿。
- 子词 BPE:碎片拼无限词,覆盖强,开放领域首选。
- 字符:中文覆盖稳、无需分词,语法感弱,可用重打分补。
- 对接:单元粒度影响喂解码器与重打分能否顺畅。
- 选型主张:开放通用用子词,中文常用字符加词级约束,专名密集领域回整词。
单元定了,接下来就是模型本体。下一节,用最朴素的计数方式起手——N-gram 语言模型。