3.3 传统语言模型 N-gram 与平滑
3.3 传统语言模型 N-gram 与平滑
N-gram 是语言模型的活化石,也是理解一切语言模型最好的起点。它用一个最简单的假说——下一个词只依赖前面 N-1 个词——把概率计算变成对文本的计数统计。这一节从二元、三元开始推公式,再引出稀疏问题的死结,最后重点对比几种平滑方法,特别是 Kneser-Ney。
读完该会什么
- 能写出 N-gram 的最大似然估计,说清它为什么是"计数比计数"。
- 能说明数据稀疏为何是 N-gram 的结构性缺陷。
- 能举例说明几种平滑方法的动机,说出 Kneser-Ney 最强的原因。
- 能解释加参数 λ 对 N-gram 的影响,及何时该用更高阶。
一、马尔可夫假设下的计数法
N-gram 的语言模型,就是把整句概率的链式分解再进一步简化:当作下一个词只受前面 N-1 个词影响。N=2 是二元,看前一个词;N=3 是三元,看前两个词。估算这些条件概率的方式简单到令人怀疑——直接在语料里数:
P(w_i | w_i-2, w_i-1) = Count(w_i-2, w_i-1, w_i) / Count(w_i-2, w_i-1)
也就是"前面这两个词出现过多少次"和"再带上当前词出现过多少次"的比值。这个最大似然估计原理之纯,让 N-gram 服务了很多年 ASR 建语言先验的粗糙任务。它天然好懂、算得快、存储可精确控制,在神经模型彻底成熟前,是工业界绝对的当家花旦。
二、稀疏:计数法的骨头里卡着的刺
计数法的硬伤一望便知:语料再大,也有无数"三元组"一辈子没碰过。算出一个零概率,意味着这句子永远排不上号,万一它真是对的就惨了。这就是数据稀疏。越往高阶走,N 越大,组合爆炸得越疯,稀疏伤得越重。所以不仅要平滑,还得有"回退"和"插值",把没见过的情况往低阶的模型上靠。
三、平滑的几代解法
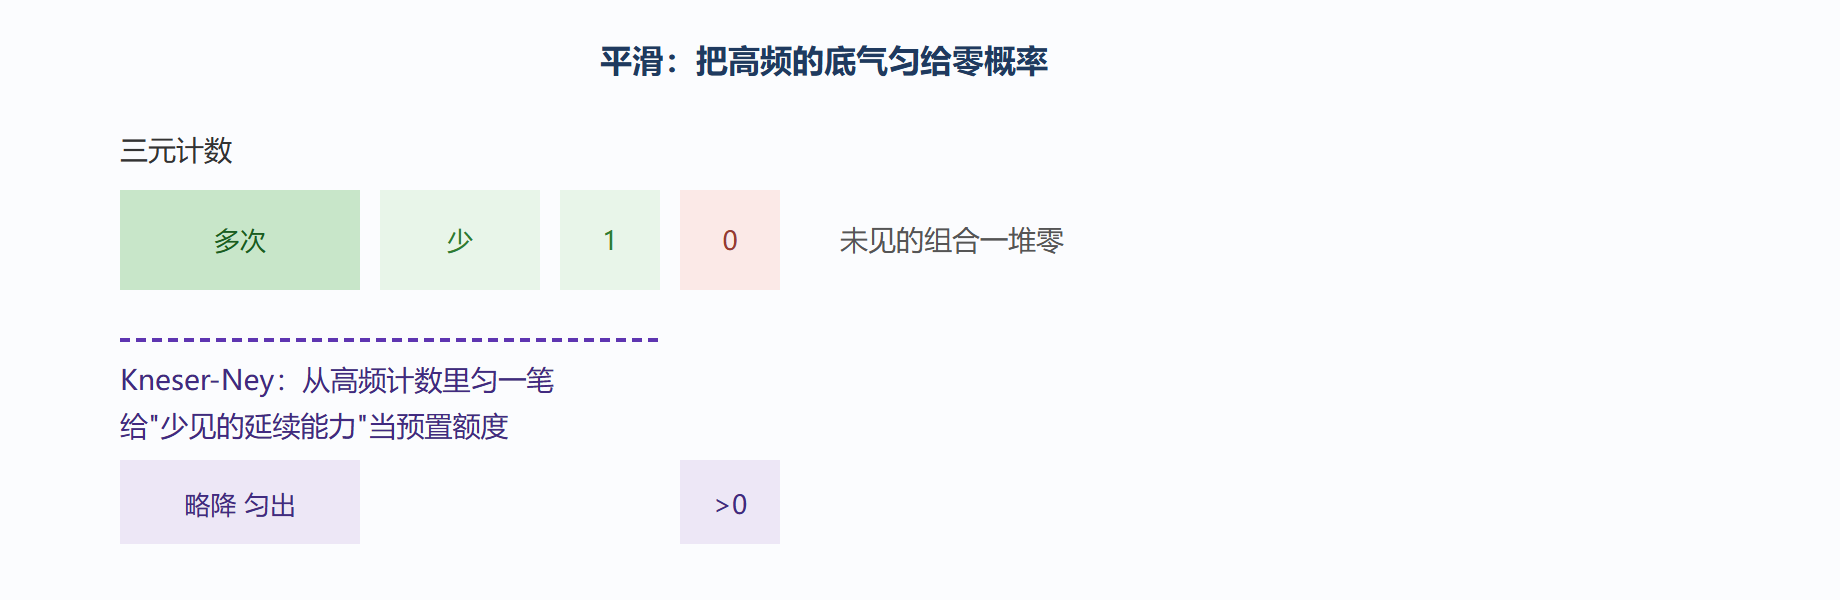
低配方案是加一平滑,给每个计数值都加上 1,看着解决零概率,实则几乎不蹭可见的命中,用起来吃力。Good-Turing 平滑基本思想是把低计数值的估计"转让"一部分出来给计数器为零的喜事,比加一强,但仍不完善。到了 Kneser-Ney,思路升华成"给每个词先分一点'能在少用的语境里出现'的预置额度,再在这个预置分配上面计数"——它特别擅长处理罕见词和短语的延续,是最被认可的主流平滑方法。判断标准也很朴素:它让模型对未见词和词汇搭配的泛化能力最强。
四、N 的取舍与权重
选几阶也有讲究。二阶、三阶是性价比之选,太高阶计算和存储爆炸、稀疏更猛,还容易过拟合。除了阶数,还可以对长短不同 n-gram 做插值加权,让不同阶的"直觉"互相补充。总之,N-gram 有数据稀疏这个迈不过的坎,但在数据量充足、结构简单、对实时性要求高的场景,它仍有一席之地——甚至在今天不少低资源或流式系统里,N-gram 还是又快又稳的选择。
Kneser-Ney 平滑示意
五、拿一小段语料真的数一遍
设我们只有这么一小段语料:"把门关上,把窗户关上,把门打开"。要估算三元的条件概率 P(关上 | 把门)(这里为说话顺手把"关上"当一个词)。先数分母:出现过"把门"的地方有两处,即"把门关上"和"把门打开",所以 Count(把门) = 2。再数分子:带上"关上"后"把门关上"只出现一次,Count(把门关上) = 1。于是 P(关上 | 把门) = 1 ÷ 2 = 0.5。
但你一定已经发现问题:如果语料里压根没出现"把门锁上",三者计数都是 0,概率就变成 0,而"把门锁上"明明是人话。这正是稀疏死结的现场版。下面这张表把几代平滑在"面对零计数"时的姿态摆出来:
| 平滑法 | 面对未见三元组的做法 | 有没有把"常见性"和"延续性"分开 |
|---|---|---|
| 加一 | 一律 +1 | 不分 |
| Good-Turing | 聚合并"转让"低计数 | 不太分 |
| Kneser-Ney | 给词预置"能在少语境延续"的额度 | 分开算了 |
Kneser-Ney 最妙之处,就是把"这个词生不生僻"和"这个词爱不爱在某个跟着的词后面延续"当成两笔账来算——前者分到的额度低不怪它,后者才是判断该不该给延续的关键。
六、什么时候还愿意用它
别急着判 N-gram 过时。在低资源、流式在线、实时广播这类对"快"和"稳"要求极高的场景里,N-gram 在线字典级的查询速度、可精确预算的存储,反而比现代神经模型更省心。理解它的计数与平滑,还让你日后读懂了无数库代码里"backoff"与"插值"这两个拦路词。
七、用测试句去读平滑好坏
平滑是为了让"没见过的组合也能给出一个说得过去的概率",可不同平滑给出的数字差很大,凭什么比高低?最实用的一招不是背理论,而是拿"回退后还分不分得开"来检验:准备一批包含生僻搭配的测试句,分别喂给不同平滑的模型,看它们在未见词上的相对排序稳不稳。Kneser-Ney 之所以常胜,就在于它在这种检验里比加一、Good-Turing 更少出现"为了不零分而乱给分"的糊涂账——所谓糊涂账,就是虽然给了低频项一个机会,却把真正关键的词也一并压了下去。练会这套"拿测试句读平滑好坏"的功夫,比背十遍算法名都实在,也让你在下一节换成神经模型时,多了一把判断新旧高低的尺。
再补一句实操建议:很多老代码里的 N-gram 默认就是 Kneser-Ney,配合 backoff 与插值。初上手别急着改平滑,先把 Kneser-Ney 的一条默认链路跑通,再回头体会各平滑间的细微差别,会省力得多。
本节要点回顾
- 核心假设:下一个词只依赖前面 N-1 个词。
- 估计:条件概率 = 三元计数除以二元计数,纯计数。
- 稀疏死结:组合爆炸让零概率常态化,N 越大越惨。
- 平滑演进:加一、Good-Turing、Kneser-Ney 一代比一代强。
- Kneser-Ney:给罕见词预置延续额度,泛化最好、最推荐。
- 务实选择:二、三阶够用,特定场景(实时、低资源)N-gram 仍是选择。
N-gram 靠拉扛计数,神经网络却翻玩起表示与长程依赖。下一节看神经语言模型。