3.6 语言模型训练与领域适配
3.6 语言模型训练与领域适配
语言模型的能力上限,一半由文本数据决定。这一节把"数据决定论"落到操作层面:数据规模越大越好吗、怎么清洗与采样、怎么让模型在目标领域(医疗、法律、会议)变强,以及半监督与无监督这类省标注数据的大招。
读完该会什么
- 能说出"数据规模大"与"数据质量高"为什么两者都重要、如何权衡。
- 能描述领域适配的几种做法:领域语料、微调、插值、重加权。
- 能说明半监督/无监督如何借助大规模无标注文本辅助语音建模。
- 能设计一份"目标领域语言模型"的训练方案。
一、更多文本,但更聪明的文本
语言模型直觉"越多越好",但堆数据很容易犯两个错。一是重复与冗余:同质内容反复出现,模型的泛化能力被稀释;二是质量参差:混入广告、乱码、错别字,模型学了坏形。所以数据清洗是训练的前置工程:去重、去噪、修字号,偶尔还要做类别均衡。看得出,语言模型训练的名片不是"数据更多",而是"数据更聪明"。
二、领域适配:让模型说行话
同一个语言模型拿去识别医疗口述和会议对话,表现差异极大,因为两种语域的词分布天差地别。领域适配的常用手法有几种:
- 领域语料参与训练:把目标领域的文本混进训练集,这是最朴素也最有效的做法。
- 微调:先用海量通用文本训练出通用模型,再拿领域语料微调一小段,专注学领域词与句式。
- 模型插值与重加权:把通用模型和领域模型的分数做插值,或用权重把领域样本放大。
- 在线重打分:识别时拿领域模型给候选重新打分,最不折腾但够即时。
四种做法常混合使用。选择哪套,最终取决于你手头领域语料有多少,以及部署时对模型尺寸和时延的容忍度。
三、半监督:借力无标注语音做弯道超车
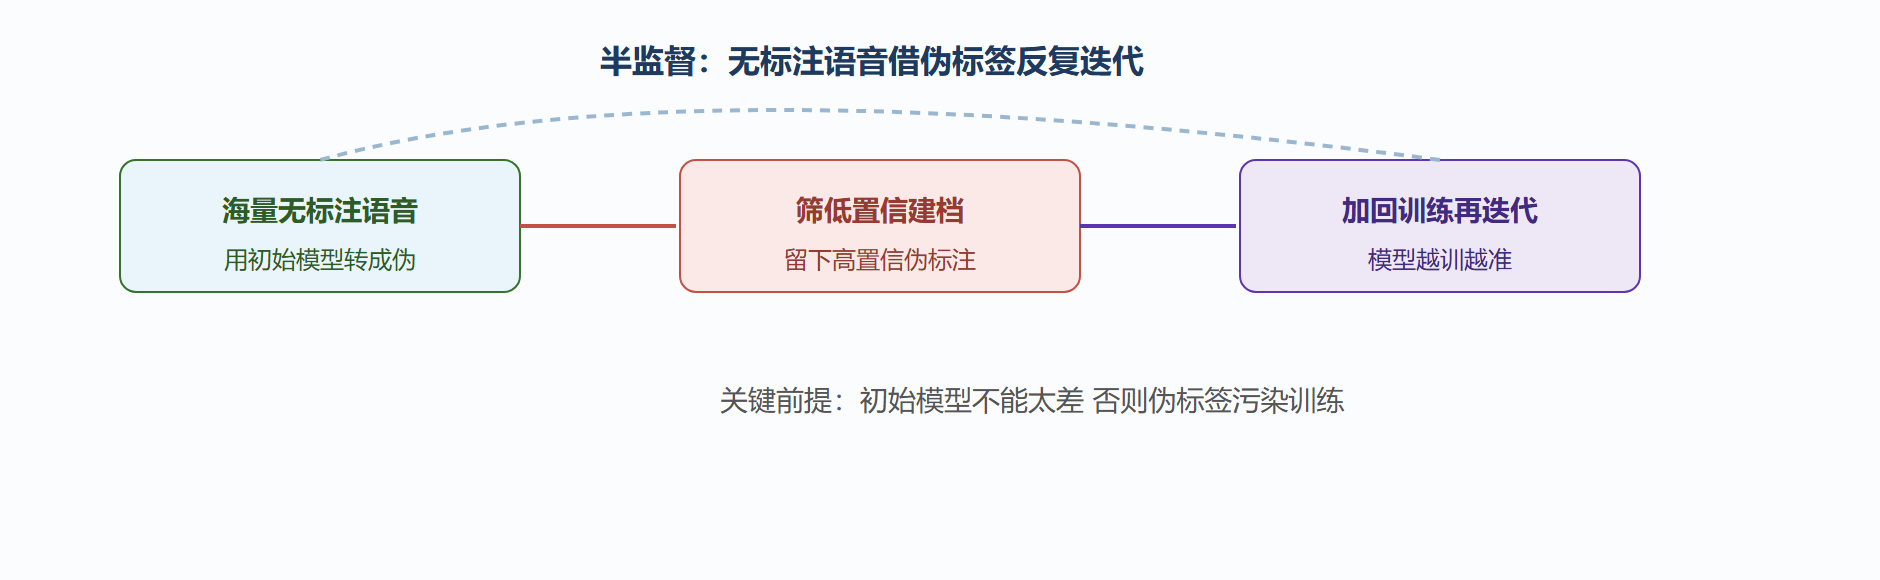
语音识别常用标注语音拼接,可标注太贵。半监督路线先拿初始模型把无标注语音抹成伪标签,再把置信度高的"伪标注"放回训练,反复迭代。它能大幅摊薄标注成本,前提是初始模型别太差,否则伪标签里会带着错误一路传染。无监督方向则用大规模无标注文本预训练表示,用语音与文本的对齐姿势把模型撬出更多聪明劲。过去几年,半监督+伪标签的组合让不少系统的数据压力骤降。
四、一套可落地的领域语言模型方案
把以上串成一份方案:先收集并清洗目标领域文本(医疗病历、会议纪要均可),按字符或子词 token 化;用通用语料预训练一个基座,再用领域语料微调;训练中用困惑度与一小块领域验证集把关;部署时把领域模型接到解码器,配上重打分与插值融合。全程用验证集调权重,别拍脑袋定主导。
半监督伪标签迭代
五、看一个领域适配的现场
把"领域不匹配"写成一句看得见的失败,比背定义有用。拿同一句 "替甘拜利可——替格瑞洛,一天一次口服"(一个医学口述的例子,用占位字"甘拜利可"代替药名以免误引)给通用语言模型打分,由于通用文本里几乎见不到药名与医嘱句式,语言先验会把"替格瑞洛"先验拉得很低,最后可能被识别成别的词。换成在医学病历语料上微调过的领域模型,这类药名与句式的先验被显著提高,识别立刻改观。
领域适配四法放一张表,选型的思路就清楚了:
| 方法 | 需要多少领域语料 | 改动成本 | 何时最划算 |
|---|---|---|---|
| 混入训练集 | 中 | 低 | 语料不稀有,想整体变强 |
| 微调 | 少 | 中 | 已有通用基座,想快速切方向 |
| 插值/重加权 | 少到中 | 低 | 想同时要通用与领域两种先验 |
| 在线重打分 | 少 | 低 | 部署快速试水,改动最小 |
一句话记住差异:混入是"让模型生来就会",微调是"半路补课",插值是"两个裁判并排发言",重打分是"识别完再请领域裁判复核"。
六、数据配比:一台得用验证集拧的天平
领域适配最常翻车的不是不会方法,而是比例失调。把领域语料和通用语料倒进同一个池子,配比就是个需要小心拧的旋钮:领域语料太少,模型被通用先验淹没,说了也白说;领域语料太多,模型又被这个方向的词框死,遇到域外表达反而更笨。经验上从 1:9 到 3:7 起步,在验证集上边看困惑度边微调比例,比拍脑袋定值靠谱。字段上还藏着一段隐蔽的坑——"数据重复度":有人把同一批领域文本反复刷几十遍来造假供给,模型看似记住了,实则过拟合,换个讲法立刻翻车。
再把"什么时候该用哪一招"钉死,能帮你少走弯路:若目标是极窄的固定句式(如报工号、查物流),直接重加权压量便够;若目标是开放对话里混着医疗语域,那该混入加微调双管齐下,再用插值兜住"既像医疗又像通用"的那条缝。没有放之四海皆准的比例,只有"在验证集上一格一格试"的纪律。接受"调权重就是调别扭"这个事实,你就不会指望一次训练就贴在某个目标上敲定答案。这条纪律,同样会陪你走到第 5 章的参数调优里去,是整套流水通用的保底法。
数据配比之外,还有一个常被忽略的考察点:领域语料和通用语料的"占比"会随任务阶段变化。冷启动时通用成分多一些,让基座先站稳;等模型已经把话连顺,再逐步提高领域语料占比,把注意力转向专有词与句式。这个"先通用、后领域"的渐进打法,比一上来就砸领域数据更稳,也更容易观察到每一步到底提升了哪一块。配合 3.7 讲的"按领域拆看困惑度",你能一路盯着"领域分有没有真的在看涨",而不是糊里糊涂地以为数据越多越好。真正的高手,都是在这种"小步试探、时时回看"的节奏里把领域这块短板补牢的。
一句话收口:配比、阶段、验证这三件套,缺一个,领域适配就容易变成"越努力越跑偏"。把它们串成习惯,才是真功夫——也让你在向别人讲解时,能指着某个具体数字说出"为什么是这样调的",而不是只会说"试出来的"。
本节要点回顾
- 数据智慧:去重、去噪、均衡,胜过盲目堆量。
- 领域适配四法:领域语料、微调、插值重加权、在线重打分,可混合。
- 半监督:伪标签循环迭代,摊薄标注成本,防错误传染。
- 方案骨架:清洗、预训练、微调、验证把关、部署融合。
- 核心提醒:任何融合权重都在验证集上调,不拍脑袋。
语言模型的训练与适配讲完,下一节谈账本:怎么用困惑度这些指标给语言模型量体检。