3.5 神经网络语言模型实战与重打分
3.5 神经网络语言模型实战与重打分
模型选好了,关键是落地。工程上一般不让神经语言模型直接进第一轮搜索(又重又慢),而是先让轻多的 N-gram 出候选,再用神经模型给候选重打分。这一节先讲一套可操作的训练配方(数据清洗、token 化、超参、验证),再重点拆解重打分的完整流程与常见坑。
读完该会什么
- 能写出一套神经语言模型训练的配方:数据、token、超参、验证。
- 能画出重打分的完整流水,指出第一、第二轮各用什么模型。
- 能说明重打分为什么能显著提分,又有什么必须防的坑。
- 能解释困惑度与训练集覆盖对重打分质量的直接影响。
一、训练配方:把一堆文本炼成先验
训神经语言模型,本质是一场"给语言数据量形状"的工程。原料是海量纯文本,越贴任务领域越好。开工前先把文本清洗了:去掉乱码、广告、残缺片段,把中文日常会遇到的 k 语支混排的问题想清楚。接着 token 化,中文常常直接按字符或子词处理,得来一批好办的字典。然后选结构,小任务是几层 Transformer,大任务要认真权衡深度宽度。超参上,学习率、批次、序列长度都该在验证集上试,切忌一上来就上纲上线追求最大模型。
验证集要守规矩:与训练集同源但不相交,用困惑度或下游指标做令牌。训练是吃显存的体力活,别让重复数据不停刷屏。很多时候,数据质量差一个档次,模型就算堆再大也补不回来。
二、重打分:让神经模型做第二轮裁判
直接拿神经模型去第一轮搜索,慢得离谱。工程解法是分工:第一轮用轻快的 N-gram 快速枚举出 N-best 候选句子;第二轮把这一批候选交给神经语言模型重新算一遍词序列概率,再与声学得分合并排序,挑出最优。重打分一次只处理 N 条候选,成本可控,却把第一轮听漏的长程语言约束一举补回。这一手让不少系统在不增加第一轮搜索负担的前提下,稳稳涨几个点的 WER。
两轮打分流程
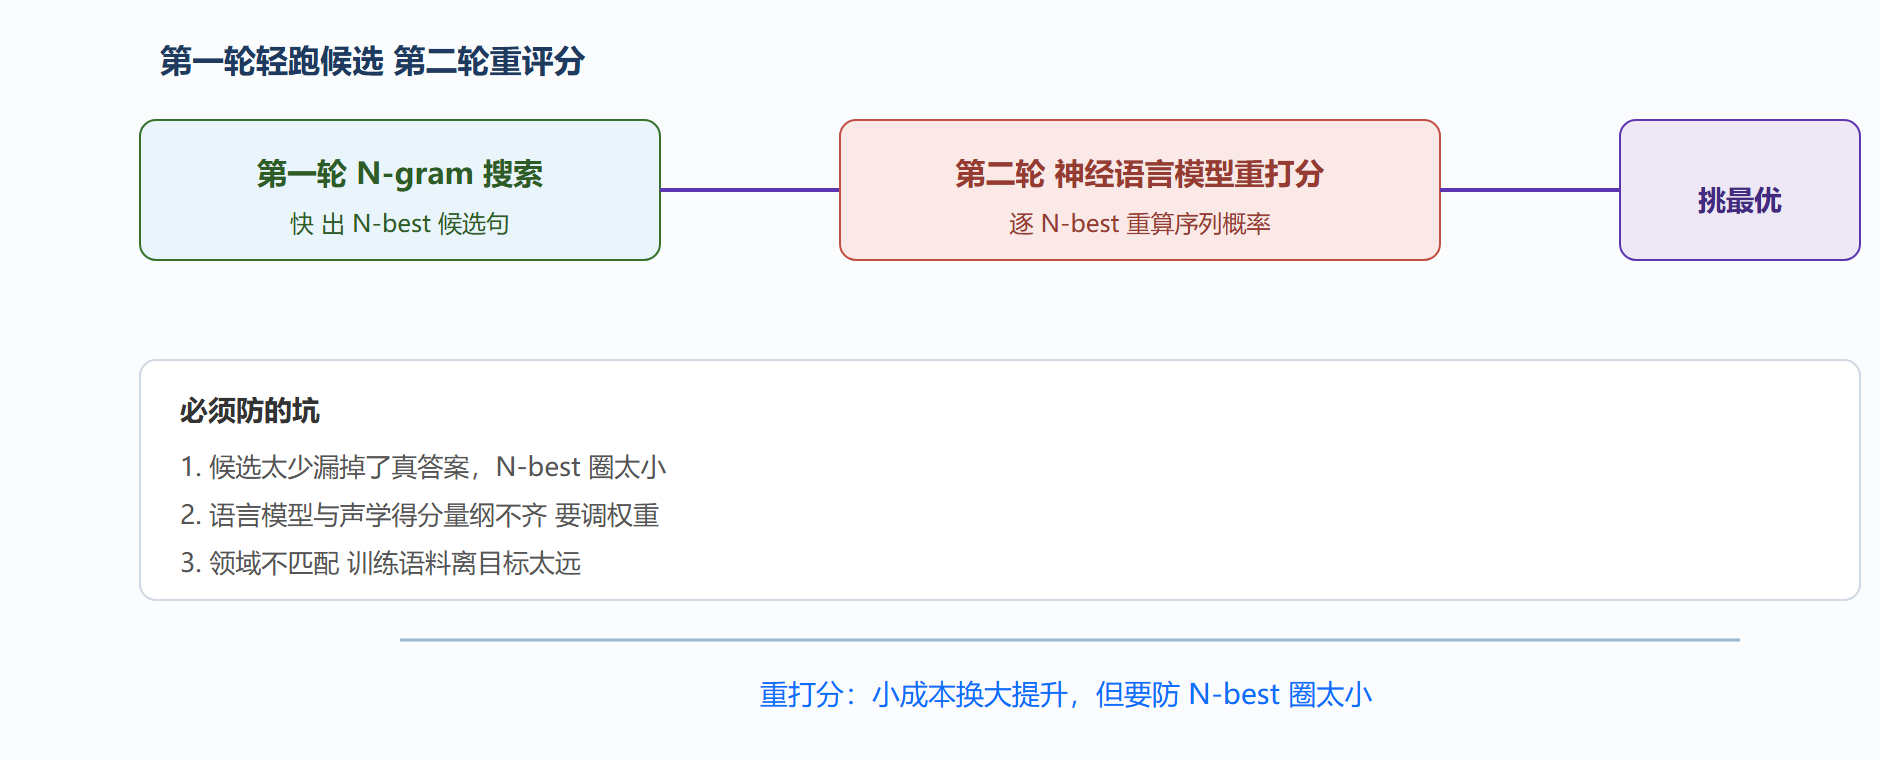
上面把两轮打分的分工和三个坑画齐了:讲究分工、讲究权重、讲究领域。
三、坑与调优清单
- 候选圈太小:N-best 里没装进真句,重打分再准也无济于事。宁可让 N 稍大、多花一点第二轮的时间,也不要在第一轮就闷死候选。
- 量纲不齐:神经模型的分数与声学对数概率不是一份刻度,直接相加会失衡。要显式调融合权重,最好在验证集上搜。
- 领域不匹配:神经语言模型对语料风格很敏感,通用语料训出的模型去打分医学口述,自然刮刮。领域内语料放在数据里,效果立竿见影。
- 连锁反馈:重打分结果喂回来还能改进第一轮的 N-gram 或提示系统以人为才,形成良性迭代。
四、把重打分真正算一遍
重打分不神,它只是把声学分与语言分按权重再合一次。设对同一句话,第一轮 N-gram 排出两条候选 A 和 B。两者的声学对数得分(来自声学模型)分别是 A 的 3.2、B 的 3.0,差得不远;可神经语言模型对 A 给的先验是 1.8、对 B 给的是 4.5——读完整句上文后明显偏好 B。若语言权重 λ 取 0.5,则 A 总分为 3.2 + 0.5×1.8 = 4.1,B 总分为 3.0 + 0.5×4.5 = 5.25,B 反超,重打分即奏效。
把权重 λ 从高到低调,结果会跟着变:λ 越小,声学越占主导,第一轮的"听感分"说了算;λ 越大,语言越占主导,可能与真实声音渐行渐远。这个取舍在验证集上搜 λ,正是重打分不比玄学、而是一枚可校准旋钮的证明。顺手看一眼 N 的取舍:
| N 大小 | 第一轮成本 | 第二轮成本 | 风险 |
|---|---|---|---|
| 太小(如 10) | 省 | 省 | 真句可能根本没进候选 |
| 适中(如 100) | 略增 | 可接受 | 兼顾覆盖与开销 |
| 太大(如 1000) | 更耗时 | 明显增 | 收益递减 |
五、重打分之前,先把"候选圈"管好
重打分最容易被低估的先决条件,是第一轮 N-best 到底把真句装进来没有。设想一个场景:第一轮束搜索开了个偏小的束宽,"把门关上"这句真实答案要么根本没闯入候选列表,要么排在几十名开外;第二轮无论神经模型多准,都只能在一堆都不是的选项里挑祖先。这就解释了为什么"重打分涨分"常常以"先把第一轮束宽调大"为前提——先保证真句在场,再谈精挑。工程里常用的一招是先跑一遍带大束宽的 N-best 出海清单,量一量"真句排在第几名";若真句排不进前 N,就大胆把 N 拉大,而不是急着修第二轮。
另一个容易忽视的坑是重打分的时间预算。N 取 100 时,每句要神经模型重算一百遍,真到线上实时流可能扛不住;稳妥做法是给 N-best 按分数排序、只对前面的候选重打分,或先拿更轻的神经模型做早筛。别让"重打分"变成"重影"——第一轮辛苦枚举出的候选,第二轮若不限量地全算,省下的时间会被反噬。说到底,重打分是一门平衡术:N 大一点补覆盖、小一点保实时;神经模型重一点更准、轻一点更快,全要靠验证集把每个旋钮找平。把这门平衡术本身先训练一遍,比背任何一条捷径都管用。
把"候选圈"这条再往深处补一层:很多人只记得"重打分要重算概率",却忘了它本质是"在圈内排序",圈外再准也进不来。所以在线流式场景里,与其无限加大 N,不如先做"候选早剪枝"——用声学分加一个粗糙的 λ,把明显不行的候选在进第二轮前先砍掉,再把省下来的算力投给真正有希望的几条。这样做既保住了真句在圈内,又不至于让第二轮被海量候选拖垮。把"先保圈、再精挑、后省力"这套顺序记牢,你配置重打分时就不会顾此失彼。最后再叮嘱一句:所有 N、λ、剪枝门槛这类旋钮,一律在验证集上扫,别靠一次训练的结果拍脑袋定稿。
再补一句判断成熟度的经验:若真句总稳定排在 N-best 的前几名,说明重打分这块再压分也只是锦上添花,这时与其继续调 N,不如掉头去优化第一轮的波形或语言先验,性价比反而更高。记住,重打分是精修,不是起死回生的魔术;把"哪里还有肉可挖"想清楚,比在每个旋钮上较劲更有用。
本节要点回顾
- 配方:数据清洗、token 化、模型结构与超参、验证集把关。
- 两轮分工:第一轮 N-gram 出 N-best,第二轮神经模型重打分挑最优。
- 性价比:只处理 N 条,成本小,却能补回长程语言约束。
- 三大坑:候选圈太小、量纲不齐、领域不匹配。
- 协同:重打分结果可反馈改进第一轮,形成迭代。
实战配方到手,下一节往上游再看一层:语言模型的数据规模、领域适配与半监督这些训练层面的学问。