5.2 评估数据集与任务基准
5.2 评估数据集与任务基准
一套模型强不强,得在公认的考卷上作答才有可比性。这一节盘点几大类公开评估数据集(通用朗读、电话语音、远场/会议、中文等),讲清它们各自测的是能力上的哪一面,并给出"拿公开基准验证模型、拿领域数据验证落地"的正确姿势。
学完能干什么
- 能举例说明通用朗读集与电话语音集测的能力区别。
- 能解释远场/会议数据与单通道数据的差异,及其对鲁棒性的考察。
- 能说出一两个中文语音数据集的用途与侧重。
- 能设计"公开基准 + 领域数据"双层验证方案。
一、公开考卷的用处与教条
公开数据集的价值在于"同台竞技,大家用同一张卷子"。跑通一个社区公认的基准,相当于给你的模型发了张可比性的准生证;别人说"我在某个集上 WER 多少",你一眼能对上同一把尺。但教条也由此而来——花哨地在公开集上追那 0.1 个百分点,很可能只是过拟合了这套数据的媚俗。公开数据测的是"能不能打",领域数据才测"你这套能不能落地"。
二、几类主流考卷
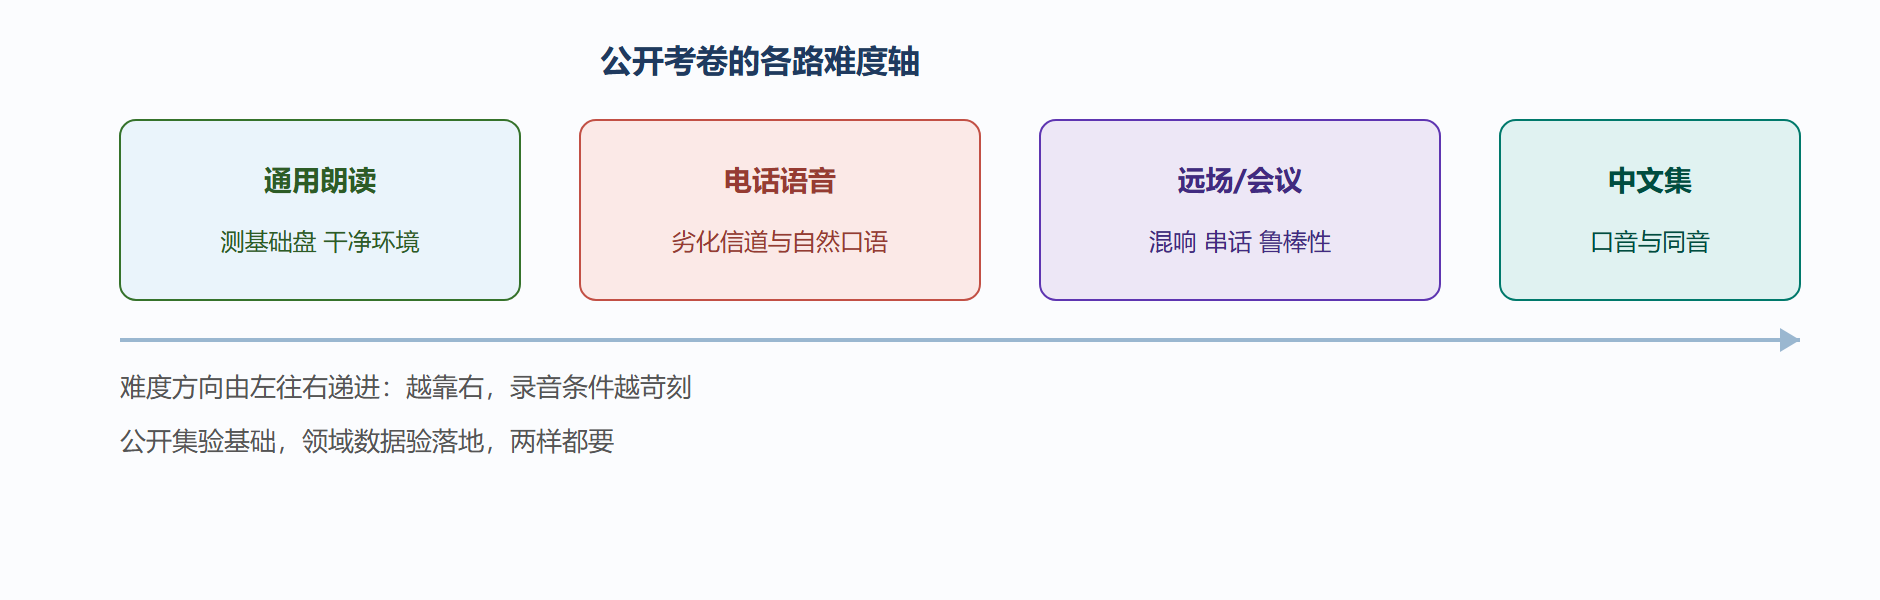
- 通用朗读集:专业或志愿者清晰朗读,噪声低、口音可控,测的是模型的"基础盘",像语言通学、干净环境下识别准不准。
- 电话语音集:真实电话信道、带噪声与带宽压缩,测的是模型对劣化信道和自然口语的耐受力。
- 远场/会议集:麦克风阵列拾音、多人轮替、混响与串话,测的是鲁棒性和对远距离语音的接纳度。
- 中文集:覆盖普通话、带地方口音、各路语音与词表,测的是对中文发音变化与同音词的把握。
每组都有自己的"难度轴",别拿通用朗读的分数去度量一台要在嘈杂会议室跑的模型,那样测不出真水平。
三、拿"公开 + 领域"双层验证
成熟的落地流程分两步走:先拿公开基准确认你的模型基础能力没退步,再拿目标领域的小样本语音与文本定义它的实战分数。领域考卷要尽量贴部署现场:同样的麦克风、同样的噪声、同样的说话人口味。若公开集上漂亮、领域集上掉一截,说明通用能力尚可、但对真实场景的适配欠火候,这时候该回头做第 3 章讲过的领域适配,而不是急着换模型结构。
四、指标口号的常见误区
- 只看一个数:把多个场景的 WER 揉成一个总平均,掩盖了"某场景差得离谱"。
- 集外比分:用跟训练集重叠的语音做测试,等于开卷考试,分数虚高。
- 不设基线:没有统一参考实现当对手,涨的瓦数缺乏说服力。
报告时务必写清楚:数据来源、是否与训练重叠、是什么难度、用了什么指标。一条规范的可复现评估,比一堆花哨的百分号金贵得多。
公开考卷的难度轴
五、把四类考卷的难易摆成一张表
抽象的分类不如看得见的分量。四类考卷各自"考什么、难点在哪、合不合我的现场",可以一条条摊开:
| 考卷类型 | 难在哪 | 主要测 | 谁适合拿它比 |
|---|---|---|---|
| 通用朗读 | 基本无噪声、口音可控 | 基础盘 | 算法打底验证 |
| 电话语音 | 信道劣化、带宽压缩 | 抗劣化、自然口语 | 客服/电话场景 |
| 远场会议 | 混响、多人串话、远距离 | 鲁棒性 | 会议室、家居远场 |
| 中文语音 | 地方口音、同音词多 | 对中文的把握 | 中文产品落地前 |
懂行的做法是:先在通用朗读上确认"基础没退步",用一张公开集给个对外可比的分数;再用与你麦克风、噪声、说话人几乎一模一样的小样领域集,量出"落地真分数"。二者都用上,才不会把"公开集好看的模型"误当成"现场好使的模型"。
六、选考卷的三个自问
挑数据集时,先问三句再动手,能省不少返工:其一,这套数据和我的部署现场(通道、噪声、口音)像不像?其二,我拿来测试的语音会不会和训练集重叠,导致分数虚高?其三,我有没有一条统一的参考实现当对手,好让涨跌有据可依?三问都理清,那份 WER 报告才算得上有说服力。
七、几份你多半会撞上的考卷
把抽象分类落成几个名字,之后读文献才不慌。通用朗读这一脉,LibriSpeech 是英文圈最常做"打底"的集子,分多个难度桶,干净版本的分数几乎成了大家见面先报的开门数;电话语音这一脉,SWITCHBOARD 用真实电话信道、大段自然对话,考验模型在劣化信道和口语慌乱下的耐心;会议远场这一脉,常见的是多说话人混录、带混响与麦克风阵列拾音的数据,专测鲁棒性;中文这一脉,AISHELL 覆盖多种口音和较广词表,常被中文产品拿来做落地前的摸底考。
这些名字未必都要亲自跑,但你要能一眼看出某篇论文里"报的分数是在哪类集子上测的"——是干净朗读还是嘈杂电话,含金量天差地别。读表时先定位难度轴,再解释数字,次序反了你很容易被一个漂亮但没代表性的数带偏。
八、给自己的测试集立三条卫生规矩
除了挑好公开考卷,自建领域集也要守三条卫生规矩,否则你量出来的"领域分数"自己都不敢信。一是留出法要干净:测试语音与训练语音不能来自同一录音会话,否则等于开卷。二是难度要分层:别把三十秒的静读和嘈杂地铁里的短句混一个平均,分开报才能知道病根在哪。三是固定一套基线:换模型、调参数都拿同一套参考实现对照,数字才有"涨了"与"跌了"的说服力。三条规矩不复杂,却最容易被急着看数的人跳过。把它当成一份"量体温前先校准体温计"的自觉,你的每次报告才经得起别人复算,而不是数字一交出去就无据可查。
九、分数对不上先别怨模型,先怨口径
两种常见错觉最坑人:一是拿自己私下拼的脱壳数据和别人公开的 WER 直接比,忘了人家也许不动归一化、你动了;二是跨语言比,拿中文 CER 跟英文 WER 去对数字,单位不同自然对不上。凡是觉得某份基准低得离谱或高得不实,先回到口径层核对:用什么单位、切不切分、归一化改了没有。口径一致,数字才谈得上可比;口径一乱,再大的功劳也会被一笔冤枉账抹平。
本节要点回顾
- 公开考卷:提供可比尺,但别在它上面追漂亮数。
- 四类数据:朗读测基础、电话测劣化、远场测鲁棒、中文测口音同音。
- 双层验证:公开基准验基础,领域数据验落地,缺一不可。
- 三大误区:只看一个数、开卷测试、无基线。
- 规范报告:来源、重叠、难度、指标,全写清才算数。
最后一节,把整套流水间开一张"疑病症诊断表":从波形到文字,一路的坑怎么查、怎么调。