5.1 识别评估指标 WER 与 CER
5.1 识别评估指标 WER 与 CER
识别成品到底好到什么程度,得放上一杆公平的尺子。WER 把识别句和参考句做编辑距离对齐,数出"该说对却没说对"的词占多少。中文当下更爱用字级错误率 CER,因为中文以字为基本度量单位。本节亲手把这条公式一步步算出来,并讲清它的脾气与各种变体。
学完能干什么
- 能写并解释 WER 的公式(插入、删除、替换之和除以参考词数)。
- 能手动为一句简单对白算 WER。
- 能说明 CER 与 WER 的差异,以及为什么中文常用 CER。
- 能识别 WER 的局限,如对停用词与长句不公等。
一、编辑距离与 WER 的三类错误
度量"识别结果离参考有多远",用编辑距离:把识别句改写成参考句,最少需要几次"替换、插入、删除"。这三类操作各出现多少次,就是 WER 的原料。WER = (替换 + 删除 + 插入) ÷ 参考句词数,再乘 100%。替换是明明该说这个词却说了旁的,删除是该说的没说出来,插入是多说了不该说的。
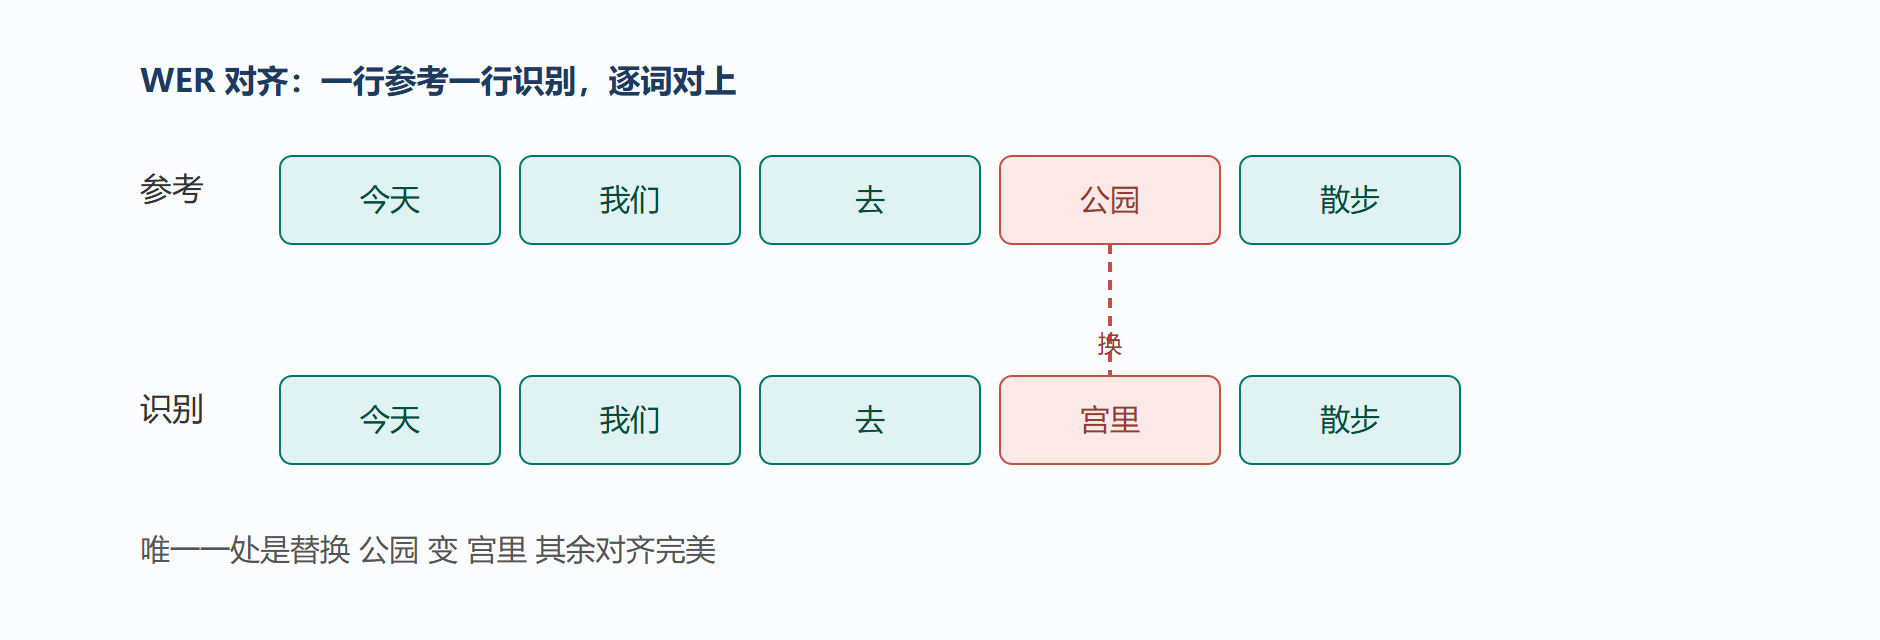
一字一句对白示例 参考:今天 我们 去 公园 散步 识别:今天 我们 去 宫里 散步 替换 1 次 → 其余全对 WER = 1 ÷ 5 = 20%
上面这五行告诉你 WER 是怎么一步步算出来的——一对参考/识别句,只有 1 个词被换,WER 就是 20%。
编辑距离对齐示例
二、为什么中文偏爱 CER
中文的一个词往往是好几个字拼成,词表切分不免引入分词错误,把分词错误算进 WER 会加倍冤枉。因此中文社区偏爱字级指标 CER:把"字"当作基本单位,一个字换错就计一个字错,天然绕开了分词歧义的雷区。CER 与 WER 的分子算法一致,只是换了分母单位。英文里词有天然空格分隔,WER 更顺眼;中文以字打底,CER 更合理。选择哪种,看的是语言自身基本粒子的切分成本。
三、WER 的脾气与盲区
WER 很好用,却也会骗人:
- 对停用词不公:错一个"的"和错一个关键名词同样计错,前者其实无伤大雅。
- 对长句不公:一句长句错一个词和一句短句错一个词,绝对值一样,相对质感却不同。
- 忽略语义:它根本不管"字面一样,意思对不对"这码事——半句话对、半句话颠倒,分数可能一样低。
所以报告 WER 时,别只给一个大数,最好分难度段、分说话人、分话题各给一个数,才能真看出一台流水哪儿软。
四、三种错误混在一起怎么算
上面的例子只出现一次替换,太简单,来一例混合错误。参考与识别各一句话:
参考:我 明天 上午 去 开会 识别:我 明晚 上午 去 开会 了吗 先对齐: 我↔我(对) 明天↔明晚(替换 1) 上午↔上午(对) 去↔去(对) 开会↔开会(对) 参考结束,识别多出“了吗” (插入 1) 合计:替换 1 + 插入 1 = 2 WER = 2 ÷ 5 = 40%
注意删除同样会加进分子:若识别句漏掉"参考:我 明天 上午 去 开会"里的"明天",那就再添 1 次删除。三类错误加起来再除以参考词 5,就是 WER。这个分子分母一记牢,报告中"提高了两个点"到底提高在哪,心里就有数了。
五、给 WER / CER 选一把合身的尺
| 指标 | 单位 | 什么时候更顺眼 | 易踩的坑 |
|---|---|---|---|
| WER | 词 | 英文等空格分词自然 | 分词本身会引入误差 |
| CER | 字 | 中文、日韩等字本位 | 不看分词、纯字对齐 |
一句话:中文报 CER 更公平,英文报 WER 更顺手,两者分子算法同源、只换分母单位。若你手上同时有中英双语料,理清"单位不同所以数字不可直比"这点,能避免把中文 CER 当英文 WER 拿去横向比较的笑话。
六、动手之前,先做三件"对齐之外"的小事
正式计算 WER 之前,还有三件常被忽略、却直接影响数字可信度的小事:一是归一化,二是切分口径,三是取多长的一句话去比。
先说归一化。真实语音转写里,识别结果和参考常常在大小写、标点、数字写法上对不上。"我昨天去了 Beijing" 与 "我昨天去了 beijing",分词系统认为是同一个意思,可字符串对齐却可能把它当成一两处错误。所以正式验证时,通常先把两边都做统一的归一化——小写化、去掉标点、把数字统一成同一种写法——再拿归一化后的文本去算 WER。不做这步,你的 WER 会被"格式不一致"这类与识别能力无关的因素污染,报出来的数虚高,还难跟别人比。
再说切分口径。同样的句子,用词粒度切分还是用句粒度切分,得到一个词错在分子、占的分母不同,结果也不一样。不同团队的 WER 之所以常常"不可比",一大半是藏在口径里:有人按词、有人按字符,有人把数字展开成读音、有人保留原样。所以报数时一定要附上"这一版口径是怎么切的",否则别人拿你的 8% 毫无意义。
最后是句子长度。WER 是一个总体的平均,它对"长句和短句混在一起"不敏感——两句都是 50% 错的句子,合起来看可能显得不那么糟。稳妥的做法是把测试集按句子长度、语速、说话人分组,分别报 WER,再看哪一组拖了后腿。这样报告里才是"哪段难、难在哪"的可迁移信息,而不只是一大锅烩出来的平均分。
七、WER 之外,你还该报什么
一个系统好用与否,WER 只是门面,落地时往往还要配另外几个数一起看。其一是置信度:模型对自己那句答案到底有几分把握,很多下游(如要不要让人复核)都是靠它来做的;WER 是个事后统计,置信度才是事中可用来做决定的。其二是召回与精确的某种变体:一句到底有没有被完整捕捉到,对"触发式"应用比平均 WER 更重要。其三是延迟:说出一个字到出结果用了多久,离线评测可能看不出问题,一到实时场景就现形。
把这些数放在一起,才是一门完整的"体检报告"。单项的 WER 好看,不等于整套流水就健康——有可能它只是"割了烂尾补了头",把错误换了个地方藏。下一节我们就挑几张标准考卷,看看不同系统会拿什么公开数据集来 PK。
本节要点回顾
- WER:替换加删除加插入,除以参考词数,越小越好。
- CER:以字为单位,中文主流,绕开分词歧义。
- 手工算例:一对句子错一词,WER 20%(如上)。
- 脾与盲区:对停用词、长句、语义都不公平,别只信大数。
- 报告纪律:分难度、分说话人、分话题多给几组数。
公式有了,下一节挑几张标准考卷:评估数据集和任务基准,看看各大系统都是拿什么互相 PK 的。