1.2 为什么值得迁移:数据稀缺与算力账本
1.2 为什么值得迁移:数据稀缺与算力账本
本节摘要:迁移学习的价值不是口号,是可以算出来的账。本节从数据、算力、时间、性能四个账户分别记账,给出一张收益来源对照表,并用可复算的代码估算"从零训练与迁移微调"在样本量与浮点运算量上的数量级差距,最后划出迁移不划算的反例场景——账本上明确写着"何时不该省"。
从一笔真实开销说起
训练一个在 ImageNet(约一百二十八万张标注图像、一千类)上达到先进精度的视觉模型,公开论文报告的开销通常是几百到几千张 GPU 天。即使退一步,只训练一个 ResNet-18 级别的模型到七成出头的精度,单卡也要跑上一两天。而绝大多数实际项目的标注预算,是几百到几千张图。用两百倍于预算的数据才能喂饱的施工方案,等于图纸画得再漂亮也开不了工。
迁移学习把这笔账改写成:别人出钱打的 地基(预训练权重)免费或低成本拿过来,你只出目标任务的局部施工费。
四个收益账户
| 收益账户 | 从零训练 | 迁移微调 | 差距来源 |
|---|---|---|---|
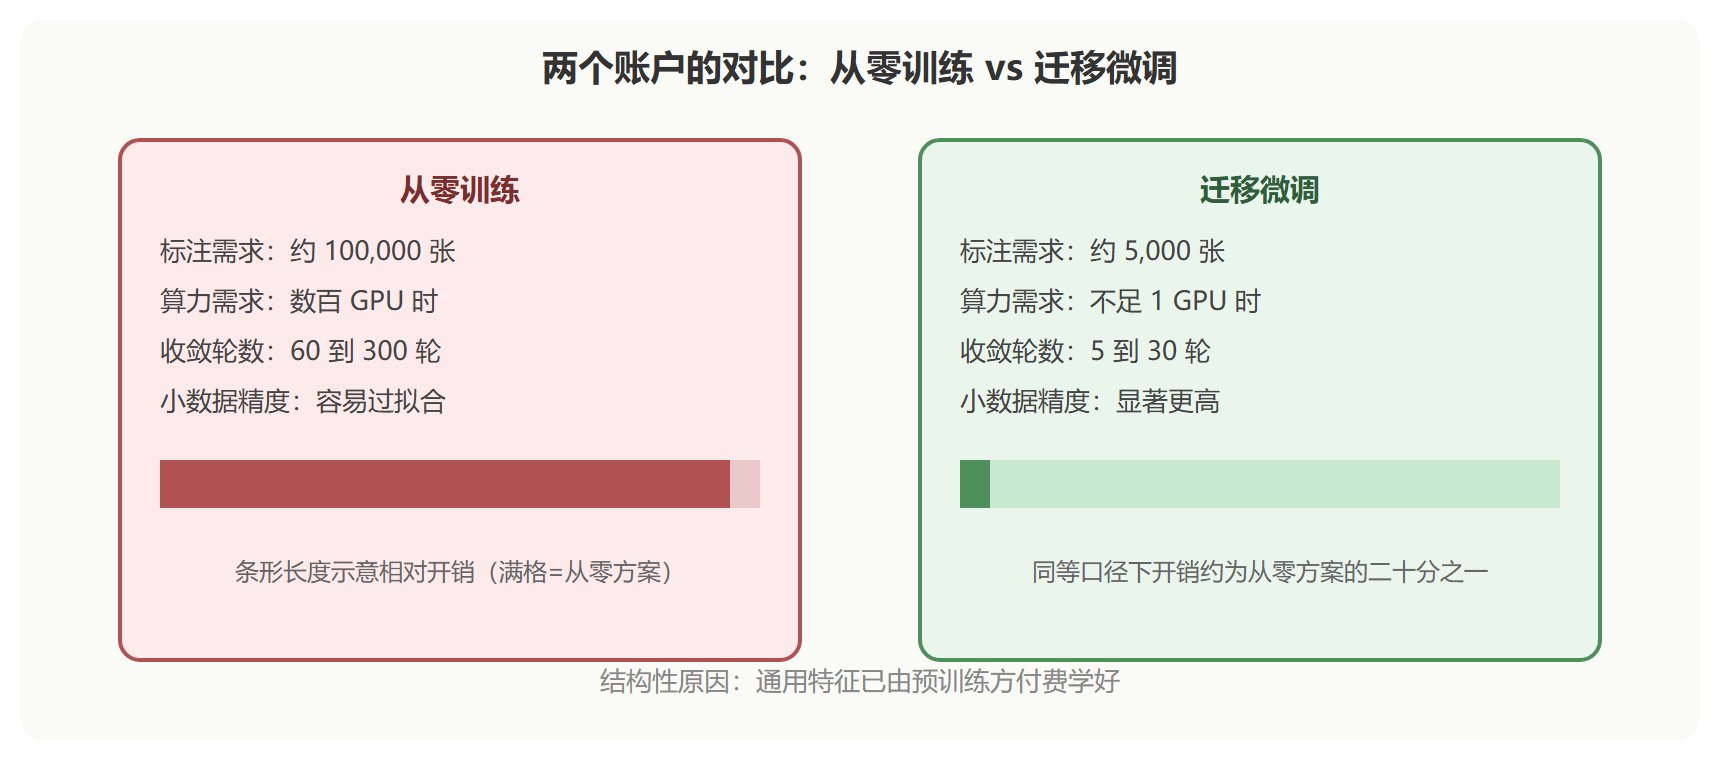
| 标注数据 | 百万级 | 数百到数万 | 通用特征已在大数据上学好 |
| 算力 | 数百 GPU 时起步 | 不足一 GPU 时常够用 | 大部分参数不更新或小步更新 |
| 收敛时间 | 数十至数百轮 | 数轮到数十轮 | 起点离最优解近 |
| 目标精度 | 小数据下易过拟合 | 通常显著更高 | 预训练充当了隐式正则 |
第四行最容易被忽略:预训练不仅是省钱的手段,在小数据上它往往还是"唯一能到那个精度"的手段。业界流传的经验数字——在小型数据集上,预训练加微调相对从零训练的精度提升常在十到三十个百分点量级——后面第 5 章的工地实录会亲手复现这种差距。
算力账:浮点运算量的量级对比
口说无凭,用 PyTorch 自带的计算量统计思路手算一遍。以 ResNet-18 为例,一次前向传播的计算量约十八亿次浮点运算(这是论文与框架文档一致的公开数字)。从零训练需要跑完整个数据集很多轮,而特征提取式的迁移训练只需要前向传播骨干网络(不反传),只训练最后的分类头。
import torch import torch.nn as nn from torchvision import models model = models.resnet18() head = nn.Linear(512, 10) # 迁移方案:只训练这个新分类头 n_backbone = sum(p.numel() for p in model.parameters()) n_head = sum(p.numel() for p in head.parameters()) print(f"骨干参数量: {n_backbone:,}") # 输出: 11,689,512 print(f"新分类头参数量: {n_head:,}") # 输出: 5,130(512*10 + 10 偏置) print(f"可训练占比: {n_head / n_backbone * 100:.3f}%") # 输出: 0.044% # 反向传播的计算量约为前向的两倍,且只对参与训练的子图生效 # 特征提取模式:骨干只前向不反传,训练一个样本的计算量比例约为 # 前向(骨干+头) : 反传(仅头) ≈ 1 : 2*(头占比) —— 骨干反传这大头被整块省掉
可训练参数占比百分之零点零四,这是"只装修门面"模式的账面:优化器状态、梯度存储、反传计算几乎全部消失,显存占用也随之骤降。全量微调介于两者之间,账目方式相同,只是可训练占比回到百分之百。
再算数据账。假设目标任务有五千张标注图,单张标注成本按行情人民币几元到几十元不等:
# 数据账:达到相近效果所需的标注量对比(经验量级) from_zero_images = 100_000 # 从零训练达到可用精度约需十万张量级 transfer_images = 5_000 # 迁移微调五千张已可训练出可用模型 label_cost = 5 # 每张标注成本(元),取保守低值 cost_zero = from_zero_images * label_cost cost_transfer = transfer_images * label_cost print(f"从零方案标注预算: {cost_zero:,} 元") # 输出: 500,000 元 print(f"迁移方案标注预算: {cost_transfer:,} 元") # 输出: 25,000 元 print(f"节省比例: {(1 - cost_transfer / cost_zero) * 100:.0f}%") # 输出: 95%
九成五的标注开支省下来,这就是工程队默认优先考虑旧宅改造的原因。数字本身随行情浮动,但数量级差距稳定——它来自"通用特征已经被别人付费学好了"这个结构性事实。
收益来源示意图
什么情况下迁移不划算
账本也有负数页,诚实列出来:
- 目标与源毫无关系:比如用自然图像模型迁移到纯音频频谱图以外的信号处理任务,收益趋零甚至为负(负迁移,第 6 章详述)
- 目标数据极大且算力充足:预训练起点的隐式偏置反而可能限制上限,大厂旗舰模型常从零训练或做持续预训练
- 极端延迟约束的端侧部署:如果迁移后模型过大撑不起延迟,可能要走蒸馏、剪枝路线而非微调
⚠️ 常见坑:把"省算力"当成迁移的唯一动机,在数据充足的场景也拒绝从零训练。账要两边算:数据够、卡够时,从零训练或继续预训练常是更优解。
常见疑问解答
问:几百张图的"少"和几万张的"多",分界线到底在哪? 没有绝对分界,但有个可操作的手感:看模型参数量与样本量的比值(第 3.3 节展开)。同一架构下,样本量涨十倍,你能负担的可训练参数量大约也能涨一个量级——分界线随模型大小移动,而不是固定数字。
问:迁移来的模型会不会继承预训练数据的偏见? 会。预训练语料的性别、地域、语言分布偏差会随权重一起搬进你的项目。医疗、招聘、风控这类敏感场景,验收清单里必须加子群体公平性检查(第 6.3 节),这是迁移"免费搭车"的隐性账单。
问:收益会不会随时间贬值? 会。预训练权重的价值依赖源任务的通用性,当领域专用模型越来越易得,通用源的相对优势被稀释。工程上的对策是保持选型记录(第 3.3 节)的更新节奏,每年重走一次选宅四关,确认现有源仍是性价比最优。
本节要点回顾
- 四个收益账户:数据、算力、时间、性能,其中性能账户在小数据场景最关键
- 量化手感:特征提取模式下可训练参数可低至全模型的百分之零点几,反传开销同比例缩减
- 数据账示例:十万张与五千张的标注预算差二十倍,结构性原因是通用特征已被预训练方付费
- 反面清单:领域无关、数据算力双足、极端延迟约束三种场景下,迁移未必划算
- 本节位置:向上承接概念定义,向下引出具体的微调工序(下一节)