- 文集信息
- 目录大纲
- 最新文档
- 知识宇宙
文集详情
文集导读
教程导读
一句话定位:这是一支"旧宅改造工程队"的施工手册——把预训练模型当成买来的旧宅,用迁移学习和 Fine-tuning 的手艺,把它改造成适合你家任务的新房。
手上只有几百张标注图片,却想做一个能用的图像分类器,从零训练一个深度网络根本不现实——数据不够、显卡不够、时间也不够。可与此同时,大厂发布的预训练模型就在模型仓库里摆着,几百万张图片喂出来的"现成旧宅",水电完好、结构扎实,只是户型不合你的需求。推倒重建?没必要。工程队的做法是:验房、看结构、挑承重墙、局部翻新、外挂扩建、竣工验收。这套流程走下来,一套旧宅就能变成贴合新任务的工作模型。
这就是迁移学习与 Fine-tuning 的日常:不问"怎么从零造模型",只问"怎么把现成的模型改到能用、好用"。本教程用旧宅改造的行话把这件事从头到尾讲透——冻结的层是不动的承重墙,微调是局部翻新,适配器是外挂扩建,蒸馏是搬家瘦身,每一步都有对应的验收标准。
这个教程解决什么问题
深度学习落地时最常见的困境不是"模型不够先进",而是"资源不够挥霍"。标注数据稀缺、算力预算有限、上线时间紧,这三样占全了任何一样,从零训练就不再是选项。迁移学习给出的答案很朴素:让已经在大数据上学过通用特征的网络,把底子带过来,你只负责改造上层结构。
围绕这条主线,本教程覆盖了完整的施工链条。先讲清楚迁移学习与 Fine-tuning 各自指什么、边界在哪,避免把两个词混着用;再评估"承重结构"——源域与目标域差多远、迁移是否可行、该用特征迁移还是实例迁移;然后进入选宅环节,比较视觉与语言两边的预训练模型,讲选择标准与获取渠道;接着是本教程的重头戏,翻新施工:全量微调、特征提取、层冻结三种模式怎么选,输出层怎么换,适配器怎么外挂,学习率与优化器怎么配,训练过程怎么监理。最后安排了三个完整工地实录与一章竣工验收:负迁移这种"改造失败"怎么排查,LoRA 这类参数高效微调如何做到只动少量参数,上线前要核对哪些验收项。
每一节都按工程队的规矩写:先说为什么,再讲怎么做,最后给验收标准。代码以 PyTorch 与 HuggingFace 为主,数值示例均可复算。
适合谁读
- 有深度学习基础概念(会写训练循环、知道损失函数是什么),但没系统做过迁移学习实践的读者
- 手头数据量小、算力有限,需要用预训练模型解决实际任务的学生或工程师
- 被海量预训练模型晃花了眼,需要一套选型与施工决策流程的从业者
- 想理解层冻结、适配器、LoRA 这些"改造工艺"背后原理的技术面试备考者
学完你能做什么
- 准确区分迁移学习、Fine-tuning、特征提取、参数高效微调这些常被混用的术语
- 根据数据量与任务相似度,在"冻结全部、冻结部分、全量微调"之间做出有依据的选择
- 动手改造一个视觉分类模型:换输出层、设冻结、配学习率、监控训练并早停
- 用 HuggingFace 把 BERT 类模型微调成文本分类器,并知道每个超参数为什么这么设
- 识别负迁移的典型症状,按排查清单定位问题,而不是盲目换模型重跑
- 理解 Adapter 与 LoRA 的机制差异,能算出它们各自可训练参数量的量级
学习路线
整册的施工顺序是从验房到竣工,不建议跳章:没有结构评估就施工,是工地上最常见的返工原因。
全册知识地图
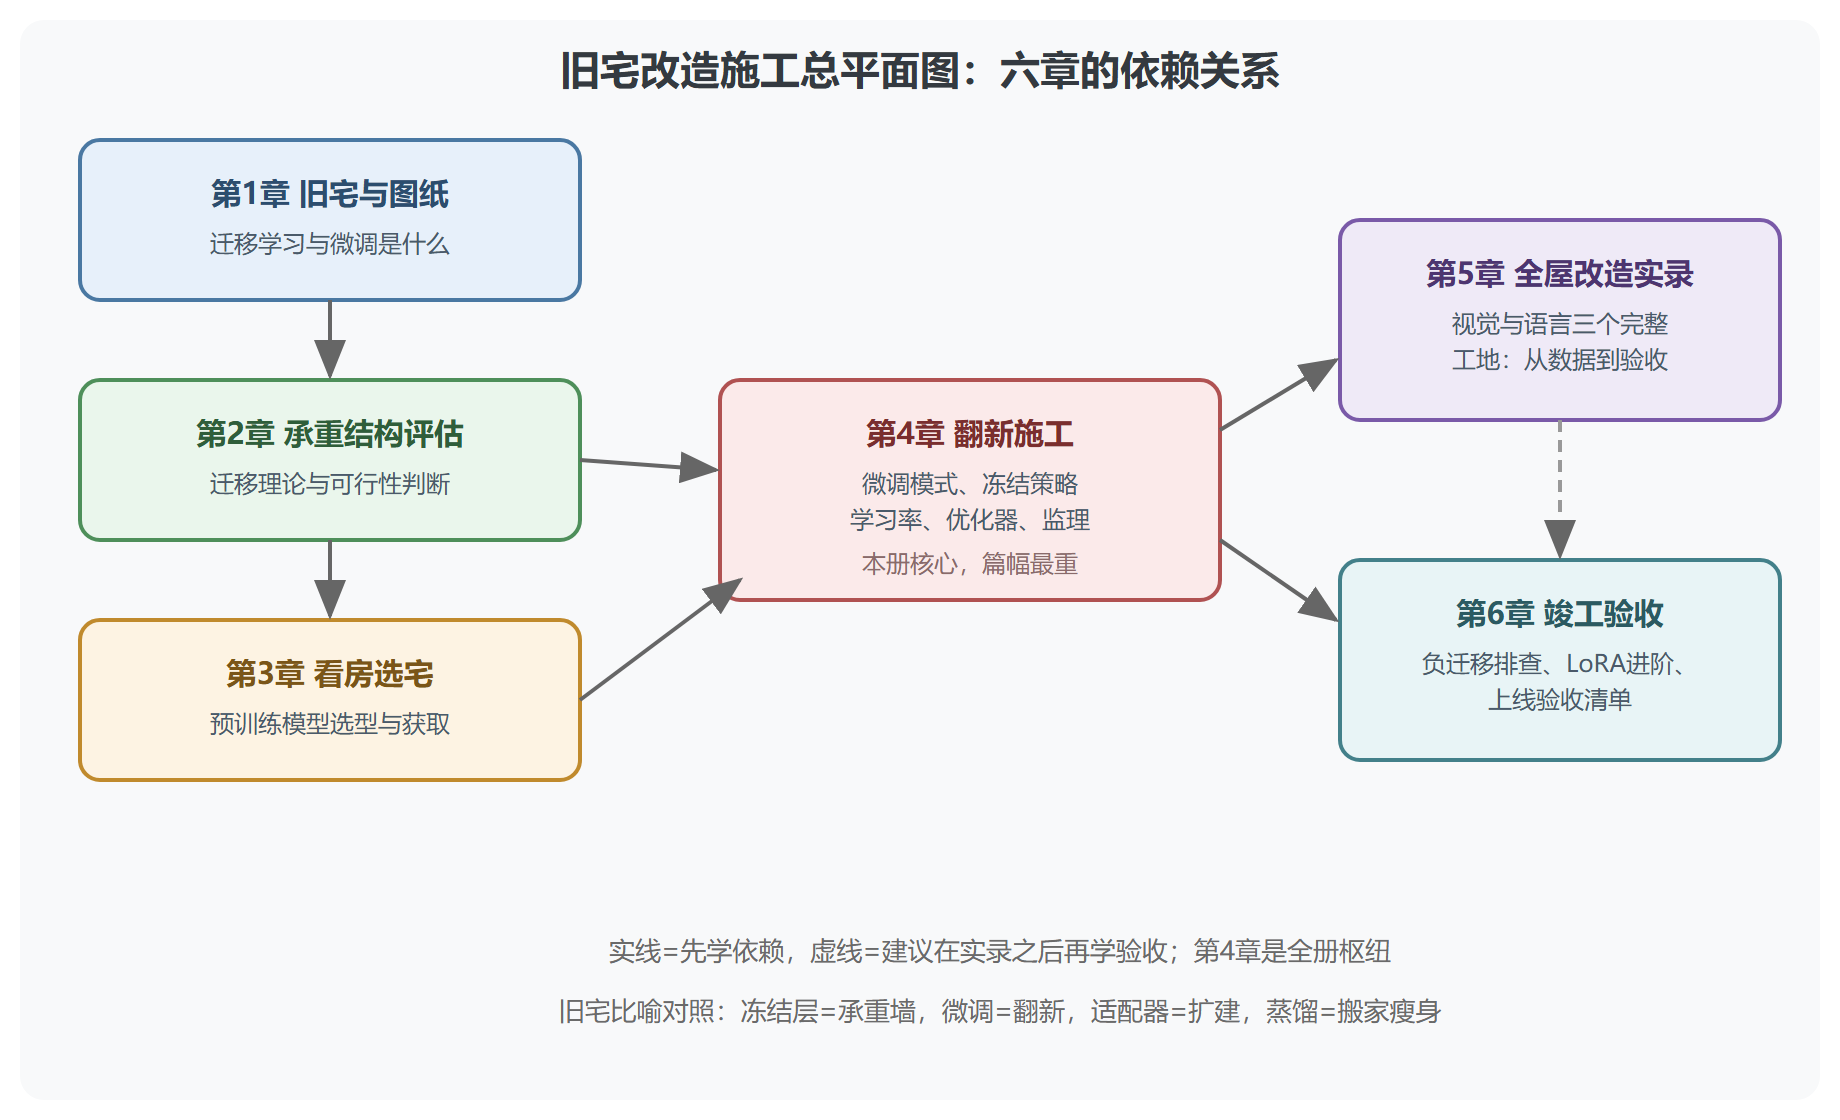
一句话总结这条路线:先认房子(概念),再验结构(理论),然后选宅(模型),接着施工(微调),最后竣工(评估与进阶)。
怎么用这个教程
建议按章顺序读,前三章偏认知,后三章偏动手。第 4 章的六节彼此咬合:模式选择决定冻结策略,冻结策略影响学习率设置,学习率又牵连优化器配置,最后由监理节收口。第 5 章的三个工地建议在读完第 4 章后一口气做完,代码可以复算,改动超参数再跑一遍,比再读一遍文字收获大。第 6 章既可以当地图收尾,也可以当排错手册随查随用。
环境方面,有一块普通显卡(显存八 GB 以上即可)就能复现大部分实验;没有 GPU 的话,第 5 章视觉部分可用 CPU 跑小规模演示,语言部分用小模型同样可行。教程中的代码基于 PyTorch 与 Transformers 库的公开接口,不含任何文件路径,直接抄进笔记本即可运行。
目录大纲
最新文档
知识宇宙
正在加载知识图谱...