1.5 图纸关键词:源域目标域与预训练模型
1.5 图纸关键词:源域、目标域与预训练模型
本节摘要:源域、目标域、源任务、目标任务、预训练模型,这五个词构成描述任何迁移项目的坐标系。本节给出每个术语的严格定义与符号记法,用三个真实项目代入演示这套坐标系的用法,并以一张总图收束第 1 章。掌握它,第 2 章的分类体系只需往坐标系上贴标签即可。
定义先行
迁移学习的文献有一套固定记法,工程队把它翻译成看房语言:
- 域:数据分布,记作二元组(特征空间,边缘分布)。通俗说,就是"房子所在的地段与户型风格"
- 源域:预训练数据所在的域,记号通常用带下标的小写字母组合表示,如"源域的样本与分布"
- 目标域:目标任务数据所在的域,即"你要住的地段"
- 源任务/目标任务:在各自域上要解决的预测任务(标签空间与预测函数)。任务是"房子的用途":自住、出租还是开店
- 预训练模型:在源域源任务上训练好的模型,即"买来的旧宅"本身
判断迁移类型时只看两件事:域同不同(分布是否一致)、任务同不同(标签空间与目标是否一致)。这正是第 2 章分类法的两根轴。
三个项目代入坐标系
空定义记不牢,代入三个典型项目:
项目甲:ImageNet 预训练的 ResNet,微调识别工厂产品缺陷(正常/缺陷)。源域=自然图像,目标域=工业相机图像;源任务=千类物体识别,目标任务=二分类。域不同(成像方式、分辨率、目标外观都变),任务不同(标签空间完全换)——这是典型的"域与任务都变",但因为视觉底层特征通用,迁移依然成立。
项目乙:英文情感分析模型迁移到中文评论情感分析。任务相同(正负情感二分类),域不同(语言、文化语境)。这属于"同任务跨域",第 2 章会看到它落在直推式迁移的格子里。
项目丙:用通用中文语言模型微调做医疗问答。源任务=掩码预测(无监督目标),目标任务=问答。域相近(都是中文文本),任务不同——几乎所有 NLP 下游微调都是这个形态,即归纳式迁移。
用代码把项目甲的坐标写清楚,顺便检查数据分布差异这一"域距离"的粗度量:
import numpy as np # 用通道统计粗略刻画两个域的分布(各抽 500 张图的均值向量) rng = np.random.default_rng(42) # ImageNet 子集的 RGB 通道均值(文献公认值) src_mean = np.array([0.485, 0.456, 0.406]) # 工业相机图像的通道均值(假设实测) tgt_mean = np.array([0.512, 0.498, 0.470]) # 源域与目标域的均值差(一种最粗的域距离度量) dist = np.linalg.norm(src_mean - tgt_mean) print(f"通道均值差的欧氏距离: {dist:.4f}") # 输出: 0.0995 # 再算马氏风格的方向差异:哪个通道漂移最大 drift = np.abs(tgt_mean - src_mean) / src_mean for ch, name in enumerate("RGB"): print(f"{name} 通道相对漂移: {drift[ch]:.1%}") # 输出: R 通道相对漂移: 5.6%, G: 9.2%, B: 15.8% # 漂移不小:工业图像更亮偏冷色调,提示微调时数据增强要保留色彩扰动
这个数字本身不决定成败,但它是工程上最快能算出来的"域距离信号"——均值都差这么多,分布差异值得认真对待,第 2.2 节的领域适应工具就派上用场。
五个术语的关系总图
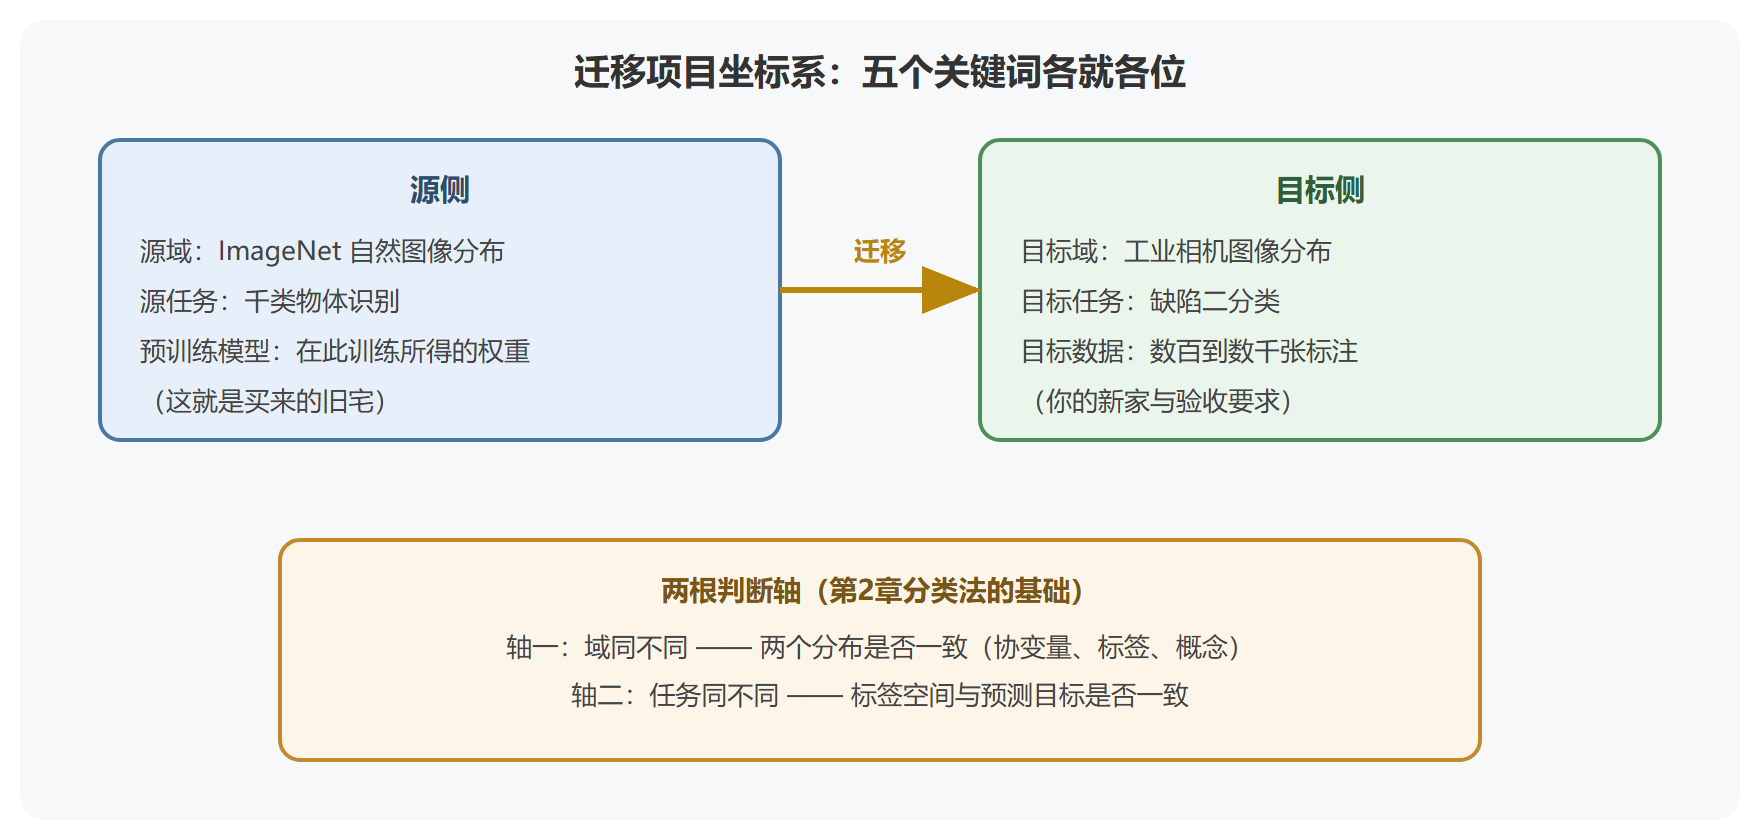
💡 关键直觉:描述迁移项目就像写租房合同——甲方(源)、乙方(目标)、标的物(预训练模型)、用途变更(任务差异),四要素写清,纠纷才好排查。
术语使用的常见错误
- 把"域"等同于"数据集":域是分布,数据集只是分布的采样。同一数据集换个采样方式仍是同域
- 把"预训练模型"当成一个点:同一个架构配不同预训练数据是不同的旧宅,许可证与偏见特性都不同
- 忽略标签空间映射:源任务千类与目标任务二类之间没有天然对应关系,换头(第 4 章)就是处理这个不对齐的工序
一个帮助记忆的小练习:拿你手头任何一个 AI 项目,用一句话写出"源域是什么、源任务是什么、预训练模型是哪个、目标域与目标任务差在哪"。写不出来的项目,迁移策略多半是拍脑袋定的。
把坐标系用到极限:三种迁移困境的术语诊断
术语坐标系的价值在困境里体现得最充分。用三个困境练一遍:
**困境一:同一个模型在训练数据上九成五、到了新医院只有七成。**用坐标系描述:目标域变了(新医院的患者构成、设备型号构成新分布),目标任务没变。诊断指向域的漂移,处方在领域适应的工具箱里(第 2.2 节),而不是继续加数据训练。
**困境二:客户要"把英文模型的能力搬到中文"。**这句话在坐标系下是歧义的——搬的是"理解能力"(任务能力迁移,需要中文预训练加微调)还是"具体知识"(如实体库,那是数据工程不是模型迁移)。术语层面问清"源域源任务分别指什么",一半的需求分歧在这里就能暴露。
**困境三:多轮迭代后模型越改越差。**回看坐标系:每一次迭代源域源任务有没有变?如果中途换了预训练版本(源侧悄悄变了)而验收只用旧基线对照,坐标已经错位,比较失去意义。版本记录(第 3.4 节)就是防止坐标系漂移的档案。
这三个困境有一个共同点:问题的第一现场都在描述层——把源、目标、任务说准了,处方空间就缩小到一两格。反过来说,大部分"模型玄学问题"的根源,是团队从没把坐标系五要素写下来过。
顺带立一个协作约定:项目文档的第一段就应该是坐标系五要素表,而不是业务背景。新成员接手项目,最快的方式不是读需求文档,而是看这张表——源在哪、目标在哪、搬什么、差多少,四行文字胜过一小时会议。本册第 5 章三个工地的开头都按这个约定写背景,可以当模板参考。
本节要点回顾
- 五词一系:源域、源任务、目标域、目标任务、预训练模型,构成迁移项目的完整描述
- 域是分布不是数据集:判断域异同要看特征空间与边缘分布,不是看文件名
- 两根轴:域同不同、任务同不同——第 2 章的归纳、直推、无监督三分法直接由这两轴生成
- 域距离可测:通道统计这类粗度量也能给出漂移信号,为是否需要领域适应提供初步依据
- 第 1 章收束:概念、动机、工序、关系、术语五节齐了,下一章带着这套坐标系去评估旧宅的承重结构