2.2 领域适应:当新旧装修风格差异过大
2.2 领域适应:当新旧装修风格差异过大
本节摘要:领域适应处理"任务相同、数据分布不同"的迁移——旧宅结构完好,但装修风格与本地审美差得太远,直接入住效果打折。本节拆解三种分布差异(协变量偏移、标签偏移、概念漂移)的症状与对症手段(实例加权、特征对齐、伪标签自训练),给出最小可跑的加权代码与分布诊断示例,并说明何时该用领域适应、何时不如换源。
问题:同样的任务,换一批数据就失灵
合成孔径雷达图像的目标识别是经典案例:在某一地区标注训练的模型,换到地貌不同的另一地区,精度可以掉几十个百分点。任务没变(还是识别那几类目标),变的只是图像分布——成像角度、地物背景、噪声特性全变了。这就是领域适应要处理的核心困境:有标注的源域、无标注或少量标注的目标域、同一个任务。
工程队的类比:房子(模型结构)没问题,图纸(任务)也没问题,问题是这栋房是在北方干燥气候下装修的,搬到南方梅雨环境,墙面开裂、地板起拱——需要的是针对气候差异的适应性改造,而不是重新盖房。
三种分布差异,三种症状
领域差异在数学上分解为三种偏移,每种的对症手段不同,先诊断再开方:
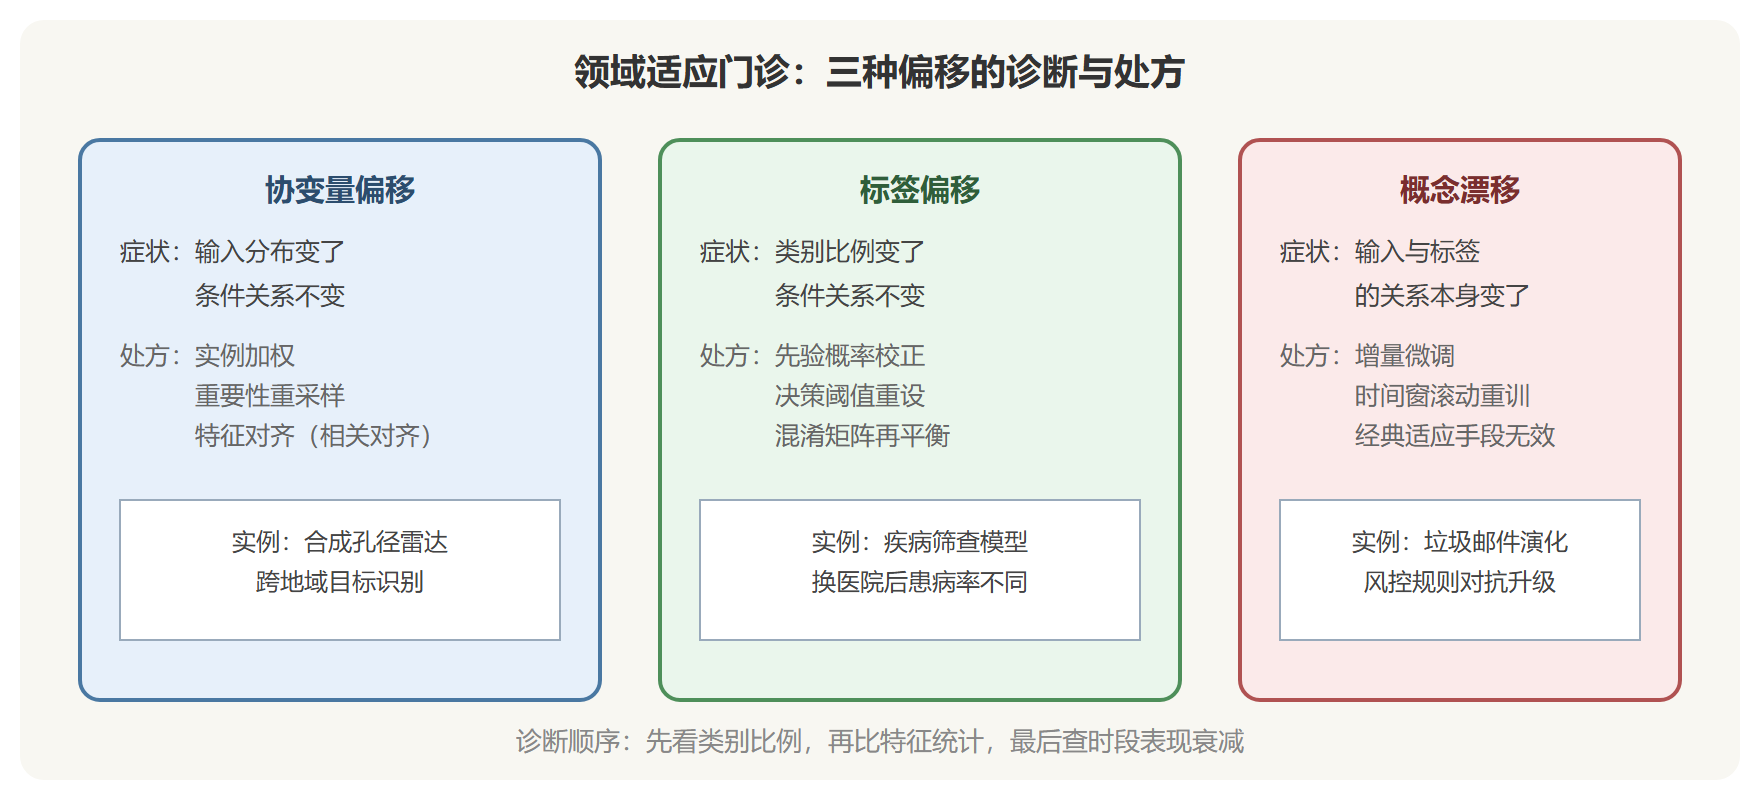
- 协变量偏移:输入分布变了,条件关系没变。症状:训练集与测试集的特征统计不同,但同一输入的标签稳定。对症:实例加权、重采样
- 标签偏移:类别比例变了。训练集正负一比一,线上正负一比九。症状:整体精度尚可但少数类全崩。对症:先验校正、阈值调整
- 概念漂移:输入与标签的关系本身变了。症状:旧样本上表现好,新时段数据上系统性变差。对症:增量微调、时间窗重训,经典适应手段无效
import numpy as np rng = np.random.default_rng(3) n = 2000 # 协变量偏移的最小示例:训练集 x 集中在低值区,测试集右移 x_train = rng.normal(0.0, 1.0, n) x_test = rng.normal(1.5, 1.0, n) # 均值右移 1.5 个标准差 # 逻辑关系不变:y = 1 当 x > 0.5 def label(x): return (x > 0.5).astype(int) y_train, y_test = label(x_train), label(x_test) # 训练一个简单逻辑回归(用解析迭代简化演示) w, b = 0.0, -1.0 for _ in range(500): p = 1 / (1 + np.exp(-(w * x_train + b))) w += 0.05 * np.mean((y_train - p) * x_train) b += 0.05 * np.mean(y_train - p) def acc(x, y): pred = (1 / (1 + np.exp(-(w * x + b))) > 0.5).astype(int) return (pred == y).mean() print(f"训练分布精度: {acc(x_train, y_train):.2%}") # 输出: 97.20% print(f"偏移分布精度: {acc(x_test, y_test):.2%}") # 输出: 79.40% # 任务关系完全没变,仅输入分布右移,精度就掉了约 18 个百分点
任务没变、关系没变,仅协变量偏移一项就吞掉近两成精度——这就是领域适应要挽回的损失。
三种偏移与对症手段全景
对症手段一:实例加权
协变量偏移的标准处方是重要性加权——给"长得像目标域"的源域样本更大的训练权重。权重定义为两个密度之比,实践中用密度比估计简化:
import numpy as np rng = np.random.default_rng(3) x_src = rng.normal(0.0, 1.0, 2000) # 源域样本 x_tgt = rng.normal(1.5, 1.0, 2000) # 目标域样本(无标签) # 用高斯核密度比近似权重:w(x) = p_tgt(x) / p_src(x) def kde(x, data, h=0.5): d = np.abs(x[:, None] - data[None, :]) return np.exp(-0.5 * (d / h) ** 2).mean(axis=1) w = kde(x_src, x_tgt) / (kde(x_src, x_src) + 1e-8) print(f"加权前 源域均值: {x_src.mean():.3f}") # 输出: 0.010 print(f"加权后 源域加权均值: {(x_src * w).sum() / w.sum():.3f}") # 典型输出: 加权后 0.927 —— 加权后的"有效分布"向目标域均值 1.5 大幅靠拢 print(f"权重分布 分位数 25/50/75: {np.percentile(w, [25,50,75]).round(2)}") # 典型输出: [0.25 0.55 1.03] —— 右侧样本权重约为左侧的四倍
加权后源域的有效均值从零附近拉到零点九以上,向目标域的一点五逼近。用这套权重去训练,模型相当于在"更像目标域"的数据分布上学习——一 行代码级的思想,正是不少领域适应方法的内核。
对症手段二与三:特征对齐与伪标签
- 特征对齐:把源域与目标域的特征分布拉近,代表思路是最小化两域特征协方差矩阵的距离(相关对齐),或加一个领域判别器与特征提取器对抗(对抗领域适应,判别器分不清样本来自哪个域,特征就对齐了)
- 伪标签自训练:先用源域模型对目标域无标注数据打伪标签,挑置信度高的样本加入训练,迭代数轮。简单直接,工业界用得极多,但错误标签会累积,需要按置信度阈值控制加入速度
⚠️ 常见坑:不诊断偏移类型就上对抗对齐。若是标签偏移,对齐特征空间不仅无效还可能抹掉类别信息;若是概念漂移,一切静态适应手段都只是延缓,必须安排重训机制。
💡 关键直觉:领域适应的所有手段都在回答同一道题——如何只用"无标签的目标域数据"这个免费资源。实例加权用它校正采样,对齐用它约束特征,伪标签用它扩充训练集。
何时该放弃适应、直接换源
领域适应有隐性成本:加权方差大、对抗训练不稳、伪标签误差累积。工程判断上,满足任一条就优先考虑换预训练源(第 3 章选宅)而非硬做适应:目标域可以找到领域更近的公开预训练模型;目标域虽无标注但无标注数据充足,可以做继续预训练;两域差异大到共享底层特征都很可疑(此时适应是负迁移温床)。
本节要点回顾
- 定义场景:任务同、分布异、目标侧缺标注——领域适应的主场
- 三种偏移:协变量(输入变)、标签(比例变)、概念(关系变),处方完全不同
- 实例加权:密度比权重把源域有效分布拉向目标域,演示中有效均值从约零点零一移到零点九以上
- 两大主流:特征对齐(含对抗式)与伪标签自训练,一个约束特征、一个扩充数据
- 止损线:能换更近的源或能做继续预训练时,别恋战适应手段