3.3 选宅标准:为任务挑预训练模型的考量
3.3 选宅标准:为任务挑预训练模型的考量
本节摘要:选预训练模型的四问清单——领域近不近、规模配不配、预算够不够、许可证准不准。本节把四问展开成可执行的决策流程,用一个医疗文本分类的选型实例完整走一遍(含成本估算代码),并给出"选错房源"的三种典型症状,帮你在开工前就避开第 6 章的事故。
四问清单
打开模型仓库,排行榜上密密麻麻。工程队的做法是按固定顺序过四道关,任何一关不过就淘汰:
- 第一问:领域近不近。预训练数据的领域与目标域的距离,直接决定第 2 章误差界里的"差异项"。通用模型对比领域模型:法律文本任务上,经过法律语料续训的通用架构通常优于纯通用模型
- 第二问:规模配不配。模型规模要与目标数据量、任务复杂度匹配。几万条标注配十亿参数是"小马拉大车"式过拟合;百万条标注配微型模型则是浪费数据
- 第三问:预算够不够。显存要装得下训练态(参数、梯度、优化器状态三份开销),推理延迟要满足上线约束
- 第四问:许可证准不准。商用限制、来源披露要求、衍生模型义务,商用项目这一票否决
选宅决策流程图
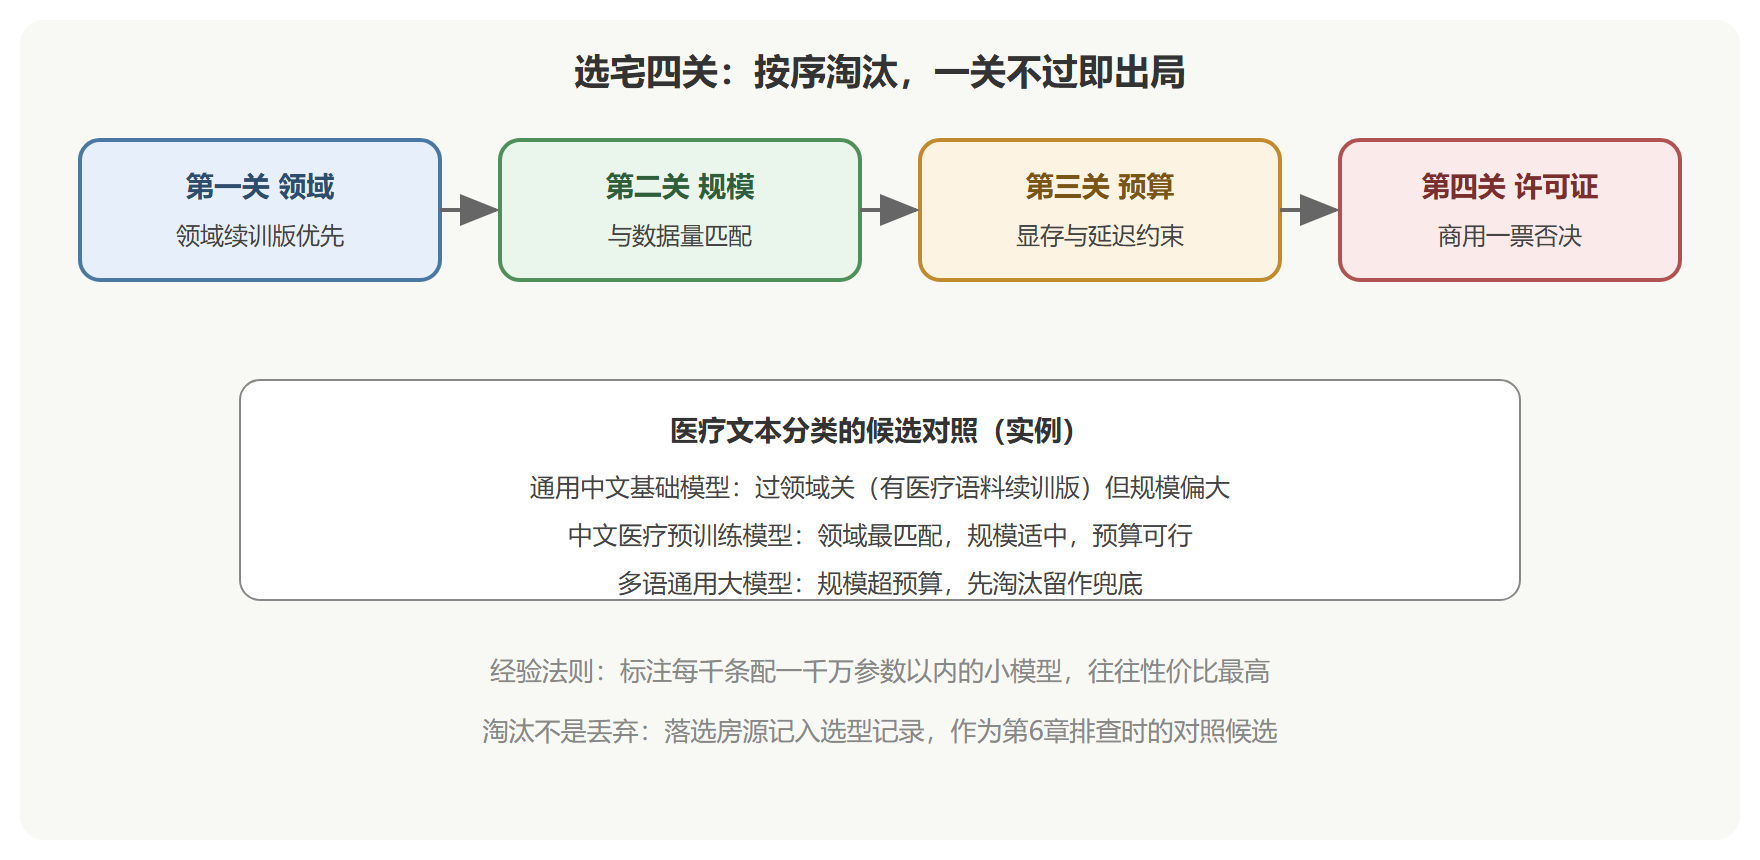
选型实例:医疗文本分类
任务设定:医疗问答文本的规范/不规范二分类,标注约两万条,团队有一张二十四 GB 显存的卡,要求商用部署。走四关:
# 第三关的成本估算:训练态显存粗算(混合精度) def train_mem_gb(n_params, mixed=True): bytes_per = 2 if mixed else 4 # 参数 grad = bytes_per # 梯度与参数同宽 opt = 8 if mixed else 8 # Adam 状态约 8 字节/参数 activations = n_params * 1e-3 * bytes_per # 激活粗估 total_bytes = n_params * (bytes_per + grad + opt) + activations return total_bytes / 1024**3 candidates = { "中文医疗模型 约1.1亿参数": 110e6, "通用大模型 约70亿参数": 7e9, } for name, n in candidates.items(): print(f"{name}: 训练态约 {train_mem_gb(n):.1f} GB") # 输出: # 中文医疗模型 约1.1亿参数: 训练态约 1.6 GB # 通用大模型 约70亿参数: 训练态约 101.6 GB # 24GB 单卡全量微调:大模型直接出局,除非走 LoRA(第6章) # 第二关:规模与数据量匹配度 n_train = 20_000 for name, n in candidates.items(): ratio = n / n_train print(f"{name}: 参数/样本比 {ratio:.0f}") # 输出: # 中文医疗模型: 参数/样本比 5500 # 通用大模型: 参数/样本比 350000 # 经验区间:1e3~1e4 为舒适区,超过 1e5 若无强正则风险高
四关结论:中文医疗预训练模型(亿级参数、领域续训、许可证允许商用)胜出;通用大模型因预算关出局,但记入选型记录——若后续 LoRA 预算允许,可作升级候选。整个决策十分钟,比盲目试三个模型各训两天划算得多。
选错房源的三种症状
选型失误不会立刻暴露,症状通常在训练与验收阶段显现,提前认识它们:
- 症状一:领域距离过大。特征提取基线精度贴近随机,微调后训练精度高验证精度低且早停很早触发——旧宅户型根本不合,翻新救不了
- 症状二:规模超配。训练损失降得飞快、验证曲线剧烈震荡、换随机种子结果大幅波动——房子太大而家具太少,过拟合的典型形态
- 症状三:许可证踩线。技术上一切正常,法务评审时才发现衍生模型必须开源或禁止商用——工程全对,商业全错
⚠️ 常见坑:只用排行榜分数选模型。榜单任务的领域、数据量、评测口径与你的项目几乎从不一样,榜单名次只说明"它在榜单任务上强"。
三个完整选型案例
清单会用才算会,补三个不同形态的案例:
**案例甲:学术论文情感分析(万条标注,学术卡)。**领域关:通用模型对论文语体的领域距离中等,但有科学文本预训练版本可用,选它;规模关:万条标注配亿级参数在舒适区;预算关:单卡训练半天可承受;许可证关:所选科学文本模型允许商用。结论:领域版胜出,通用版留作对照。
**案例乙:实时车道线检测(部署在车载芯片)。**领域关:自动驾驶领域有专用预训练模型;但效率关(本例在第三关前置为硬约束)——车载芯片的算力与延迟预算直接排除大模型,候选收缩到轻量系;最终在轻量系里选领域最近的一个,必要时用领域数据继续预训练补领域性。启示:约束的优先级由业务定,硬约束可以提前到第一关。
**案例丙:小语种新闻分类(语种稀缺)。**领域关几乎无解——该语种的预训练模型不存在;对策是选多语预训练模型(语种覆盖含目标语种),相当于"在多城市住过的旧宅";规模关按数据量选小档;若效果仍不足,用该语种的无标注新闻做继续预训练补一课,再进微调。启示:四关都过不了时,改造房源(继续预训练)也是选项,不必死磕现成模型。
三个案例合起来的元规则:四关是框架不是教条,硬约束可以前置,房源可以改造,但每一步淘汰与补救的理由都要写进选型记录。
再补一个团队协作视角:四关清单最好由两个人分别过一遍——工程师关心前三关,法务或负责人守第四关。许可证的坑往往出现在技术侧全绿、商务侧失守的时刻,而那时训练预算已经花掉了。选型评审会上,第四关没有明确结论的项目应当视同"未通过",这是用流程把商业风险挡在算力支出之前。
💡 关键直觉:选型记录比选型结果更值钱——每轮淘汰理由写下来,三个月后排查问题或数据涨了要换模型时,这份记录就是现成的决策链。
本节要点回顾
- 四关清单:领域、规模、预算、许可证,按序淘汰,第四关一票否决
- 成本粗算:混合精度下训练态显存约为参数量的十四倍字节(参数加梯度加优化器状态),两万条标注配亿级参数在舒适区
- 参数样本比:千到万为舒适区、超十万需强正则,是规模匹配的快速手感
- 三种失误症状:领域不符(基线贴随机)、规模超配(验证震荡)、许可证踩线(法务返工)
- 本节位置:选宅标准已立,下一节解决最后一步——怎么把选中的宅子合法地搬回家