4.1 三种施工模式:特征提取、层冻结与全量微调
4.1 三种施工模式:特征提取、层冻结与全量微调
本节摘要:施工模式的选择由两个变量决定——目标数据量与源目标领域距离。特征提取(冻结全部、只训新头)适合数据极少的相似任务;层冻结微调(冻结浅层、训深层加新头)适合数据中等的常规场景;全量微调(全部可训、小学习率)适合数据充足或领域差异大的场景。本节给出决策矩阵与各模式的完整代码形态,并用参数量与预期增益的对照表收尾。
工地上的第一道选择题
工程队进场,班组长问的第一句话永远是:"这活儿做到什么程度?"微调工地同样如此。三种模式不是精度从低到高的简单排序,而是三种不同的风险收益结构:
- 特征提取:整栋旧宅上保护罩,只在外面接一个新门厅。训练快、稳、省,但天花板被源特征锁死
- 层冻结微调:浅层承重墙不动,翻新上层房间加新门厅。平衡之选,是数据中等时的默认模式
- 全量微调:整栋翻新但小步慢行。上限最高,但数据不足时最容易把房子改塌(过拟合)
import torch import torch.nn as nn from torchvision import models def trainable_report(model, name): n_train = sum(p.numel() for p in model.parameters() if p.requires_grad) n_all = sum(p.numel() for p in model.parameters()) print(f"{name}: 可训练 {n_train:,} / {n_all:,}({n_train/n_all:.2%})") return n_train # 模式一:特征提取 m1 = models.resnet18() for p in m1.parameters(): p.requires_grad = False m1.fc = nn.Linear(512, 10) t1 = trainable_report(m1, "特征提取") # 模式二:层冻结微调(冻结 layer1/layer2,放开 layer3/layer4 与新头) m2 = models.resnet18() for p in m2.parameters(): p.requires_grad = False for name_mod in ["layer3", "layer4", "fc"]: mod = dict(m2.named_children())[name_mod] for p in mod.parameters(): p.requires_grad = True m2.fc = nn.Linear(512, 10) t2 = trainable_report(m2, "层冻结微调") # 模式三:全量微调 m3 = models.resnet18() m3.fc = nn.Linear(512, 10) t3 = trainable_report(m3, "全量微调") # 输出: # 特征提取: 可训练 5,130 / 11,231,130(0.05%) # 层冻结微调: 可训练 9,514,506 / 11,231,130(84.71%) # 全量微调: 可训练 11,231,130 / 11,231,130(100.00%)
三种模式的学习率也要配套:特征提取的新头可以用常规学习率(如千分之一),层冻结与全量的可训练骨干要降到十分之一以下(如万分之一)。学习率细节是 4.4 节的主场。
决策矩阵:数据量乘领域距离
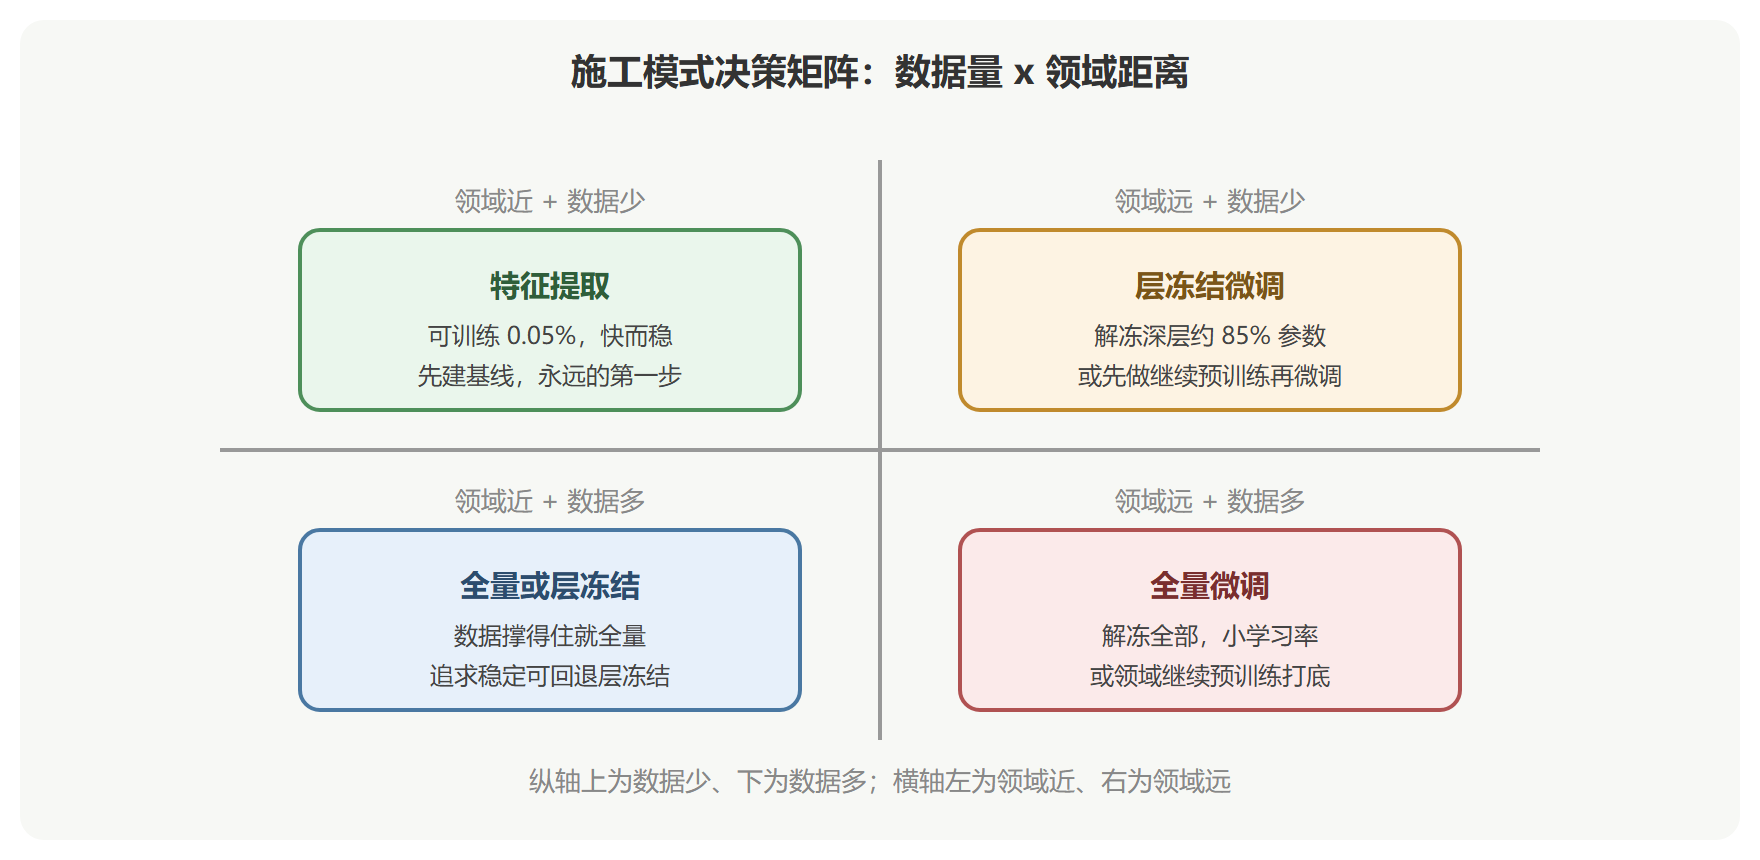
数据量的粗刻度(视觉任务经验值):每类样本低于一百张算极少,几百到几千算中等,上万算充足。领域距离用第 2 章的工具判断:通道统计、序列长度分布、KS 检验,或最直接的——先跑特征提取基线,基线显著高于随机即领域尚近。
为什么永远先跑特征提取基线
无论最终选哪种模式,特征提取都应该第一个跑,三个理由:
- 快:几分钟出结果,给整个项目定下基线锚点
- 诊断:基线贴近随机说明领域距离过大或数据有误,直接上全量微调只会掩盖问题
- 对照:后续任何模式的效果都要相对这个基线报增益,验收时才有话可说
# 特征提取基线的最小验收脚本骨架 import torch import torch.nn as nn def quick_baseline_check(train_acc, val_acc, n_classes): """基线健康度速判:决定走哪条施工路线""" random_line = 1.0 / n_classes if val_acc < random_line * 1.5: return "基线贴近随机:查数据与领域距离,暂缓复杂微调" if train_acc - val_acc > 0.30: return "训练验证差过大:数据泄漏或标注噪声嫌疑" return f"基线健康(高于随机线 {val_acc/random_line:.1f} 倍),可上更强模式" print(quick_baseline_check(0.91, 0.74, 10)) # 输出: 基线健康(高于随机线 7.4 倍),可上更强模式 print(quick_baseline_check(0.55, 0.13, 10)) # 输出: 基线贴近随机:查数据与领域距离,暂缓复杂微调
三模式对照总表
| 维度 | 特征提取 | 层冻结微调 | 全量微调 |
|---|---|---|---|
| 可训练参数(ResNet-18 例) | 约 0.05% | 约 85% | 100% |
| 训练耗时 | 基准一倍 | 约两倍 | 约三倍 |
| 过拟合风险 | 极低 | 中 | 高(小数据) |
| 典型增益(相对特征提取) | — | 加二到五个点 | 加三到八个点 |
| 学习率配置 | 新头千分之一级 | 骨干万分之一级 | 骨干万分之一级加调度 |
⚠️ 常见坑:跳过基线直接全量微调。训练曲线好看、验收翻车,回头已分不清是模式问题还是数据问题——基线锚点是排错的地基。
**模式之间可以组合。**三种模式不是单选题:特征提取练好的头可以直接作为层冻结微调的起点(第 5.2 节工地二的两阶段就是这种组合);全量微调发现过拟合,也可以回退一层把浅层重新冻住。工程队把这叫"先轻后重、随时可退"——施工力度是旋钮,不是开关。
💡 关键直觉:模式选择不是一次性的。标准节奏是"特征提取打底,视增益逐级放开",每一级的增益都量化记录,增益趋零就停手。
本节要点回顾
- 三模式定位:特征提取零点零五参数求稳、层冻结放开深层求平衡、全量放开求上限
- 决策矩阵:数据量乘领域距离两轴定位,四象限各有默认模式
- 基线纪律:特征提取永远第一个跑,作锚点、作诊断、作对照三合一
- 配套学习率:模式越开放,骨干学习率要越小,细节见 4.4 节
- 本节位置:模式定了,下一节讲模式确定后的第一个动作——改结构换头
评论区
(0)
U