4.3 层冻结策略:哪些承重墙不能动
4.3 层冻结策略:哪些承重墙不能动
本节摘要:层冻结把微调的施工范围圈定在安全的边界内。判断依据有三:层次规律(浅层通用该冻)、数据量(越少冻得越多)、领域距离(越远解冻越深)。本节实现三种冻结实现方式(逐模块开关、判别式学习率的软冻结、逐层解冻的渐进施工),给出冻结深度的速查表,并排解 BatchNorm 统计量这个最常被忽略的冻结陷阱。
承重墙的判断依据
第 2.4 节的层次规律在这里落地为施工规范:浅层是承重墙——动它收益小(特征本来就通用)、风险大(一处改动层层传导);深层是隔断墙——任务相关的语义都在这里,微调的主战场。三轴定冻结边界:
- 层次轴:从浅到深,冻结优先级递减
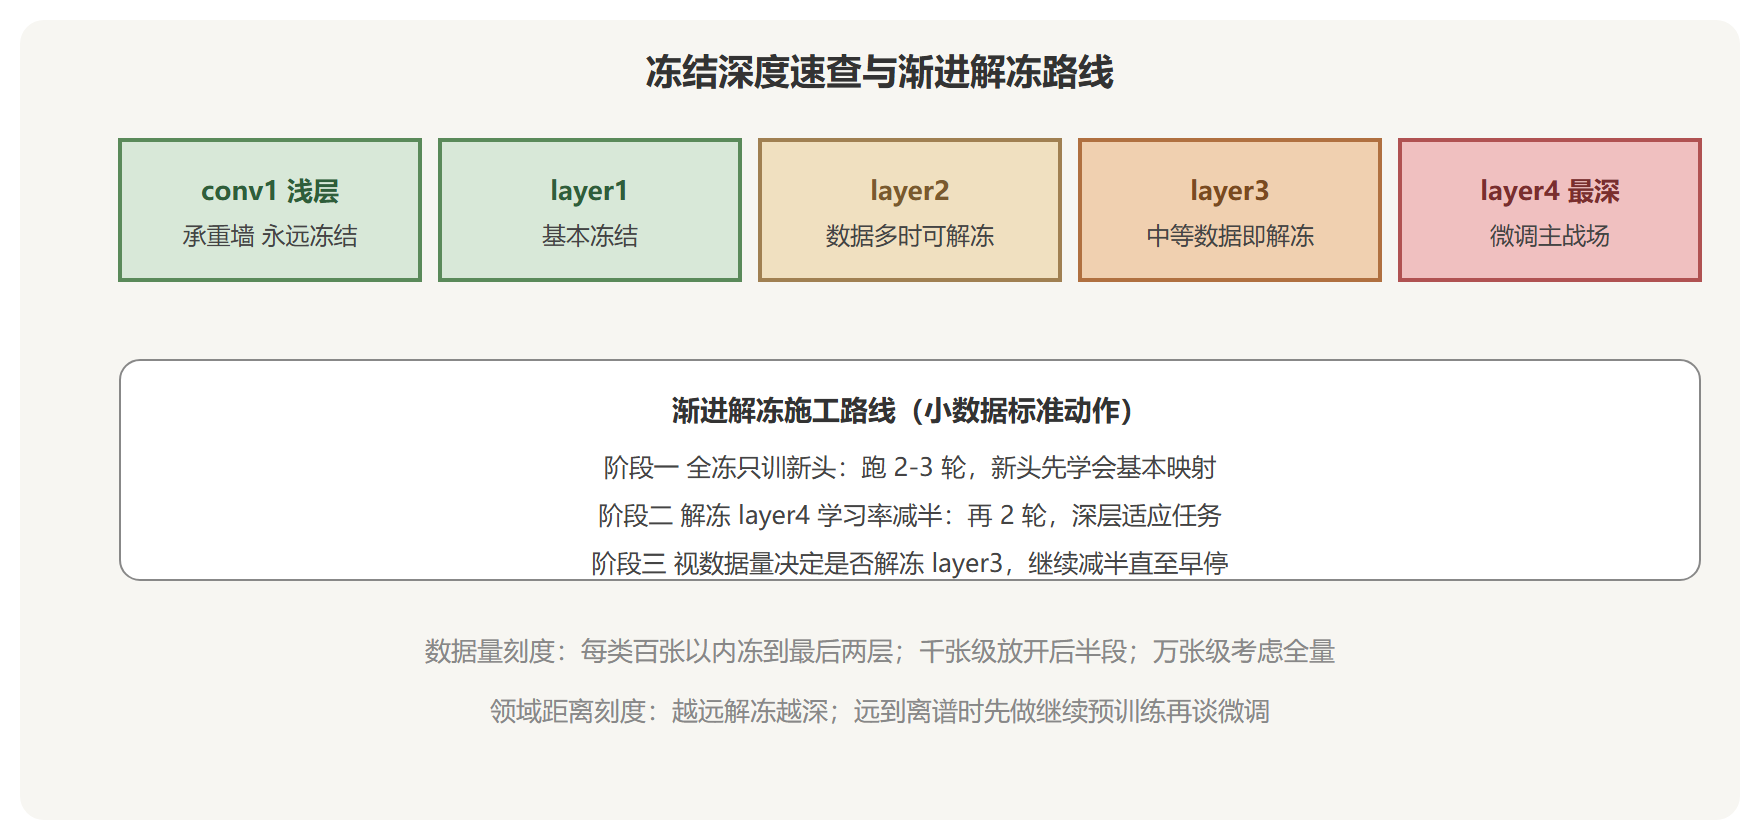
- 数据轴:每类几百张以内,冻到只剩最后两三层可训;几千张,放开后半段;上万张,考虑全量
- 领域轴:领域近,冻结可以保守;领域远,深层必须放开,甚至考虑继续预训练
冻结的三种实现
实现一:硬冻结(requires_grad 开关)。直接、省算力,已在 4.1 节演示。注意硬冻结不只是省参数——冻结层的梯度不用计算,反传播时间显著下降。
实现二:软冻结(判别式学习率)。不关梯度,而是给浅层极小的学习率。好处是浅层仍有微弱的适应自由,坏处是算力没有节省。
实现三:渐进解冻(逐层施工)。先冻结全骨干只训头,收敛后从最深层往上逐层解冻,每解冻一层降一次学习率。小数据微调的稳定套路。
import torch import torch.nn as nn from torchvision import models # 实现二:软冻结——分层学习率按深度指数衰减 def layerwise_lrs(model, base_lr=1e-3, decay=0.6): """浅层学习率指数衰减:越深衰减越少""" groups = [] depth = 0 for name, child in model.named_children(): params = list(child.parameters()) if not params: continue lr = base_lr * (decay ** depth) groups.append({"params": params, "lr": lr}) depth += 1 return groups m = models.resnet18() groups = layerwise_lrs(m, base_lr=1e-3) for i, g in enumerate(groups): print(f"参数组 {i}: 学习率 {g['lr']:.2e}") # 输出: # 参数组 0: 学习率 1.00e-03 (conv1,最浅) # 参数组 1: 学习率 6.00e-04 (bn1) # 参数组 2: 学习率 3.60e-04 (layer1) # 参数组 3: 学习率 2.16e-04 (layer2) # 参数组 4: 学习率 1.30e-04 (layer3) # 参数组 5: 学习率 7.78e-05 (layer4,最深) # 浅层学习率被压到约十三分之一:软冻结的承重墙保护
# 实现三:渐进解冻的调度器骨架 class GradualUnfreezer: """按轮次从最深层向上解冻,每解冻一批学习率减半""" def __init__(self, model, blocks, unfreeze_at=(2, 4), cut=0.5): self.blocks = blocks # 从深到浅排列的模块名列表 self.unfreeze_at = unfreeze_at self.cut = cut def on_epoch(self, epoch, model, optimizer): for i, e in enumerate(self.unfreeze_at): if epoch == e: mod = dict(model.named_children())[self.blocks[i]] for p in mod.parameters(): p.requires_grad = True for g in optimizer.param_groups: g["lr"] *= self.cut # 解冻伴随降速 print(f"epoch {epoch}: 解冻 {self.blocks[i]},学习率减半") m = models.resnet18() for p in m.parameters(): p.requires_grad = False m.fc = nn.Linear(512, 10) opt = torch.optim.AdamW([p for p in m.parameters() if p.requires_grad], lr=1e-3) uf = GradualUnfreezer(m, blocks=["layer4", "layer3"], unfreeze_at=(2, 4)) for epoch in range(6): uf.on_epoch(epoch, m, opt) # 输出: # epoch 2: 解冻 layer4,学习率减半 # epoch 4: 解冻 layer3,学习率减半
冻结深度速查与渐进施工
最隐蔽的陷阱:BatchNorm 统计量
requires_grad 只冻结权重,不冻结 BatchNorm 层的运行均值与运行方差。训练模式下,这些统计量仍随每一批数据更新。目标域分布与源域有差异时(几乎总有),你以为是"完全冻结"的骨干,其实每批都在偷偷漂移。处理方式二选一:训练时把冻结区的 BatchNorm 强制设为评估模式;或显式重新估计统计量——训练收敛后,在目标域数据上前向若干批、重写运行统计。
def freeze_bn(model, eval_mode=True): """把所有 BatchNorm 的统计量固定住(权重仍可按 requires_grad 控制)""" n = 0 for mod in model.modules(): if isinstance(mod, torch.nn.BatchNorm2d): mod.eval() if eval_mode else mod.train() n += 1 return n m = models.resnet18() print(f"固定了 {freeze_bn(m)} 个 BatchNorm 层的统计量") # 输出: 固定了 20 个 BatchNorm 层的统计量 # ResNet-18 共 20 个 BN 层——硬冻结时若漏掉这步,承重墙在悄悄移位
⚠️ 常见坑:冻结骨干后忘记冻结 BatchNorm 统计量,训练集与验证集的预处理分布稍不一致,验证精度就无规律抖动,排查起来极其费时。
💡 关键直觉:冻结的本质是"控制有效自由度"。硬冻结、软冻结、渐进解冻只是控制手段的松紧不同,目标一致——让有限的数据只去修改足够少、足够相关的参数。
本节要点回顾
- 三轴定界:层次规律、数据量、领域距离,三轴合起来定冻结边界
- 三种实现:硬冻结省算力、软冻结留微调自由、渐进解冻最稳(解冻必配学习率减半)
- 分层学习率手感:按深度指数衰减(如每层乘零点六),最浅层被压到十分之一以下
- BN 陷阱:requires_grad 冻不住运行统计量,ResNet-18 的二十个 BN 层要显式处理
- 本节位置:冻结范围定了,下一步给这些范围配上正确量级的学习率(4.4 节)