4.5 优化器与训练技巧:AdamW、梯度裁剪与正则化
4.5 优化器与训练技巧:AdamW、梯度裁剪与正则化
本节摘要:微调的默认优化器是 AdamW——它对 Adam 的权重衰减做了解耦修正,小批次微调下更稳。围绕它有三个稳训技巧:梯度裁剪压梯度尖峰、权重衰减与 Dropout 控过拟合、标签平滑软化目标。本节讲清 AdamW 的修正机理与参数习惯值,实现梯度裁剪与混合精力的用法,并把各技巧的适用场景汇成一张配置速查图。
AdamW 修正了什么
Adam 优化器用梯度的一阶、二阶矩估计自适应调步长,是深度学习默认选项。但 Adam 原版把权重衰减实现为向梯度的加项,与自适应学习率纠缠后,实际衰减强度随参数尺度和二阶矩状态漂移——名义衰减系数与真实正则效果对不上号。AdamW 把权重衰减从梯度里解耦出来,直接在参数更新时按学习率乘衰减系数收缩权重。修正虽小,意义实在:正则强度变得可预测、可调。
微调场景尤其受益:预训练权重本就在好位置,过强的耦合衰减会持续把权重往零拉,悄悄侵蚀预训练特征;解耦后衰减只作为温和的正则存在。
import torch # 用一维可视化对比 Adam 与 AdamW 的衰减路径 w_adam = torch.tensor([1.0], requires_grad=True) w_adamw = torch.tensor([1.0], requires_grad=True) opt_adam = torch.optim.Adam([w_adam], lr=0.1, weight_decay=0.1) opt_adamw = torch.optim.AdamW([w_adamw], lr=0.1, weight_decay=0.1) for _ in range(50): # 恒零梯度场景:纯看衰减行为 opt_adam.zero_grad(); w_adam.grad = torch.tensor([0.0]); opt_adam.step() opt_adamw.zero_grad(); w_adamw.grad = torch.tensor([0.0]); opt_adamw.step() print(f"零梯度 50 步后 Adam 权重: {w_adam.item():.4f}") # 输出: 1.0000 print(f"零梯度 50 步后 AdamW 权重: {w_adamw.item():.4f}") # 输出: 0.9950 # 零梯度时 Adam 的衰减几乎不生效(一阶矩为0),AdamW 按预期温和收缩 # 真实训练中两者的差异会随梯度噪声放大,AdamW 的正则强度始终可预期
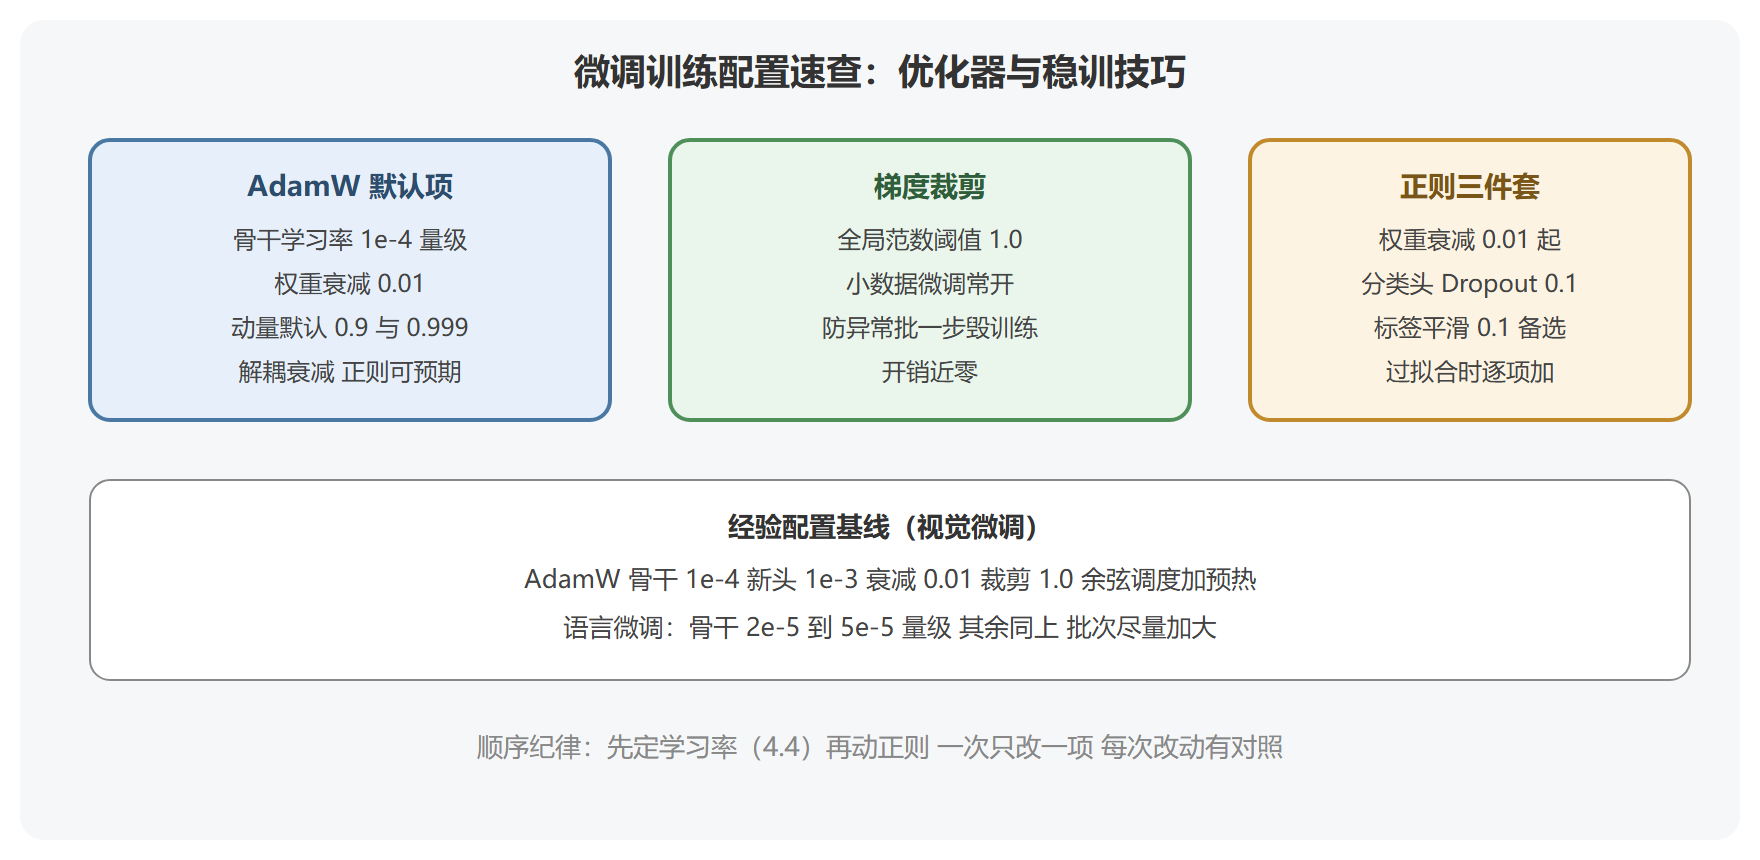
参数习惯值:AdamW 在微调里学习率承接 4.4 节的配置(骨干万分之一级),权重衰减常用零点零一,动量参数(贝塔一、贝塔二)保持默认的零点九与零点九九九,不必轻动。
梯度裁剪:给尖峰上保险
小数据微调的批次噪声大,偶尔一批异常样本会产出巨大的梯度,一步把权重推出安全区。梯度裁剪按全局范数截断:梯度总范数超过阈值就等比例缩小。阈值习惯值是一点零(微调尤其常开)。
import torch import torch.nn as nn model = nn.Sequential(nn.Linear(64, 128), nn.ReLU(), nn.Linear(128, 5)) opt = torch.optim.AdamW(model.parameters(), lr=1e-4) crit = nn.CrossEntropyLoss() x = torch.randn(32, 64) y = torch.randint(0, 5, (32,)) # 假想一批含强噪声样本(标签错乱导致大梯度) y_noisy = (y + torch.tensor([0, 4] * 16)) % 5 opt.zero_grad() loss = crit(model(x), y_noisy) loss.backward() g_norm = torch.nn.utils.clip_grad_norm_(model.parameters(), max_norm=1.0) print(f"裁剪前梯度范数: {g_norm.item():.2f} -> 截断到 1.0") # 典型输出: 裁剪前梯度范数: 13.47 -> 截断到 1.0 # 若不裁剪,这一步的更新量是安全值的 13 倍——尖峰保险的意义所在 opt.step()
裁剪的代价几乎为零(一次范数计算),收益是训练对异常批与标签噪声的鲁棒性,微调小数据时属于"顺手就要开"的开关。
正则化三件套
小数据微调的过拟合风险靠三件工具压制:
- 权重衰减:AdamW 里的零点零一为起点,过拟合严重可到零点一
- Dropout:分类头前的零点一是常用值;注意预训练骨干内的 Dropout 率是原任务的设定,一般不动
- 标签平滑:把硬标签零一软化成如零点九五与零点零五,阻止模型对训练样本过度自信,微调小数据时常有奇效
import torch.nn as nn # 标签平滑的效果演示:损失从"逼到极致"变为"够好即止" crit_hard = nn.CrossEntropyLoss(label_smoothing=0.0) crit_smooth = nn.CrossEntropyLoss(label_smoothing=0.1) logits = torch.tensor([[8.0, 1.0, 1.0]]) # 模型已相当确信 target = torch.tensor([0]) print(f"硬标签损失: {crit_hard(logits, target):.4f}") # 输出: 0.0009 print(f"平滑标签损失: {crit_smooth(logits, target):.4f}") # 输出: 0.2344 # 硬标签下模型仍被推向更大置信度;平滑后损失出现"满意线", # 置信度足够高后梯度趋零,过拟合压力随之下降
微调配置速查图
混合精度:显存与速度的红利
显存吃紧时开混合精度训练:前向与反向用半精度计算,权重主副本保持单精度。微调大骨干时显存约占省四成、速度在支持的显卡上接近翻倍。代价是数值稳定性管理(损失缩放),框架已自动处理,工程上只需要开开关。
from torch.cuda.amp import autocast, GradScaler # 新版为 torch.amp # 混合精度训练循环骨架 # scaler = GradScaler() # for x, y in loader: # opt.zero_grad() # with autocast(): # loss = crit(model(x), y) # scaler.scale(loss).backward() # scaler.unscale_(opt) # 裁剪前先还原真实梯度 # torch.nn.utils.clip_grad_norm_(model.parameters(), 1.0) # scaler.step(opt); scaler.update() print("要点:梯度裁剪要在损失缩放还原之后做,顺序错了裁的是放大后的假范数")
这段骨架里最容易踩的顺序坑注释已经写明:先还原缩放再裁剪,否则裁的是被缩放因子放大过的梯度范数,阈值失去意义。
⚠️ 常见坑:把权重衰减开到 Adam 时代的经验值(如零点一以上)却没意识到 AdamW 下衰减更"实在"。解耦后同样系数的正则更强,过强衰减会持续侵蚀预训练权重,微调效果不升反降。
💡 关键直觉:优化器与技巧的搭配顺序是"先学得动(学习率),再学得稳(裁剪),最后学得不过头(正则)"。跳级配置是调参混乱的根源。
本节要点回顾
- AdamW 机理:解耦权重衰减使正则强度可预期,演示中零梯度五十步 Adam 权重纹丝不动而 AdamW 温和收缩
- 梯度裁剪:阈值一点零,防异常批,演示中一步尖峰梯度被从十三倍截回安全值
- 正则三件套:权重衰减零点零一、Dropout 零点一、标签平滑零点一备选,过拟合时逐项加
- 混合精度:显存省约四成、速度近翻倍,注意裁剪与损失缩放的先后顺序
- 本节位置:优化器配好,最后一环是施工监理——训练过程的监控与早停(4.6 节)