1.2 发展历程:三次浪潮与两次寒冬
1.2 发展历程:三次浪潮与两次寒冬
本节摘要:七十年、三次浪潮、两次寒冬、一次解冻——本节把 1950 年至今的AI史压成一条可解释的曲线。第一次浪潮由符号主义主导,从达特茅斯会议的乐观一路走到 1974 年的经费撤退;第二次浪潮靠专家系统的商业化回血,又在 1987 年败于维护成本与常识缺位;第三次浪潮由统计学习蓄力、深度学习引爆,2012 年 AlexNet 在 ImageNet 上一战成名,2017 年的 Transformer 铺开大模型时代。每个转折都由同一组变量决定:钱、算力、数据。看懂这三个变量,就看得懂AI的下一程。
本节目标
- 画出三次浪潮两次寒冬的时间轴,标注至少六个关键事件与年份
- 解释每次寒冬的成因:过度承诺、算力不足、知识获取瓶颈、维护成本
- 说出 1986 年反向传播与 2012 年 AlexNet 各自的历史角色
- 复述范式转变的三步:人写规则,到数据学规则,再到机器自己提特征
- 用"钱、算力、数据"三个变量分析当前浪潮的续航条件
一、第一次浪潮(1950-1974):符号主义的黄金年代
达特茅斯会议之后,乐观情绪像野火一样蔓延。主流研究路线是符号主义:把知识表示成符号与规则,用逻辑推理和启发式搜索模拟思维。这条路早期确实捷报频传。1956 年,纽厄尔、西蒙和肖写出"逻辑理论家"程序,成功证明了罗素与怀特海《数学原理》中的若干定理——第一个真正意义上的AI程序,开局就啃数学证明。1957 年前后,同一个团队又推出"通用问题求解器",试图用一套初始状态、目标状态加操作符的框架通吃各类问题。1966 年出现的对话程序 ELIZA 更是破圈:它靠一套关键词替换规则模拟心理治疗师,居然让不少用户倾诉衷肠。
与此同时,另一条路线在平行发芽。1957 年,罗森布拉特提出感知机——一个极简的神经网络模型,能靠调整权重学会对线性可分的数据分类。媒体为它疯狂,可好景只过了十二年:1969 年,明斯基与派普特在《感知机》一书中证明这个模型连异或问题都解不了,一盆冰水把联结主义按进了水下。此后十余年,神经网络研究几乎无人问津。
把这一波比作工业革命的第一代蒸汽机再贴切不过:每台汽缸都靠工匠手工镗孔,在矿井里抽水够用,想通用无望。符号主义程序也一样——每个系统都是手工艺品,演示惊艳,规模一放大就露怯。
⚠️ 常见坑:把第一次浪潮的失败归因于"想法错了"。更准确的说法是想法超前而燃料未到——便宜算力与海量数据都还要等几十年,符号主义与神经网络谁都跑不远。
二、第一次寒冬与第二次浪潮(1974-1993):从经费撤退到专家系统兴衰
七四年前后,账单到期了。四股力量合力把行业推入第一次寒冬:一是承诺未兑现,早期研究者许下过"一代人之内机器比肩人类智能"式的豪言,兑现遥遥无期;二是算力限制,当时的计算机撑不起复杂系统的运算胃口;三是知识获取瓶颈,把专家经验写成规则的难度远超预期;四是资助撤退,看不到产出的美国与英国政府相继砍掉了经费。寒冬不讨论技术对错,只冻结现金与岗位。
但寒冬里并非寸草不生。二十世纪六十年代末的 DENDRAL 已经能推断有机化合物的分子结构;七十年代的 MYCIN 专攻血液感染诊断,还能推荐抗生素方案,诊断水平接近人类专家——这两个系统是专家系统路线的先声。到 1980 年,卡内基梅隆大学为迪吉多公司开发的 XCON(也叫 R1)上线,自动配置 VAX 计算机订单,每年为公司省下数千万美元。工业界第一次看到AI直接创造利润,第二次浪潮轰然而起,"知识工程师"成为热门职业,专门负责把专家脑子里的经验翻译成规则库。
好日子不到十年。八十年代末,专家系统的三处暗伤接连溃烂:维护成本高昂,知识一过时就得重金返工;可扩展性差,规则库越膨胀,规则之间的冲突越难收拾;常识缺位,系统在狭窄领域内是专家,跨出一步就变白痴。1987 年起,投资再次撤离,第二次寒冬降临。值得玩味的是,就在寒冬前夜的 1986 年,鲁梅尔哈特、辛顿与威廉姆斯重新发现并推广了反向传播算法——训练多层神经网络的关键钥匙。火种在冰层下保存了下来。
| 对照项 | 第一次寒冬(1974-1980) | 第二次寒冬(1987-1993) |
|---|---|---|
| 导火索 | 承诺跳票、政府砍经费 | 专家系统市场崩塌、企业止损 |
| 深层病因 | 算力不足、知识获取瓶颈 | 维护成本、规则冲突、常识缺位 |
| 倒下的范式 | 通用符号推理 | 大规模专家系统 |
| 留下的遗产 | 专家系统方法论、感知机教训 | 反向传播普及、机器学习萌芽 |
用能源史作比:专家系统像每家工厂自建锅炉房——烧得旺,但养不起。锅炉匠(知识工程师)稀缺且昂贵,蒸汽管网(规则库)越铺越乱,一旦电厂(标准化算力与数据)出现,自建锅炉模式立刻失去经济性。
💡 关键直觉:寒冬里不是没有进展,只是进展不够上头条。反向传播、支持向量机这类"第三次浪潮的弹药"全都在低谷期造好,等风口一来直接取用。技术史的利息,在寒冬里照常复利。
三、解冻(1990s-2011):统计学习的翻身
九十年代,范式悄悄换轴:从人写规则,转到让机器从数据里学规则。统计学、概率论与优化理论全面进场——瓦普尼克的支持向量机在小样本、高维度数据上表现出色且有坚实理论基础;决策树直观好解释;2001 年提出的随机森林用多棵树投票,把准确率又抬一档;朴素贝叶斯称霸文本分类与垃圾邮件过滤;隐马尔可夫模型撑起了那个年代的语音识别。
标志事件接二连三。1997 年,IBM"深蓝"击败国际象棋世界冠军卡斯帕罗夫,机器首次在顶级智力对抗中胜过人类——值得点破的是,深蓝靠的是暴力搜索加人工设计的评估函数,与后来流行的深度学习无关。2006 年,Netflix 悬赏百万美元办推荐算法大赛,把协同过滤推向大众视野。同样在九十年代,杨立昆的卷积网络 LeNet-5 已在银行系统里识别支票手写数字——神经网络从未死透,只是在等它的时代。
这一阶段的软肋在于特征工程:把原始数据加工成模型可用的特征,仍然全靠老师傅手工打磨。数据有了,算力涨着,可"谁来提特征"这道工序还卡在人手里。拆掉这道工序,就是下一次革命的引信。
把三步范式转变并排看,进步的脉络会更清楚:
| 范式 | 规则从哪来 | 特征从哪来 | 代表载体 | 短板 |
|---|---|---|---|---|
| 符号主义 | 人类专家逐条编写 | 无此环节,直接喂符号 | 专家系统 | 知识获取瓶颈 |
| 统计学习 | 从带标注数据中拟合 | 人工特征工程 | 支持向量机、决策树 | 特征靠老师傅 |
| 深度学习 | 端到端从数据中学习 | 网络逐层自动提取 | 卷积网络、Transformer | 数据与算力胃口巨大 |
每一行都在把上一行的短板自动化:符号主义卡在"人写规则",统计学习就让规则从数据里拟合;统计学习卡在"人提特征",深度学习就让特征由网络逐层提取。这不是巧合,而是技术演化的常规路径——上一代的天花板,就是下一代的入口。顺带也就解释了为什么深度学习对数据和算力的胃口远超前两代:把两道人肉工序都换成机器,代价就是燃料消耗成倍上涨,这笔账我们在 1.4 节细算。
这个循环不是AI独有,铁路、电气、互联网都走过同样的过热与出清。区别只在周期长短与留下的基础设施——前两次寒冬留下的是方法教训,这一次留下的将是算力电网与数据管网。
四、第三次浪潮(2012 至今):深度学习革命与大模型时代
2012 年是分水岭。辛顿带着克里热夫斯基与苏茨克维打造的深度卷积网络 AlexNet 参加 ImageNet 图像识别大赛,把错误率从大约 25% 一口气压到 15.3%,甩开第二名一个身位。学界震动不在于夺冠,而在于夺冠方式:特征不再是人工设计,而是网络自己从海量图片里学出来的。
为什么是 2012 而不是更早?三个条件恰好同时凑齐。数据上,互联网攒够了带标注的百万级图像库;算力上,为游戏渲染设计的 GPU 拥有数千个并行小核,与神经网络的矩阵运算形状严丝合缝;算法上,ReLU 激活函数缓解了深层网络的梯度消失,Dropout 压住了过拟合,批量归一化稳住了训练过程,预训练加微调让标注稀缺难题松了绑。三者缺一,2012 都不会发生——这正是把AI当历史产物来理解的最好注脚。
此后是十年的连锁反应。1997 年就已问世的 LSTM,此刻在语音与翻译中大放异彩;2014 年,古德费洛提出生成对抗网络 GAN,两个网络互相对抗着学会生成以假乱真的图像;2016 年,AlphaGo 击败围棋世界冠军李世石,把深度学习与强化学习的组合威力展示给全球观众;2017 年,谷歌团队提出 Transformer 架构,靠自注意力机制并行处理序列,彻底取代了循环网络的串行瓶颈,成为 GPT 系列等大语言模型的地基;2018 年起,GPT 系列一路放大模型规模,开启了延续至今的大模型时代。
用工业史作比,2012 年之后发生的是电气化时刻:电网(云计算与GPU集群)铺到哪里,电动机(深度模型)就替换到哪里;而大模型时代更像超高压电网的成型——算力集中生产、按需输配,智能开始像电流一样成为可订阅的公共品。
还有一条容易被忽略的暗线值得一提:预训练加微调。这一招最早是为了对付标注稀缺——先用海量无标注数据训练通用表示,再用少量标注数据微调到具体任务。大模型时代把它推到极致:预训练阶段吞下近乎整个互联网的文本,微调阶段用少量示例就能对齐任务。回头看,从 ELIZA 的关键词替换,到今天一个模型写代码、翻文档、改合同,中间隔着的正是这条"通用表示"暗线的七十年生长。
同为历史产物,两次寒冬的教训对今天依然锋利。第一次寒冬教会行业:不要用演示效果外推工程进度——逻辑理论家能证明定理,不代表它能安排你的生产计划。第二次寒冬教会行业:不要用单点盈利外推行业盈利——XCON 省下数千万美元,不代表每家公司都能养得起知识工程师。把这两条教训套用到当下,该问的问题就不是"大模型能不能写诗",而是"它在你我的具体工序里,省下的是人工还是只省下了演示费"。
图:三次浪潮与两次寒冬时间线(1950-2025)
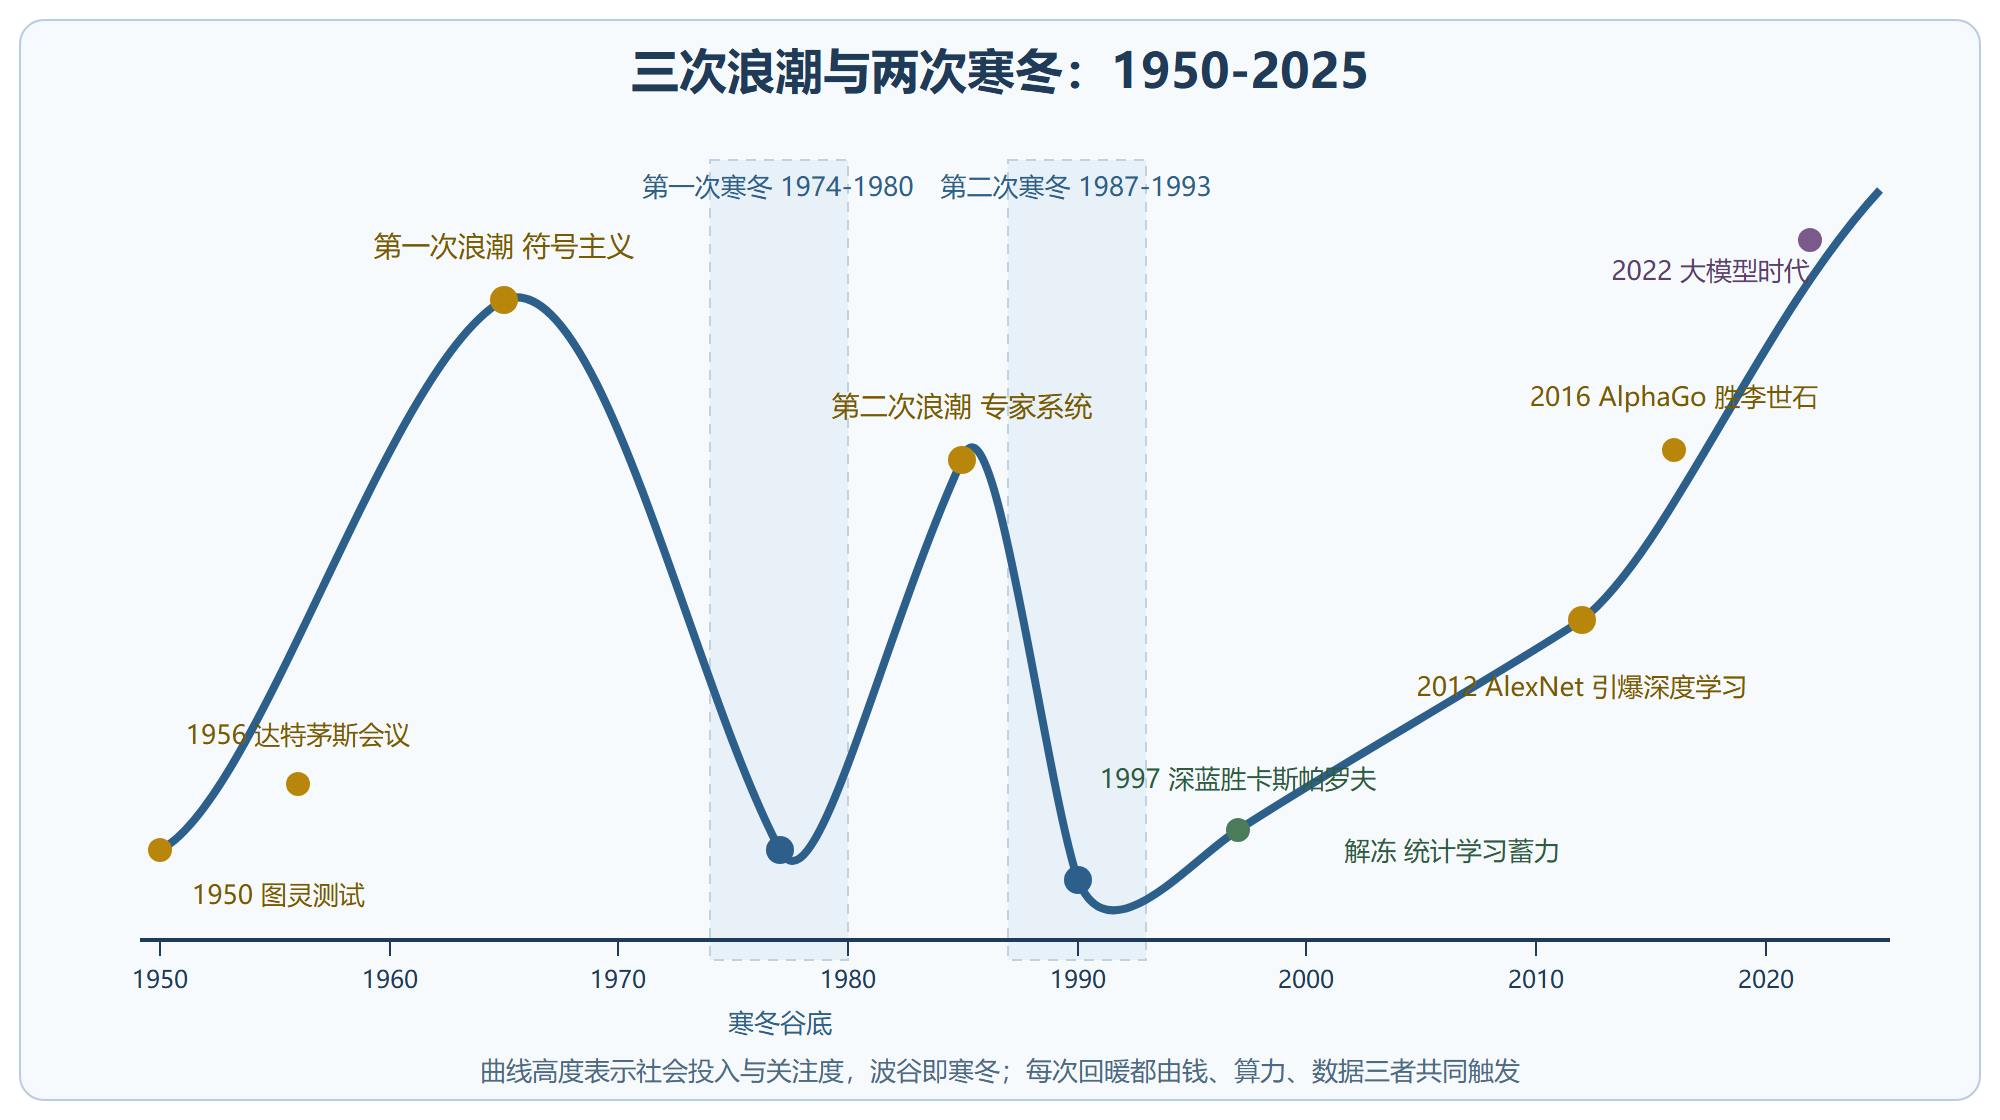
这条曲线给我们的不是怀旧,而是一套预测工具。判断当前浪潮能否续航,还是回到三个变量:数据还有没有增量、算力成本是否持续下降、算法有没有出现能兑现的新承诺。只要其中两个变量恶化,循环图上的箭头就会转向寒冬——而历史经验是,即便转寒,留守者的积累会在下一轮直接变现。
一节小结
- 第一次浪潮(1950-1974):符号主义主政,逻辑理论家、通用问题求解器、ELIZA 相继登场;1969 年明斯基的《感知机》批评让神经网络沉寂近二十年。
- 第一次寒冬(1974-1980):过度承诺、算力不足、知识获取瓶颈、美英政府撤资四力合围;失败主因是燃料未到,不是想法全错。
- 第二次浪潮(1980-1987):DENDRAL、MYCIN 验证可行,XCON 每年为 DEC 省下数千万美元,知识工程一度成为热门职业。
- 第二次寒冬(1987-1993):败于维护成本、规则冲突与常识缺位;但 1986 年反向传播已为复苏埋好火种。
- 解冻(1990s-2011):支持向量机、随机森林、隐马尔可夫模型扛起大旗,1997 年深蓝击败卡斯帕罗夫,特征工程仍是人肉瓶颈。
- 第三次浪潮(2012 至今):AlexNet 把 ImageNet 错误率压到 15.3%,数据、GPU 算力、算法三条件同时凑齐;GAN、AlphaGo、Transformer、GPT 依次引爆大模型时代。
- 方法论收获:寒冬出清资本但冻结不了技术积累,钱、算力、数据三变量是判断任何一波AI热度的通用仪表盘。
过渡引语:三次浪潮把AI推到了台前,但赢下围棋的 AlphaGo 换不来一次自然对话——能力的边界是被设计出来的,不是自然长出来的。下一节,我们沿这条边界谈强弱之别:弱AI、强AI与通用人工智能。