2.5 模型评估与优化:指标与方法
2.5 模型评估与优化:指标与方法
本节摘要:模型训完只是半成品,凭什么说它好、又怎么让它更好,是本章的收口问题。本节从"准确率会说谎"的案例讲起,用混淆矩阵把分类器的对错拆成四格账本,精确率、召回率、F1 分数与 ROC 曲线各管一类业务后果;回归看均方误差一族,聚类看轮廓系数一族。诊断环节给过拟合与欠拟合开出对照处方;优化环节盘点 K 折交叉验证、网格与贝叶斯调参、L1 与 L2 正则化、集成学习与梯度下降家族。测量在先,改进在后,这一节把顺序摆正。关键词:混淆矩阵、精确率、召回率、AUC、交叉验证、正则化、集成。
本节导航
- 会填会读混淆矩阵,讲清精确率与召回率各自站在谁的角度说话;
- 解释 ROC 曲线怎么画、AUC 为什么对类别不平衡不敏感;
- 为回归与聚类任务各挑一组合适的度量,并说出每杆秤的盲区;
- 用训练集与验证集的成绩对比诊断过拟合与欠拟合,开出对应处方;
- 说清交叉验证、超参数调优、正则化、集成学习分别在优化链条的哪一环。
一、测量先行:混淆矩阵与分类指标
十九世纪的工业界流传着开尔文的说法:不能用测量表达的知识,算不上真正的知识。蒸汽机效率的每一次提升,背后都是温度计与压力表的进步——先有准的表,才有好的机。机器学习同样遵守这条工业铁律:优化是工艺改造,评估是化验单,化验单没立起来之前,一切工艺改进都是盲改。
而评估的第一课,是知道最直观的指标会撒谎。设一个信用卡欺诈检测场景:一百笔交易里九十五笔正常、五笔欺诈,模型干脆把一百笔全判正常。算正确判定的比例——准确率——高达九成五,漂亮得能进汇报材料;可它一笔欺诈都没抓到,业务上是彻底失职。类别不平衡时,准确率会站到多数类一边说漂亮话,这正是它最危险的盲区。
要看穿把戏,得把对错拆开记账。混淆矩阵是分类器的账本:行是预测,列是实际,四格各记一笔。预测为正、实际为正,是真正例 TP,抓获;预测为正、实际为负,是假正例 FP,误报,冤枉了好人;预测为负、实际为正,是假反例 FN,漏报,放走了坏人;预测为负、实际为负,是真反例 TN,正常放行。四格摆开,每一类错误的代价一目了然。
图:分类评估指标体系
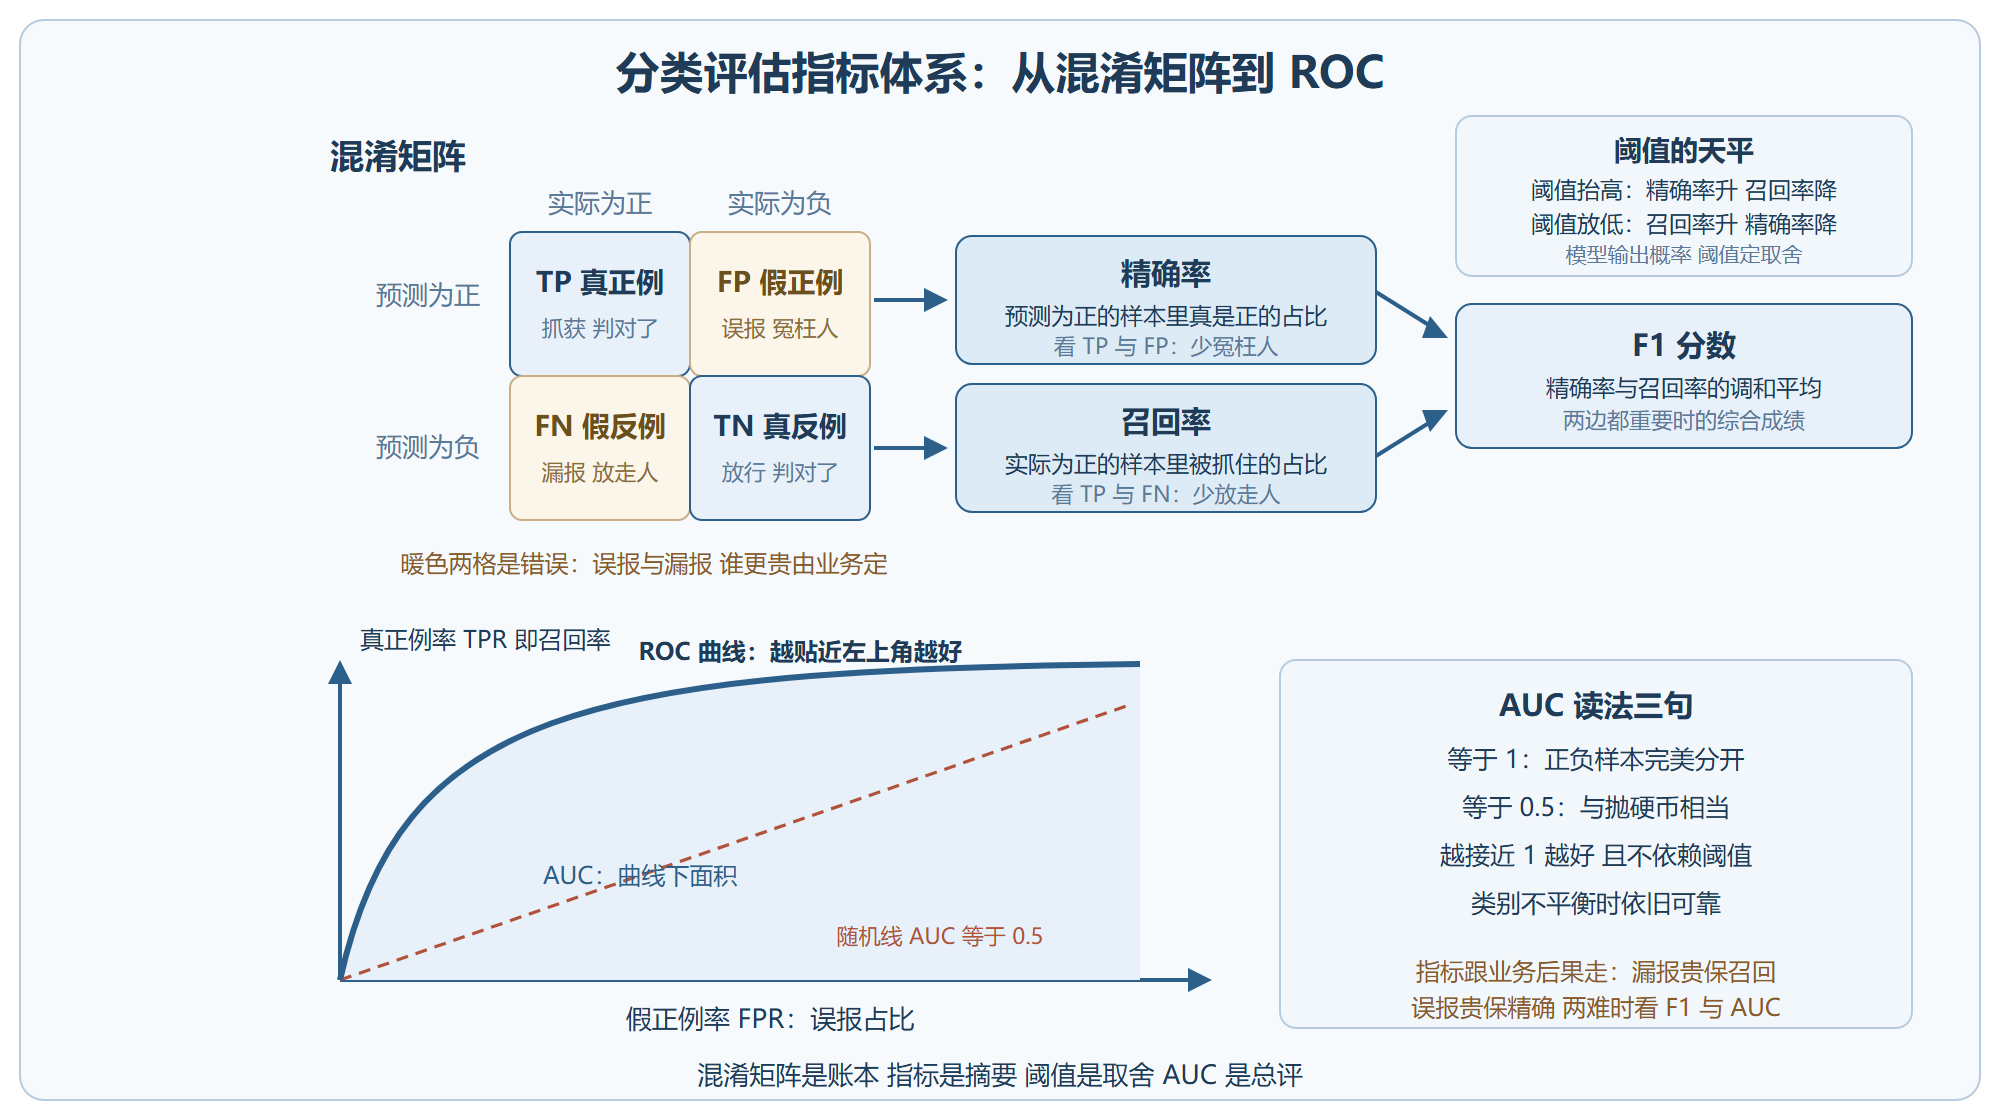
账本四格记好,指标都是对账本的摘要。精确率站在"预测为正"的样本一边:模型报出来的正例里,多少是真的?垃圾邮件过滤若精确率低,就会频繁把正常邮件错杀进垃圾箱。召回率站在"实际为正"的样本一边:真正的垃圾邮件里,多少被拦下了?召回率低意味着漏网之鱼多。两个指标常常打架:把拦截标准收严,精确率上去了,漏掉的垃圾邮件反而多;把标准放宽,召回上去了,误伤的正常邮件也多。F1 分数取两者的调和平均——调和平均惩罚短板,精确率与召回率一个掉到零,F1 就归零,想要高分必须两头兼顾。
ROC 曲线把这对矛盾画成了整条曲线。分类器输出的本是连续的概率,阈值定在哪一档,就有一个"误报占比对抓获占比"的落点;阈值从最严扫到最松,落点连成曲线,横轴是假正例率,纵轴是真正例率。曲线越贴近左上角,模型越能同时压低误报、抬高抓获。曲线下的面积就是 AUC:等于 1 表示完美分开,等于 0.5 表示与抛硬币相当。AUC 的另一个好处是不依赖任何具体阈值、对类别不平衡不敏感,常用于横评多个分类器。指标家族的分工见下表:
| 指标 | 回答什么问题 | 谁该盯紧它 |
|---|---|---|
| 准确率 | 整体判对的比例 | 类别均衡时的粗评 |
| 精确率 | 报出的正例几分是真 | 误报代价高的场景,如风控误拦 |
| 召回率 | 真正例抓住几成 | 漏报代价高的场景,如疾病筛查 |
| F1 分数 | 两头兼顾的综合分 | 两者都重要、类别失衡时 |
| AUC | 全阈值下的总体区分力 | 模型横评、类别不平衡 |
⚠️ 常见坑:只报一个指标。准确率九成五的欺诈检测可能一笔欺诈都没抓到;只看召回率的筛查系统会靠疯狂误报刷分。指标是化验单上的项目,单项正常不等于健康,立项时先问业务的错误代价表,再定看哪几项。
二、回归与聚类怎么称重
回归的误差不用对错计数,用距离。均方误差把每个误差平方后取平均,大错被指数级放大——预测错两倍,罚分翻四倍;均方根误差在均方误差基础上开根号,单位回到与原始数据一致,向业务方汇报"平均偏差多少万元"时用它;平均绝对误差对每个误差取绝对值再平均,不放大任何一方的错,对异常值更宽容。第四杆秤决定系数 R 方换个问法:模型解释了目标变量多大比例的波动,取值落在 0 到 1 之间,越接近 1 拟合越好。它有个隐疾:往模型里加特征,哪怕加的是无关特征,R 方一般也会虚高一点,因此较真的场合会用计入特征数惩罚的调整后 R 方。
聚类没有标签对答案,称重另起炉灶。轮廓系数给每个样本同时算两笔账:与自己簇内伙伴的平均距离(抱得紧不紧),与最近邻簇伙伴的平均距离(隔得远不远),两者折算成一个介于负 1 到 1 之间的数——接近 1 说明站位清晰,接近 0 说明卡在边界,负数说明多半站错了簇。全数据集取平均,就是聚类质量的总分。这一族还有内部指标戴维森堡丁指数,看簇内紧凑与簇间分离的比值,越小越好;若手里攒了一批事后核实的真实分组,还可以用调整兰德指数与互信息比对聚类结果与真值的一致性,前者把随机碰对的运气扣掉,后者衡量两组划分共享多少信息。
💡 关键直觉:指标是炼厂的化验单。原油进厂、成品出厂,每一罐都要化验——不是因为有化验癖,是因为结算、配比、工艺调整全靠这份数据。模型也一样:上线要凭指标签收,调优要凭指标对比,没有化验单的炼厂靠鼻子闻油品,没有指标的团队靠感觉发模型。
三、诊断:过拟合与欠拟合
指标体系立起来,就可以当听诊器用。训练出的模型不合格,病因无非两大类,判据就一张对照表:训练集与验证集两边成绩都差,是欠拟合——模型太简单,连训练数据里的规律都没学动;训练集成绩很好、验证集成绩明显掉一截,是过拟合——模型把训练数据里的噪声与特有细节也当了规律背下来,考试一换题就露馅,像把整本习题册答案背熟的学生,题目稍一变形就交白卷。
两类病的处方方向正好相反,吃错药只会病上加病:
| 病症 | 病象 | 处方清单 |
|---|---|---|
| 欠拟合 | 训练、验证两边都差 | 加大模型容量;补充有用特征;放松正则化;增加训练轮数 |
| 过拟合 | 训练好、验证差 | 增加训练数据;加强正则化;简化模型、减少特征;验证集上早停 |
早停值得一句解释:训练不是越久越好,验证集成绩先升后降是常见曲线,在拐点处停手,拿到的就是泛化最好的那一版——反应釜的收率随时间先升后降,老师傅会在峰值出料,道理相同。
⚠️ 常见坑:诊断只用一张成绩单。只看训练集成绩,永远发现不了过拟合;只看验证集成绩,分不清是欠拟合还是数据本身难。两张单子摆在一起对照,病象才现形。
四、优化工具箱:从验证到集成
诊断开出方向,工具箱负责落实。
交叉验证解决"一锤子评估不可靠"的问题。把数据切成 K 折,轮流让每一折当测试、其余折当训练,跑满 K 轮取平均——评估结论不再系于某一次划分的手气,方差小、可信度高,小数据集上几乎是标配。K 取到样本总数就是留一法:每次只留一个样本外出考试,评估偏差最小,代价是训练次数等于样本数,大数据集根本跑不起。选模型、调超参都用交叉验证,2.1 节说过的铁律在此再钉一钉:测试集要到最后验收才许碰,调参期间的任何比选都只许用训练与验证的数据。
超参数调优。参数是训练学出来的,超参数是训练前人定的——决策树的最大深度、学习率的大小、神经网络的层数,个个都要人拍板。网格搜索把每个超参数的候选值列成表格,所有组合挨个用交叉验证试一遍,稳妥但组合数随超参数个数指数膨胀;随机搜索不排组合表,在超参空间里随机抽点试,当只有少数几个超参数真正关键时,同样的算力反而更容易撞到好解;贝叶斯优化更精明:用高斯过程当代理模型,记住已试过的点位与成绩,推测哪片区域可能出高分,再用采集函数决定下一个试探点,试错越来越少,代价是实现更复杂。
正则化治过拟合,思路是在损失函数里给模型复杂度加罚金。L1 正则按参数绝对值收罚,会把一批参数直接压到零,顺手完成特征筛选,别名 Lasso;L2 正则按参数平方收罚,把参数整体压小但不压到零,别名 Ridge,模型更平滑。一个做减法砍特征,一个做平滑防大权重,选哪个看你要不要稀疏。
集成学习拿多个模型换一个更稳的。并行一派是 Bagging:自采样子集上各训一个模型,回归取平均、分类靠投票,随机森林是掌门;串行一派是 Boosting:模型一个接一个上线,每一个重点收拾前面留下的错误,AdaBoost、GBDT、XGBoost、LightGBM 一脉相承,表格类任务的冠军常年出自此门;还有 Stacking,把若干基模型的输出再喂给一个元模型,让它学怎么组合各位前辈的意见。
优化算法是训练的地基,负责沿着梯度下山。批量梯度下降每步吃全量数据,方向稳但走得慢;随机梯度下降每步只吃一个样本,快而抖;小批量梯度下降折中,每次吃一小批,是深度学习的常规配置。Adam 在两者基础上给每个参数配自适应的步长,把动量与均方根两套思路合在一处,是当下最常用的默认选项。
常见问题
验证集和测试集都有,留一个不行吗? 不行。验证集在调参过程中被反复使用,它的信息已经渗进了模型决策;测试集若也参与其中,等于考前看过考卷。测试集只在最后一次验收登场,这是它存在的全部意义。
指标冲突怎么办:精确率上去了召回率下来? 这不是故障,是这类问题的本性,两指标天然此消彼长。先列错误代价表——一次漏报损失多少、一次误报损失多少——再用代价定阈值与选指标;代价算不清时,看 F1 与 AUC 这类综合项。
优化工具该按什么顺序上? 先数据与特征,再模型与超参,最后集成。特征补齐往往一步顶调参十步,而把垃圾特征集成一百次也还是垃圾——先修矿,再修选矿厂,最后才轮到炼厂扩建。
一节小结
- 准确率会撒谎:九十五比五的不平衡数据上,全判多数类就有九成五准确率,业务上却是零分——这是评估学的第一课。
- 混淆矩阵是总账:TP、FP、FN、TN 四格记清,误报与漏报的代价分列,所有分类指标都从这本账上摘录。
- 精确率管误报,召回率管漏报,F1 取调和平均惩罚短板,三者随阈值此消彼长。
- ROC 与 AUC:阈值扫一遍得到曲线,越贴左上角越好;AUC 等于 0.5 等于抛硬币,等于 1 是完美,对类别不平衡不敏感。
- 回归四杆秤:均方误差放大重罚大错,均方根误差还原单位,平均绝对误差宽容异常值,R 方看解释力但会随加特征虚高,较真用调整后 R 方。
- 聚类称重:轮廓系数介于负 1 到 1,戴维森堡丁指数越小越好;有真值可比时用调整兰德指数与互信息。
- 诊断看两张成绩单:两边都差是欠拟合,训练好验证差是过拟合,处方方向相反,吃错药病上加病。
- 工具箱各有岗位:交叉验证稳住评估,网格、随机、贝叶斯三挡调参,L1 砍特征 L2 做平滑,Bagging 并行投票、Boosting 串行纠错、Stacking 用元模型合议,Adam 是梯度下降家族的默认款。
至此,四种范式、两条产线、一套天平都已就位。但本章的模型始终在"人喂特征"的框架里打转——要是特征本身能让机器一层层自己学呢?下一章走进神经网络,看表示学习如何把特征工程这份苦差也接了过去。