3.2 CNN、RNN与Transformer架构演化
3.2 CNN、RNN与Transformer架构演化
本节摘要:CNN、RNN、Transformer 不是货架上的三个并列选项,而是被数据形态接力逼出来的三代答案。图像天然是网格,卷积与权重共享让 CNN 参数骤减并认得随处出现的特征;文本天然是序列,循环结构与隐藏状态给了 RNN 记忆,梯度消失又逼出 LSTM 的门控,循环无法并行最终催生 2017 年的 Transformer 与自注意力。本节逐个拆解三者的核心机制、代价与代表模型,给出对比矩阵与按任务选型的方法。
本节目标
- 解释"数据的形态决定网络的形状",说出三大架构各自被什么压力逼出来
- 拆解 CNN 的卷积核、特征图、权重共享、池化与全连接层的分工
- 讲清 RNN 的循环与隐藏状态、梯度消失问题,以及 LSTM 三门与细胞状态的补救
- 描述自注意力的查询、键、值流程与多头、位置编码、编码器解码器的用意
- 能按任务数据形态与并行需求做出架构选型,并说出各自的账单
一、为什么会有三种机器:数据的形态决定网络的形状
地质队不会拿同一套设备采所有的矿:煤层是层状沉积,得沿层掘进;油气藏在背斜构造里,要打深井;砂金沉在河床弯道,宜用淘洗。工具随矿藏形态而变,网络结构随数据形态而变——这是本章反复出现的一条主线。
用普通全连接网络直接吃一张百万像素的图会发生什么?第一层的每个神经元都要和全部像素连线,仅这一层就得上亿量级的参数。存储撑不住只是一方面,更麻烦的是图像的根本性质:一只猫不管蹲在左下角还是右上角,都是猫;而全连接结构里,左上角的猫和右下角的猫走的是完全不同的连线,模型得分别学两遍。浪费背后藏着机会——图像是规则的网格,相邻像素关系紧密,这种先验知识完全可以焊进网络结构里,于是 CNN 登场。文本、语音、股价则是另一种形态:天生有序,前文决定后文,长度还不固定,这逼出了带记忆的 RNN。而 RNN 一步步往后传的天性,让它无法并行,GPU 的大规模算力喂不饱,最终又被 Transformer 替代。
💡 关键直觉:结构即先验。工业史上,通用锅炉烧什么燃料都凑合,效率却始终有限;换成按燃料定制的专用涡轮机,热效率立刻上台阶。CNN 把"局部相关、处处平移"的图像知识焊进连线方式,RNN 把"先后有序"焊进时间结构,Transformer 干脆把"任意两词都可能相关"交给注意力自己学——架构设计从来不是玄学,是把领域知识变成结构约束的工程。
二、CNN:为网格而生的特征流水线
卷积神经网络的心脏是卷积层。一枚卷积核是一小块可学习的权重模板,比如三乘三的小方格,它在整张图上滑动扫描:每停一处,就把覆盖区域与核做对应相乘再求和,输出一个数;扫完一整张图,得到一张特征图。模板学的是"找什么"——有的核认竖直边缘,有的认斜纹,有的认色块突变。关键设计有两个。其一,局部感受野:每只核每次只看一小片邻域,恰好匹配"相邻像素才相关"的图像天性。其二,权重共享:同一枚核从左上滑到右下,权重不变。参数因此从上亿骤降到几百,而且猫在哪个角落都逃不过同一枚"猫耳朵核"——这正是全连接网络做不到的平移不变性。彩色图有三个 RGB 通道,核也相应加厚,把三个通道的结果汇总成一张二维特征图。
| 部件 | 干什么 | 输出什么 |
|---|---|---|
| 卷积层 | 小核滑动扫描,提取局部模式 | 一张或多张特征图 |
| 激活函数 | 卷积结果过 ReLU,引入非线性 | 增强表达力的特征图 |
| 池化层 | 局部区域下采样 | 更小更稳的特征图 |
| 全连接层 | 展平后综合所有特征做判决 | 类别得分或概率 |
卷积之后通常跟一个 ReLU,再进池化层。池化是刻意的粗化:最大池化在局部窗口里只留最强的响应,平均池化取平均留整体印象。特征图因此缩小,计算量下降,更重要的是特征的位置稍有挪动,池化结果基本不变——平移不变性再上一道保险。多层"卷积、激活、池化"反复堆叠,特征逐级提纯:浅层认边缘和纹理,中层拼出眼睛、车轮这类部件,深层形成整只猫、整辆车的概念。最后把高级特征图展平成一维向量,交给一个或多个全连接层收尾,输出类别概率。
这条流水线的战绩无需多言:图像分类、目标检测、图像分割、人脸识别、医学影像辅助诊断,全是 CNN 的主场;连部分文本分类任务也借它抓取局部词组模式。历史上,LeCun 在上世纪九十年代用它识别支票上的手写数字,2012 年 AlexNet 在 ImageNet 竞赛中以明显优势夺冠,直接点燃了这十年深度学习的燎原之火。
⚠️ 常见坑:一是以为 CNN 只认图——它认的本质是"网格与局部模式",语音频谱、棋盘、时间序列的热力图都能套;二是拿 CNN 硬啃需要全局远距离交互的长序列,感受野有限,层数不够时远端信息传不过来,这种任务该看后两位主角。
三、RNN 与 LSTM:记忆的代价
处理一段话、一段语音、一条股价曲线,网络的输入是按时间先后到达的序列,第 t 个词的理解依赖前面的内容。循环神经网络的做法是给网络装一条内部记忆线:每个时间步,隐藏状态由"当前输入"和"上一时刻的隐藏状态"共同算出,再传给下一时刻。把这条循环沿时间展开,就是一串共享权重的处理单元——序列多长就展开多长,天然支持变长输入。隐藏状态就是它的记忆,理论上压缩着从开头到当前的全部相关信息。
靠这套结构,RNN 一度包揽了机器翻译、语音识别、文本生成、情感分析、命名实体识别,还有股价预测、天气预报这类时间序列问题,以及视频行为识别。但两桩历史遗留毛病很快暴露。其一,梯度消失与梯度爆炸:反向传播沿时间往回走时,梯度要一层层连乘,序列一长,乘积要么缩成接近零——开头的信息传不到结尾,长期依赖学不会;要么膨胀到天文数字——训练直接崩掉。其二,步步依赖:第 t 步必须等第 t 减 1 步算完,整条序列串行处理,GPU 最擅长的大规模并行在这里毫无用武之地。
1997 年问世的 LSTM 是对第一桩毛病的回应。它在单元里加了一条细胞状态,像一条贯穿全序列的传送带,信息沿它流动时只经历轻度的线性操作,不易衰减;三个门负责把关:遗忘门决定传送带上哪些旧信息扔掉,输入门决定哪些新信息写上去,输出门决定此刻对外透露什么。门控让网络学会"什么该记很久、什么该立刻忘",长期依赖问题大幅缓解。后来的 GRU 更进一步简化:合并成更新门和重置门两扇门,细胞状态与隐藏状态合一,参数更少、算得更快,不少任务上表现与 LSTM 相当。
⚠️ 常见坑:以为上了 LSTM 就一劳永逸。序列长到成百上千步,记忆照样吃力;更根本的是,串行结构没变,训练时 GPU 依然"吃不饱"。这两个痛点合起来,就是 Transformer 出场的历史入场券。
四、Transformer 2017:注意力终结循环
2017 年,Google Brain 团队在论文《Attention Is All You Need》里提出 Transformer,标题就是宣言:把循环和卷积全部请出去,只留注意力。自注意力的流程可以这样理解:序列里的每个词都会生成三个向量——查询向量表达"我在找什么",键向量表达"我能被怎样检索到",值向量表达"我实际携带的内容"。某个词的查询去和所有词的键做点积,得到一组注意力分数;分数经 Softmax 归一化成权重,再对所有词的值向量加权求和,就得到这个词融合了全局信息的新表示。
这套机制一次解决了两大历史难题。距离不再是问题:句首和句尾的词直接做一次点积就搭上关系,不必像 RNN 那样逐站接力,长期依赖天然可达。并行也不再是问题:所有词的查询、键、值可以同时算,训练充分吃满 GPU,大规模预训练在工程上才成为可能。代价也明码标价:注意力要两两配对,序列长度翻倍、计算量约翻四倍,长文本的算力账单涨得凶。
还有两块拼图。多头注意力:并行运行多组注意力,每个头在自己的表示子空间里关注不同的关系——一个头盯语法搭配,一个头盯指代呼应,一个头盯语义关联,最后拼接起来再做一次线性变换,理解的维度立刻丰富。位置编码:彻底丢掉循环后,网络对词序天生无感,"猫咬狗"和"狗咬猫"会算出同样的表示;补救办法是把位置信息编成向量加到词向量上,让模型重新分得清先后。
原始 Transformer 采用编码器加解码器的架构:编码器把输入序列转成一组上下文相关的表示,解码器据此并结合已生成的词逐个产出输出,最早在机器翻译上验证成功。随后家族开枝散叶:BERT 取编码器路线,双向看上下文,擅长理解类任务;GPT 取解码器路线,自回归逐词生成,擅长写作与对话;T5 把所有任务统一成"文本到文本"。视觉领域也来认亲:ViT 把图像切成小块当序列喂给注意力,DETR 用它做目标检测,语音识别与推荐系统随即跟进。
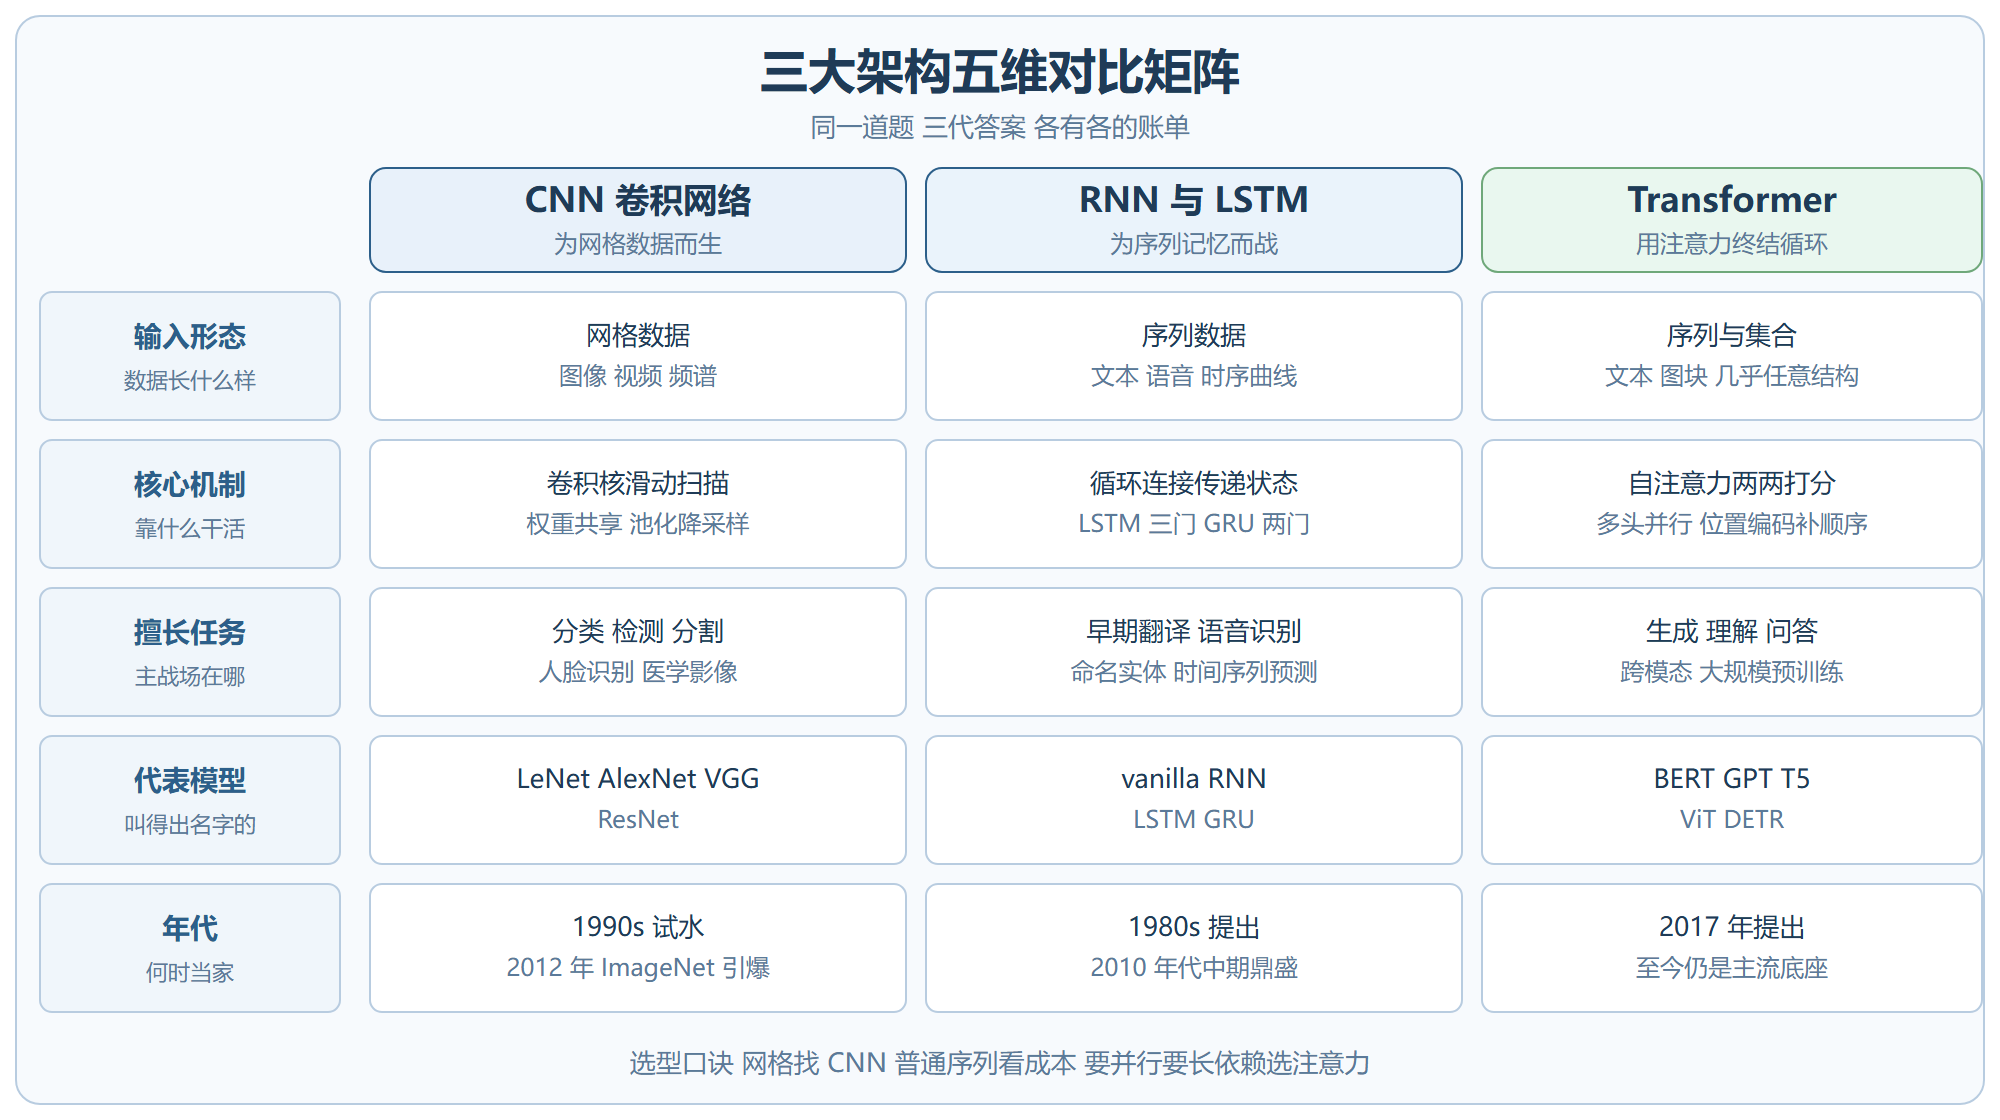
| 维度 | CNN | RNN 与 LSTM | Transformer |
|---|---|---|---|
| 核心机制 | 卷积核扫描 加权共享 池化 | 循环连接 隐藏状态 门控 | 自注意力 多头 并行 |
| 输入形态 | 网格数据 图像 视频 | 序列数据 文本 语音 时序 | 序列与集合 通用性最好 |
| 记忆与依赖 | 感受野有限 靠堆深度扩大 | 有记忆 长序列仍吃力 | 任意两位置一步直连 |
| 并行程度 | 高 | 低 时间步串行 | 极高 适合大规模训练 |
| 代表模型 | AlexNet VGG ResNet | vanilla RNN LSTM GRU | BERT GPT T5 ViT |
| 兴盛年代 | 2012 年起引爆视觉 | 1980 年代提出 2010 年代中期鼎盛 | 2017 年至今 |
| 主要账单 | 全局交互弱 小图占优 | 训练慢 长依赖差 | 长序列算力开销平方级增长 |
图:三大架构五维对比矩阵
💡 关键直觉:RNN 像传话游戏,一句话从队首传到队尾,传到第十个人早就走了样;自注意力像圆桌会议,所有人抬头对视,谁和谁相关当场交换眼神。前者串行且易失真,后者一步到位但屋子大了开销也大——两种会议室的租金结构完全不同。
重点提炼
- 三大架构是接力演化而非并列选项:网格逼出 CNN,序列逼出 RNN,并行与长依赖逼出 Transformer。
- 卷积核滑动扫描生成特征图,局部感受野与权重共享让参数骤减并天然认得平移后的特征。
- 池化做下采样增强平移不变性,展平后接全连接层收尾;特征从边缘到纹理到部件逐级提纯。
- RNN 靠隐藏状态记住历史,但梯度消失与爆炸让它学不动长依赖,训练也无法并行。
- LSTM 用细胞状态传送带加遗忘门、输入门、输出门续住记忆;GRU 两门简化,性价比高。
- Transformer 于 2017 年提出,自注意力让任意两词一步直连,并行性彻底释放,代价是长度平方级的计算量。
- 多头注意力从多个子空间看关系,位置编码补上词序,编码器与解码器分工理解与生成。
- BERT 走编码器理解路线,GPT 走解码器生成路线,T5 统一成文本到文本,ViT 与 DETR 把注意力带回视觉。
机器的形状定了,可同一台机器,训练手艺不同,成品能差出一个档次。下一节走进冶炼车间,看损失函数定方向、优化器定步子、正则化拉缰绳,如何合力炼出一炉好钢。