3.4 预训练模型与迁移学习
3.4 预训练模型与迁移学习
本节摘要:深度学习越练越深,账单也越摊越厚:标注数据稀缺昂贵,从零训练动辄数天数周,中小团队根本下不起场。预训练与迁移学习给出的解法是把"学通识"与"学专业"拆成两步——先在 ImageNet 这类数百万样本的大数据集或海量无标注文本上训出基础模型,再用少量数据微调到具体任务。本节讲清特征提取、微调、冻结解冻三板斧,梳理视觉与语言两条预训练路线的家族谱系,算清成本与收益的账,也点出领域差异、灾难性遗忘、偏见与黑箱这些暗礁。
阅读收获
- 解释预训练模型为何省数据、省时间、省钱,说出它成立的两条前提假设
- 区分特征提取、微调、冻结解冻三种迁移策略的适用场景与风险
- 复述视觉与语言两条路线的代表家族:从 VGG、ResNet 到 BERT、GPT、T5
- 算清预训练、微调、提示工程三档投入的成本差异
- 识别迁移学习的暗礁:领域差异、灾难性遗忘、小数据过拟合、偏见与可解释性
一、为什么需要预训练:标注太贵,从零太烧
二十世纪初,想用电的工厂得自建发电机、自雇锅炉工,电是奢侈品;电网铺开后,插上插座就有电,电力才真正改写工业。深度学习正沿着同一条轨道前进:从零训练一个像样的模型,需要海量标注数据和数天数周的算力,等于家家自建发电机;预训练模型的兴起,相当于把发电环节集中到少数"电厂",多数人只需"接入电网"。
预训练模型指的是在大规模数据上经过长时间训练、已经学到通用特征表示的深度学习模型。视觉领域的数据地基是 ImageNet——数百万张图像、数千个类别;语言领域则干脆绕开标注,直接用海量无标注文本,让模型做"完形填空"或"接龙"式的自监督学习。为什么这些知识搬得动?因为底层特征是通用的:在 ImageNet 上预训练过的卷积网络,浅层早就学会了认边缘、纹理、形状这些基本视觉元素,它们对识别猫狗、识别病灶、识别流水线缺陷一样有用;在海量文本上泡过的语言模型,内部已经装着词语的语义关系与句法结构,情感分析、摘要、翻译都能直接受益。
迁移学习能成立,靠两条前提假设:一是特征通用性,源任务与目标任务共享底层特征;二是知识可迁移性,源任务学到的高层抽象对目标任务确有帮助。假设成立,收益是实打实的四笔账:标注数据需求大幅下降——原本要几万张标注图,现在几百上千张就能微调出可用的模型;训练时间从数天数周压到数小时数天;学到的特征往往比小数据从头训练的更稳、泛化更好;算力账单相应缩水,个人开发者与小团队第一次玩得起深度学习。
💡 关键直觉:预训练加微调,对应"大学通识教育加岗前培训"。四年通识(预训练)贵,但由社会分摊;岗前培训(微调)几天就上岗,成本落到具体单位。没有哪个公司会为新员工从识字教起——也没有哪个团队该为基础视觉特征从零训练。
二、迁移三板斧:特征提取、微调、冻结解冻
第一板斧,特征提取:把预训练模型当一台冻住的特征提取器,只保留其主干,输出的特征向量送进一个新搭的小分类器去训练,主干权重一动不动。最省事、最不易翻车,目标数据只有几百上千条时首选。第二板斧,微调:不只借用特征,还拿目标数据继续训练预训练模型的部分或全部层,允许模型整体向新任务挪动。威力更大,要求也更高——目标数据得多一些,与预训练数据的差异也得补偿得了。技巧在于分层学习率:底层学的是通用特征,步子要小;高层学的是任务特定特征,步子可以大。
第三板斧其实是第二板斧的火候控制:冻结与解冻。稳妥的做法分两阶段——先冻结主干,只训新加的输出层直到收敛;再逐步解冻部分甚至全部层,用小学习率做端到端微调。顺序不能反:一上来就全解冻、大学习率猛冲,新任务的梯度会把预训练攒下的通用知识冲得七零八落,这就是灾难性遗忘——模型学会了新差事,却把老本行忘了个精光。
| 策略 | 动了什么 | 数据需求 | 典型风险 |
|---|---|---|---|
| 特征提取 | 只训新输出头 | 最小 几百条可用 | 适配上限有限 |
| 微调 | 部分或全部层继续训练 | 中等以上 | 小数据上过拟合 |
| 冻结解冻 | 先冻后解 分阶段推进 | 中等 | 解冻过早 学习率过大 引发遗忘 |
⚠️ 常见坑:小数据加全模型微调,是最经典的翻车组合。几百条样本去动几千万参数,模型三两下把这几百条背得滚瓜烂熟,验证一考就崩。数据少,就老老实实冻结主干只训新头;真要微调,也用小学习率、分阶段解冻,并盯着验证曲线。
三、双城记:视觉与语言两条预训练路线
视觉路线的家族谱系,几乎就是一部"骨干网络进化史"。VGG 结构规整,靠单纯堆深度见长;ResNet 引入残差连接,让信号可以"抄近道"直传深层,缓解了深网训练中的梯度消失,网络深度从此迈上百层台阶;Inception 用多尺度卷积核同时捕捉不同大小的特征;EfficientNet 用复合缩放把深度、宽度与分辨率一起均衡放大,追求性价比;ViT 则干脆把图像切成小块当序列,把 Transformer 的注意力搬进视觉。这些骨干不仅做分类:配上检测框架(如 Faster R-CNN、YOLO 系)就是目标检测,接上解码器就是图像分割,提取的风格特征还能玩风格迁移,人脸识别同样拿它提特征。
语言路线的起步是词向量时代,Word2Vec 与 GloVe 把词映射成向量,"国王减去男人加约等于女王"展示了语义可计算;真正的跃迁来自 Transformer。BERT 取编码器路线,预训练任务是掩码语言模型——随机遮住句中一些词让模型猜——外加下一句预测,双向看全文,擅长理解类任务,情感分析、命名实体识别、问答抽取都是主场。GPT 取解码器路线,自回归地从左到右逐词生成,擅长写作与对话,参数规模一路推大后涌现出少样本学习能力。RoBERTa 是 BERT 的加强重训:更大数据、更久训练、动态掩码,把同一套架构的潜力再榨一层。T5 把翻译、分类、摘要统统统一成"文本到文本"格式,一个框架通吃多任务。工程生态上,Hugging Face 聚拢了成千上万现成的预训练模型,下载、加载、微调一条龙,小团队的接入成本降到史无前例的低。
| 路线 | 结构取材 | 预训练任务 | 擅长 | 代表 |
|---|---|---|---|---|
| BERT 系 | 编码器 | 掩码语言模型加下一句预测 | 理解 分类 抽取 | BERT RoBERTa |
| GPT 系 | 解码器 | 自回归接龙预测下一个词 | 生成 对话 少样本 | GPT 系列 |
| 统一派 | 编码器解码器 | 文本到文本多任务 | 一个框架多任务通吃 | T5 |
⚠️ 常见坑:忽视领域差异。把 ImageNet 自然照片上预训练的模型直接搬到医学影像,迁移收益常常打折——CT 片的灰度、纹理世界与彩色照片相去甚远。跨域越远,越要评估预训练语料与目标数据的距离,必要时考虑领域内继续预训练。
四、账单与下一站:成本、流水线与新趋势
三档接入方式,成本天差地别。自己预训练:数千卡跑数周到数月,GPT-3、PaLM 这类模型动用数千亿级参数,是一次性投入亿级美元的"建电厂"工程,全行业只有少数玩家。微调:单卡到数卡、数小时到数天,千到万级样本,中小团队负担得起。提示工程:完全不改参数,把任务写成自然语言指令(常配几个示例),数秒数分钟见效——连微调都省了,代价是每一步推理都在调用别人的大模型,按用量付费。
省钱的工艺也在成套演进:分布式训练把上千张卡编成一台机器;混合精度用半精度浮点数 FP16 训练,显存减半、速度提升;知识蒸馏把大模型的能力压进小模型,部署成本骤降;稀疏训练只激活部分参数参与计算。多模态是另一条扩张线:CLIP 用对比学习把图像和文本对齐到同一空间,看图配文案、凭一句描述做零样本分类。再往后,自适应迁移学习希望机器自动选模型、自动定冻结策略与学习率;持续学习与终身学习想让模型边用边学,不再是一锤子买卖。
两个文字版案例把流程落地。例一,猫狗分类:从预训练的 ResNet50 出发(在 ImageNet 上预训练),冻结全部卷积层,把最后的全连接层换成输出两类的新的头,用 Kaggle 的猫狗数据集只训这个新头,学习率取千分之一量级;图像先缩放、中心裁剪到 224 见方再做归一化。几百行代码都不到的改动,效果远超从零训练的小网络。例二,影评情感分析:加载预训练的 BERT,顶部加一个二分类头,用 IMDB 影评数据微调,优化器选 AdamW,学习率取 0.00005 这个量级——比从零训练快一个数量级,精度还更高。
图:预训练到微调到部署流水线与成本对比
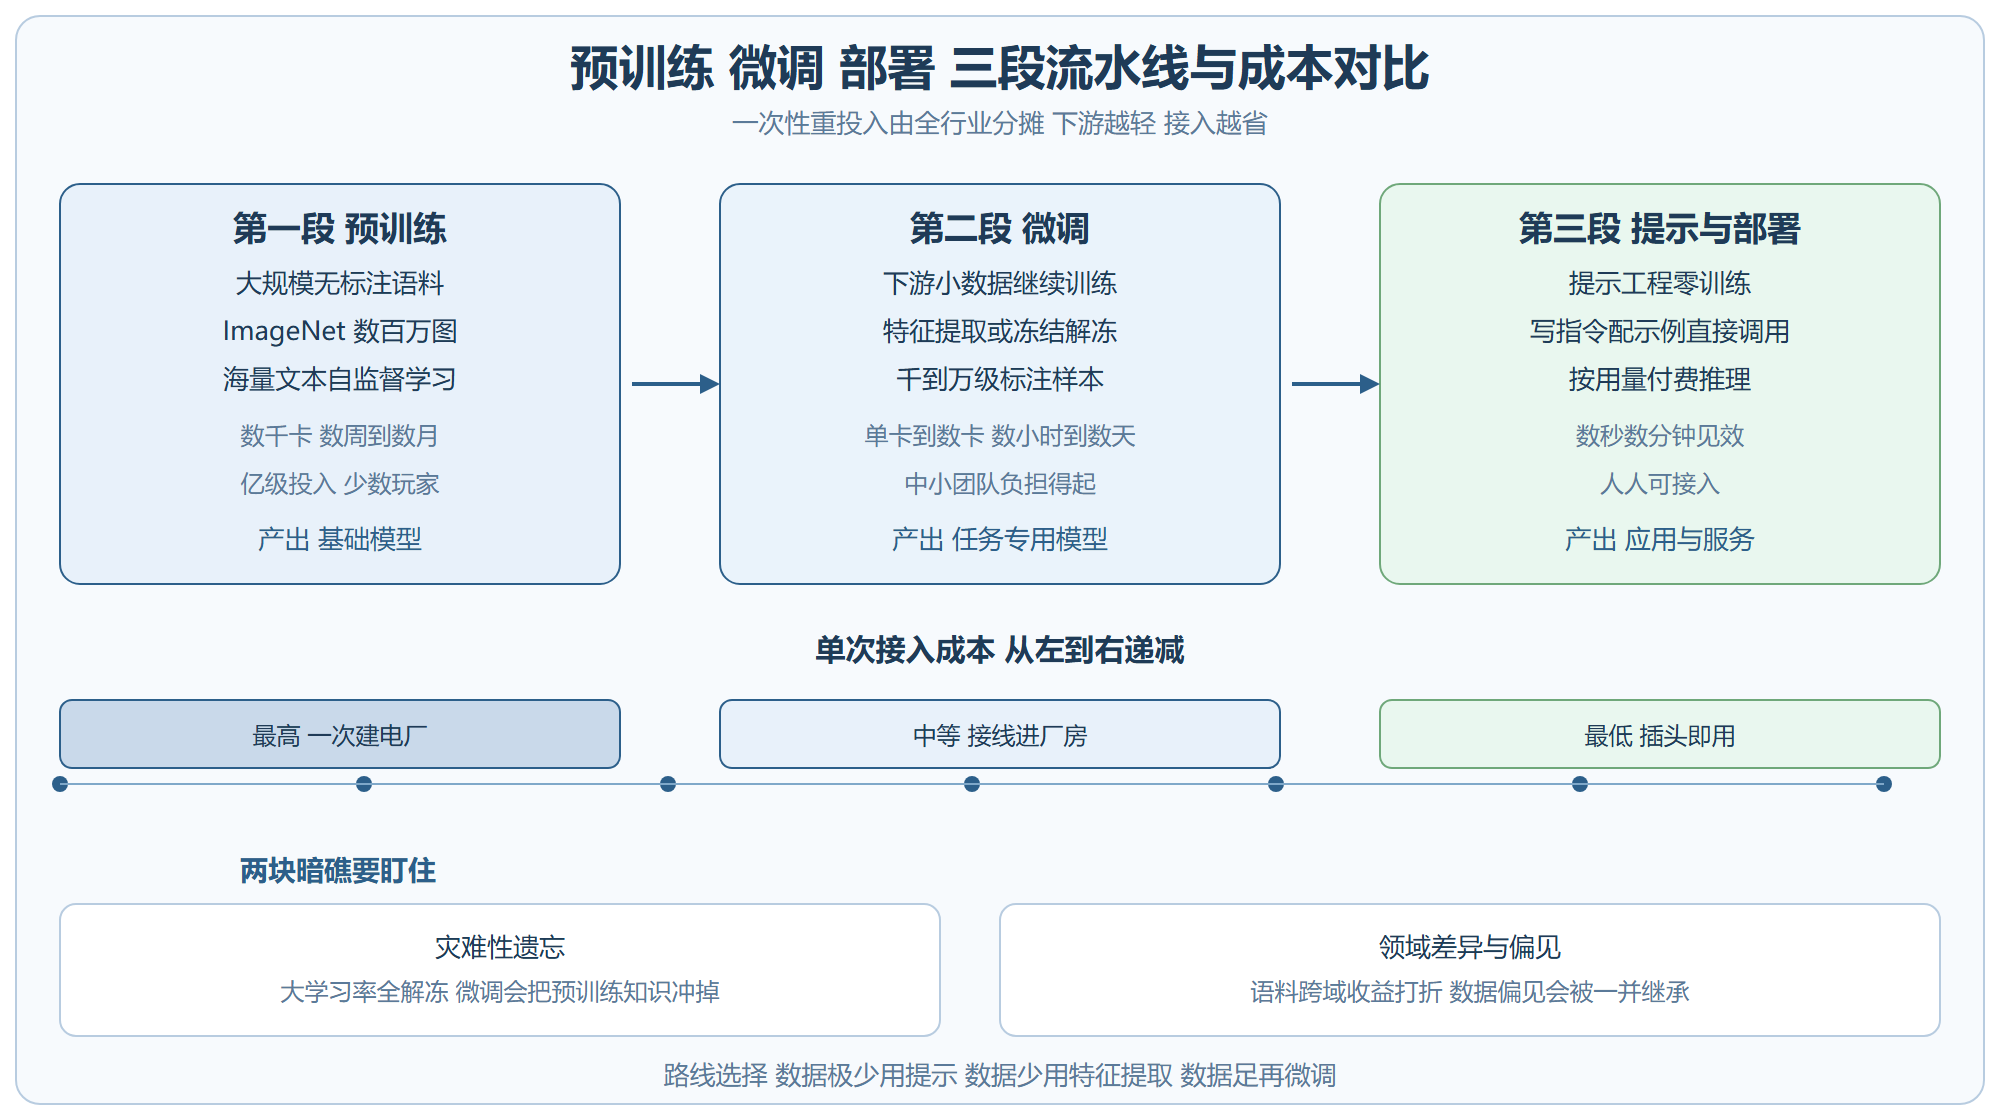
预训练规模一路膨胀,新的责任问题同步放大。预训练语料里的社会偏见会被模型一并吸收,带到下游任务里放大;训练数据可能夹带隐私信息;动辄数十亿参数的黑箱,在医疗、金融这些讲证据的行业里如何解释决策,至今没有便宜答案。这些问题会在第 5 章讨论伦理与治理时正面展开。
常见问题解答
问:手头只有几百条标注数据,选哪种迁移策略? 首选特征提取:冻结主干只训新头,最稳。数据不到几十条时,连微调都不必试,直接写好提示词调用大模型可能更划算。
问:微调会不会把预训练学的东西冲掉? 会,这叫灾难性遗忘。小学习率、分阶段解冻、在微调数据里掺一些通用数据,都是常用的缓冲垫。
问:提示工程能彻底取代微调吗? 短期内不能。要求稳定输出格式、深度注入领域知识、离线部署或压低推理成本时,微调仍占优势;提示胜在零训练、上手快,两者是互补而非替代。
要点串联
- 预训练模型在大规模数据上学通用表示:视觉站在 ImageNet 数百万图数千类上,语言靠海量无标注文本的自监督学习。
- 迁移学习成立的两条假设:底层特征通用、高层知识可迁移。
- 三板斧各有定位:特征提取最稳、微调最活、冻结解冻控火候。
- 视觉骨干进化:VGG 堆深度,ResNet 残差连接破梯度消失,Inception 多尺度,EfficientNet 复合缩放,ViT 引入注意力。
- 语言两路线:BERT 编码器双向理解,GPT 解码器自回归生成;RoBERTa 加强重训,T5 统一文本到文本。
- 成本三档:预训练数千卡数月、微调单卡数小时、提示工程零训练按量付费。
- 省钱工艺:分布式训练、混合精度、知识蒸馏、稀疏训练;多模态代表 CLIP 零样本分类。
- 暗礁清单:领域差异、灾难性遗忘、小数据过拟合、偏见与黑箱。
至此,本章的演化链走完最后一环:被冷落五十年的思想借算力与数据复活,长出三种架构,靠训练工艺炼成,最终经由预训练接入电网。接下来的第 4 章走进主战场——看看这些引擎在计算机视觉、自然语言处理与生成式应用里,究竟拖动着怎样的车厢。