4.2 计算机视觉:让机器看懂世界
4.2 计算机视觉:让机器看懂世界
本节摘要:计算机视觉(CV)要让机器从图像与视频中提取信息、理解场景,任务从图像级的分类、物体级的检测、像素级的分割,一路递进到视频级理解与三维重建。它经历了三段演化:手工特征(边缘、角点、SIFT、HOG)加统计学习(SVM、AdaBoost)的时代,被 2012 年 ImageNet 竞赛上的卷积神经网络终结,特征设计从此交给机器自学。安防、自动驾驶感知、医疗影像、工业质检已规模落地;开放场景下的泛化能力与鲁棒性,仍是这条矿脉最硬的岩层。
本节地图
- 说出计算机视觉的定义,以及"看懂"与"存下像素"的区别;
- 讲清手工特征让位于卷积神经网络的因果链,解释 2012 年为何是分水岭;
- 区分两阶段与单阶段检测、语义分割与实例分割;
- 能按落地难度给行业场景排序,说出各场景的主要瓶颈。
一、从锉刀到机床:特征工程的三次让位
约 15%,这是 2012 年 ImageNet 大规模图像识别竞赛冠军 AlexNet 的 top-5 错误率;当年的第二名还停在 26% 上下。一个数字上的断层,宣告一个时代的结束:此前十几年,各家队伍靠手工设计的特征加分类器苦苦把错误率往下磨,每年进步一两个百分点;AlexNet 用深层卷积神经网络(CNN)加 GPU 训练,一步跨过整代人没走完的距离。评委会震动的不是名次,而是方法论换天了。
往前倒带,这条矿脉的开采同样艰辛。上世纪六十到八十年代是低级特征阶段:研究者围着边缘检测、角点检测打转,受限于算力和数据,系统只能应付极简单的场景。八十到九十年代转向几何与物理模型:三维重建、运动分析需要精确的先验知识和繁复的数学推导,像用理论力学去解一片树叶的飘落——算得再细,也铺展不开。九十年代到本世纪初,统计学习入场:支持向量机(SVM)、AdaBoost 开始从数据中学模式,人脸检测成为标志性应用,但特征仍要人工设计——Harris 角点、SIFT(尺度不变特征变换)、SURF、HOG、颜色直方图、纹理描述子,每一项都是研究者手工打磨的"锉刀"。
卷积神经网络带来的不是"更好的锉刀",而是把锉刀换成了机床。CNN 从原始像素出发自动学特征:浅层学到边缘、角点这类低级特征,深层组装出物体部件与整体结构这类语义特征,端到端一气呵成,特征工程这个工种被机器接管。此后经典网络接连刷新纪录:LeNet 开先河,AlexNet 一战成名,VGG 深挖层数,GoogLeNet 用 Inception 模块拓宽结构,ResNet 靠残差连接把网络做到上百层仍能稳定训练,DenseNet 再加密特征复用。配套的迁移学习范式也成熟了:在大数据集上预训练,到小数据集上微调,中小团队不必从零烧钱。
💡 关键直觉:2012 年真正的革命不是"认得更多",而是特征工程的让位。手工特征是老师傅的锉刀,一件件凿;CNN 是机床与流水线,自己找刀路。工业革命的剧本,在视觉领域原样重演了一遍。
顺带交代流水线的第一站——图像预处理。灰度化与二值化压缩数据,高斯滤波、中值滤波去噪,亮度对比度增强救回细节,几何变换做校正与数据增强。深度学习时代,这些工序一部分被网络内部吸收,但在光照恶劣、成像质量差的工业现场,它仍是保命的护栏。
二、任务分层:从"是什么"到"在哪里"再到"每个像素"
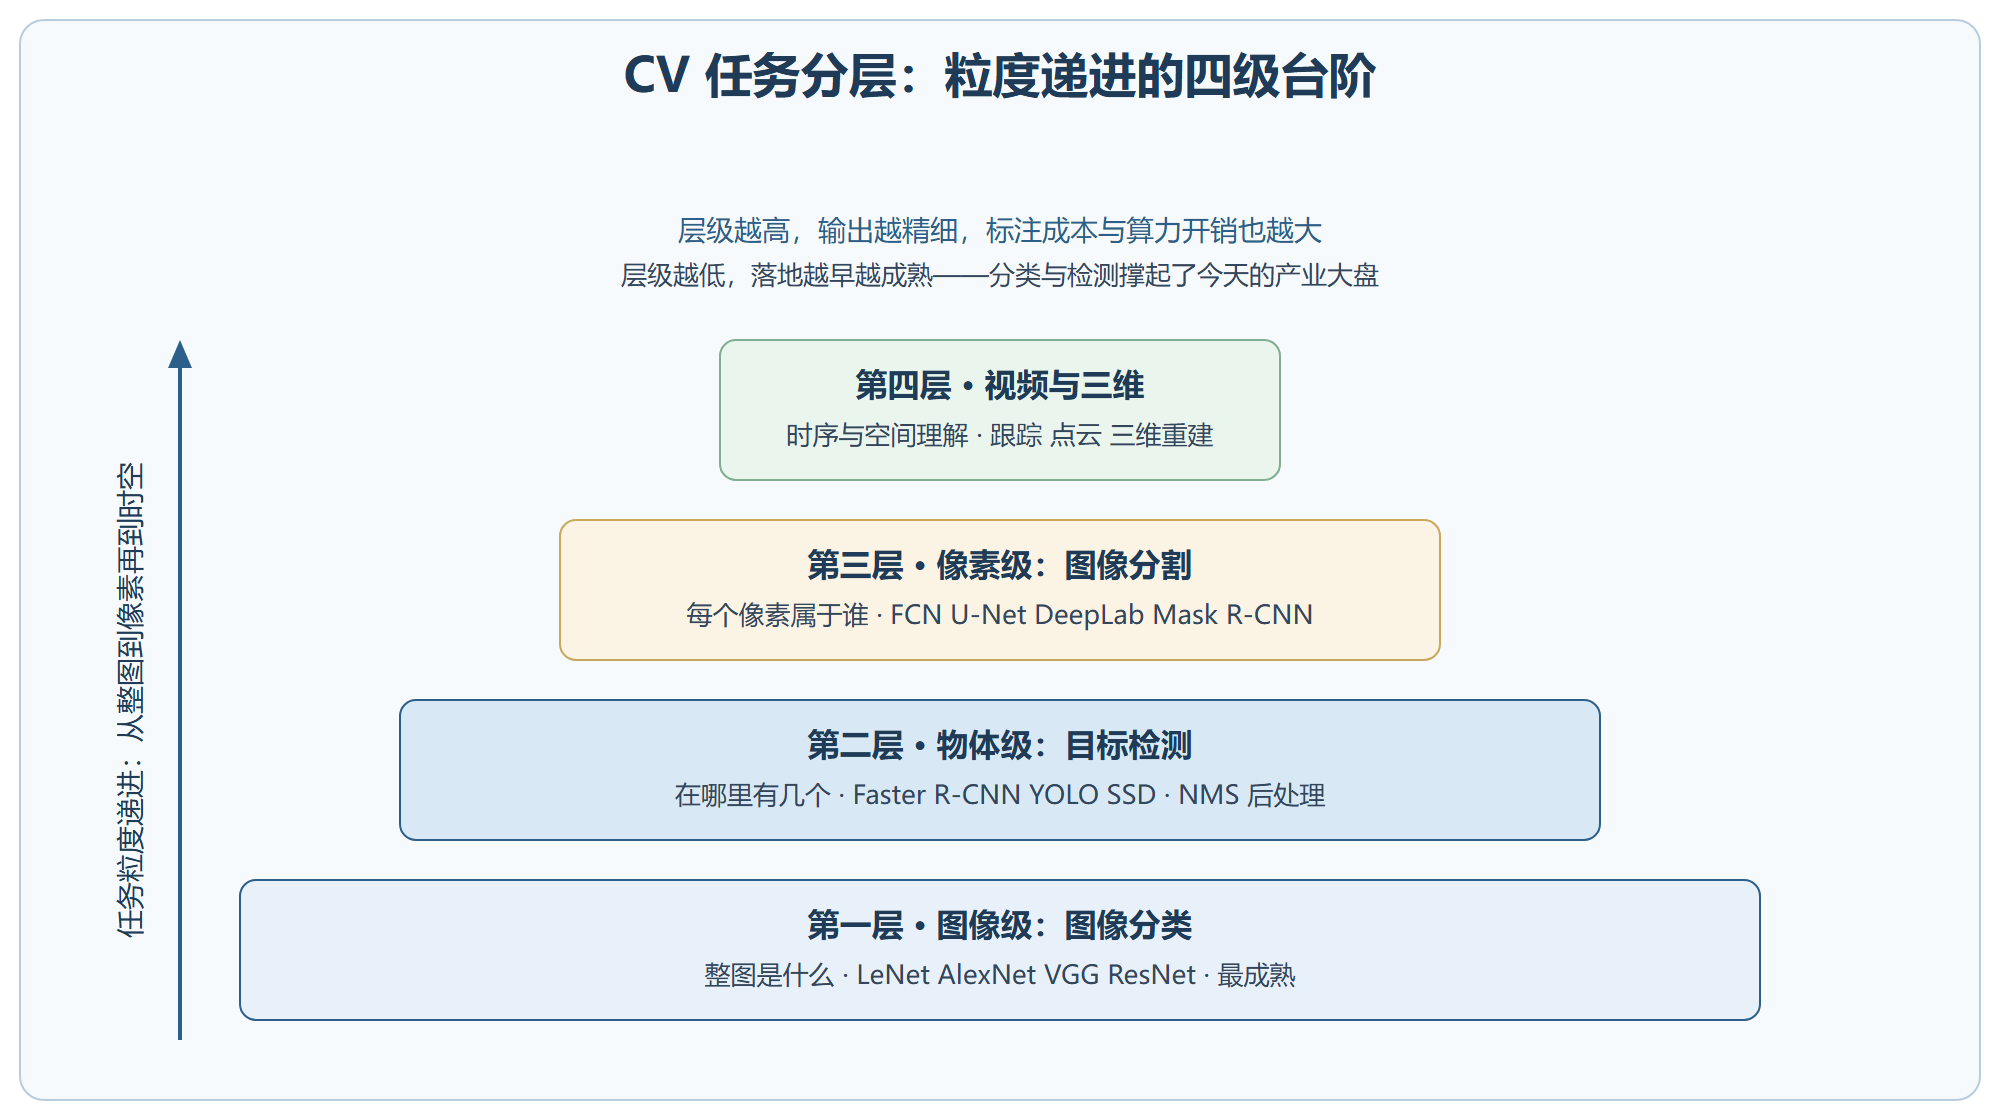
视觉任务可以按"回答的问题"分成四层,一层比一层细,一层比一层贵。
第一层是图像级——图像分类。整张图一个答案:这是猫、是狗、是 X 光片上的疑似结节。CNN 的卷积、池化、全连接流水线在此定型。分类是地基,但只回答"是什么",不回答"在哪里、有几个"。
第二层是物体级——目标检测。输出边界框加类别,是"是什么"与"在哪里"的合卷。路线分两派:两阶段的 R-CNN 系列先由区域提议网络(RPN)生成候选区域,再做分类与边界框回归,Faster R-CNN 引入 RPN 后实现端到端训练,精度标杆长期由它把持;单阶段的 YOLO 把检测当回归问题,一次前向直接预测全图的框与类别,快到能跑实时视频,SSD 则用多尺度特征图在速度与精度之间找平衡。检测输出的框还要过一道非极大值抑制(NMS),把同一个物体的重叠框去重。
第三层是像素级——图像分割。语义分割(FCN、U-Net、DeepLab 系列)给每个像素打类别标签,但同类不分个体——所有"汽车"像素染成同色;实例分割(Mask R-CNN)在 Faster R-CNN 骨架上加掩膜预测分支、用 RoI Align 对齐特征,把每一辆车单独抠出来。医疗影像里量病灶面积、自动驾驶里描车道可行驶区域,靠的都是这一层。
第四层是视频级与三维。视频理解处理跟踪、行为识别、动作时序——"这个人是在摔倒还是在弯腰";三维视觉从二维恢复空间:立体视觉靠双目视差测深度,结构光与 ToF 主动投射测距,三维重建把多视角拼成模型,点云处理直接消化激光雷达数据,是机器人与自动驾驶的口粮。
图:计算机视觉任务分层
两派检测器的取舍,值得单独摆一张表:
| 维度 | 两阶段检测 | 单阶段检测 |
|---|---|---|
| 代表 | R-CNN、Faster R-CNN | YOLO 系列、SSD |
| 思路 | 先生成候选区域,再精修分类与回归 | 一次前向直接输出框与类别 |
| 精度 | 高,小目标占优 | 略低,但差距持续缩小 |
| 速度 | 慢,难实时 | 快,可跑实时视频流 |
| 适用 | 离线分析、医疗影像、遥感 | 车载感知、视频监控、机器人 |
⚠️ 常见坑:把"分类准确"当成"看懂了"。分类只回答整图是什么,不回答在哪里、有几个;拿分类模型硬当检测用,是安防项目误报频发的经典病因。先确认任务层级,再选模型。
三、行业落地与工程取舍
智能安防是最早吃饱的方向。人脸识别撑起门禁、考勤、身份验证与嫌疑人追踪;行为识别盯着摔倒、打架、入侵、徘徊这些异常;车辆识别接住违章抓拍与停车场管理;再往上,海量监控视频的实时分析把人力从盯屏幕的苦役里解放出来。自动驾驶与机器人吃的是第二、四层:环境感知要同时识别道路、车辆、行人、交通标志、车道线并构建三维地图,障碍物检测加轨迹预测负责安全冗余,机器人则靠视觉导航避障、定位工件完成抓取与装配。
医疗健康对视觉的期待最深,也最苛刻:X 光、CT、MRI 影像的肿瘤检测与病灶识别、手术导航、病理切片自动分析都已进入辅助诊断流程。它的高门槛不在算法,在责任——模型必须可解释,标注必须由专业医生完成,出错成本以人命计价。工业制造反而是"闷声发财"的典型:表面缺陷检测(划痕、污渍、裂纹)、尺寸形状质量控制、装配检查、焊接喷涂的视觉引导,机位固定、光照可控、品类有限,把开放问题收敛成封闭问题,成功率立竿见影。智能零售做客流统计、热力图、无人结算;娱乐创意方向则由生成对抗网络(GAN)与扩散模型撑起风格迁移、背景替换、视频去抖、运动捕捉和 VR、AR 的场景理解。
工程取舍上,我们的判断是按"场景封闭度"排落地顺序:工业质检、安防门禁最稳,医疗做辅助而非替代,自动驾驶感知最难也最贵。瓶颈清单也得摊开说:标注数据贵,小样本与自监督学习在补课;泛化能力弱,光照一变、角度一偏、下雨一遮,精度就可能跳水;对抗样本攻击——一张贴纸就能骗过分类器——在安全场景是实打实的威胁;高精度模型计算量大,端侧设备跑不动,模型压缩与边缘计算在两头救场;人脸数据的隐私与合规,更是全行业悬着的剑。
💡 关键直觉:判断一个视觉项目好不好做,先看能不能把开放场景改造成封闭场景。机位固定、光照可控、品类有限,成功率立刻上一个台阶;反过来,凡是"任意光照、任意角度、任意遮挡"的需求,报价前请三思。
这条矿脉的下一程也已露头。少样本与自监督学习在削减标注依赖;多模态融合把视觉、听觉、文本拧成一股绳,让模型看着画面听声音读字幕去理解视频;可解释视觉试图把黑箱的诊断依据摊开给医生看;端侧部署与模型压缩把推理塞进手机与嵌入式设备;具身智能则让视觉与机械控制结合,机器人靠眼睛和手在物理世界里干活。生成式方向上,扩散模型已经能按文字描述造图造视频,创意工业的供给链正在被重写。
问题:为什么说 2012 年是深度视觉的分水岭?
回答:ImageNet 竞赛提供了百万级标注图像和统一评分标准,AlexNet 用深层 CNN 加 GPU 训练把错误率砍掉约十个百分点,且与第二名拉开断层。此后方法、算力、数据形成正循环,手工特征路线在几年内基本退出主流。分水岭分掉的不是一次比赛名次,而是两种方法论的地位。
问题:换个场景模型就不灵,怎么办?
回答:这是域偏移问题——训练数据与真实场景的分布不一致。务实的解法组合是:用新场景数据微调预训练模型,配合数据增强扩充光照与角度变化,实在不行回到现场把环境变量管起来。工业界的经验是:改摄像头位置和灯光的钱,往往远少于改模型的钱。
一节小结
- 定义:计算机视觉让机器从图像与视频中获取、处理、分析并理解信息,"看懂"意味着不止存下像素,还要答出是什么、在哪里、属于谁、在做什么。
- 演化主线:低级特征探索,到手工特征(SIFT、HOG、Harris 角点)加统计学习(SVM、AdaBoost),再到 2012 年 AlexNet 引爆的卷积神经网络时代,特征工程让位于端到端学习。
- 经典网络谱系:LeNet、AlexNet、VGG、GoogLeNet、ResNet、DenseNet,配合迁移学习落地到千行百业。
- 任务四层:图像级分类、物体级检测(两阶段 Faster R-CNN 对单阶段 YOLO、SSD)、像素级分割(FCN、U-Net、DeepLab、Mask R-CNN)、视频级与三维理解(跟踪、点云、三维重建)。
- 落地排序:工业质检与安防最成熟,医疗影像做辅助,自动驾驶感知最难。
- 主要瓶颈:标注成本、跨场景泛化、对抗鲁棒性、端侧算力、隐私合规。
看懂世界只是上半场,下半场要回答"接下来怎么办"。下一节的强化学习不讲感知讲行动——没有标准答案、只有奖励反馈的世界里,机器如何学会下注、踩刹车、抓工件。