3.1 动手实践:为什么必须进副本
3.1 动手实践:为什么必须进副本
本节摘要:看教程与写代码调用的是两套不同的认知过程——理解他人的代码和从零生成自己的代码之间隔着一道"生成鸿沟",唯有动手才能跨越。本节讲这道鸿沟的成因、输入与实践的科学配比,以及从"抄教程"平滑过渡到"独立写"的三级脱钩法。
技能树行进到副本门口。前两章把装备和经验机制配齐,本章回答副本的第一问:为什么教程看得再多,也替代不了亲手写——以及如何安排两者的比例。
一、理解代码与生成代码是两回事
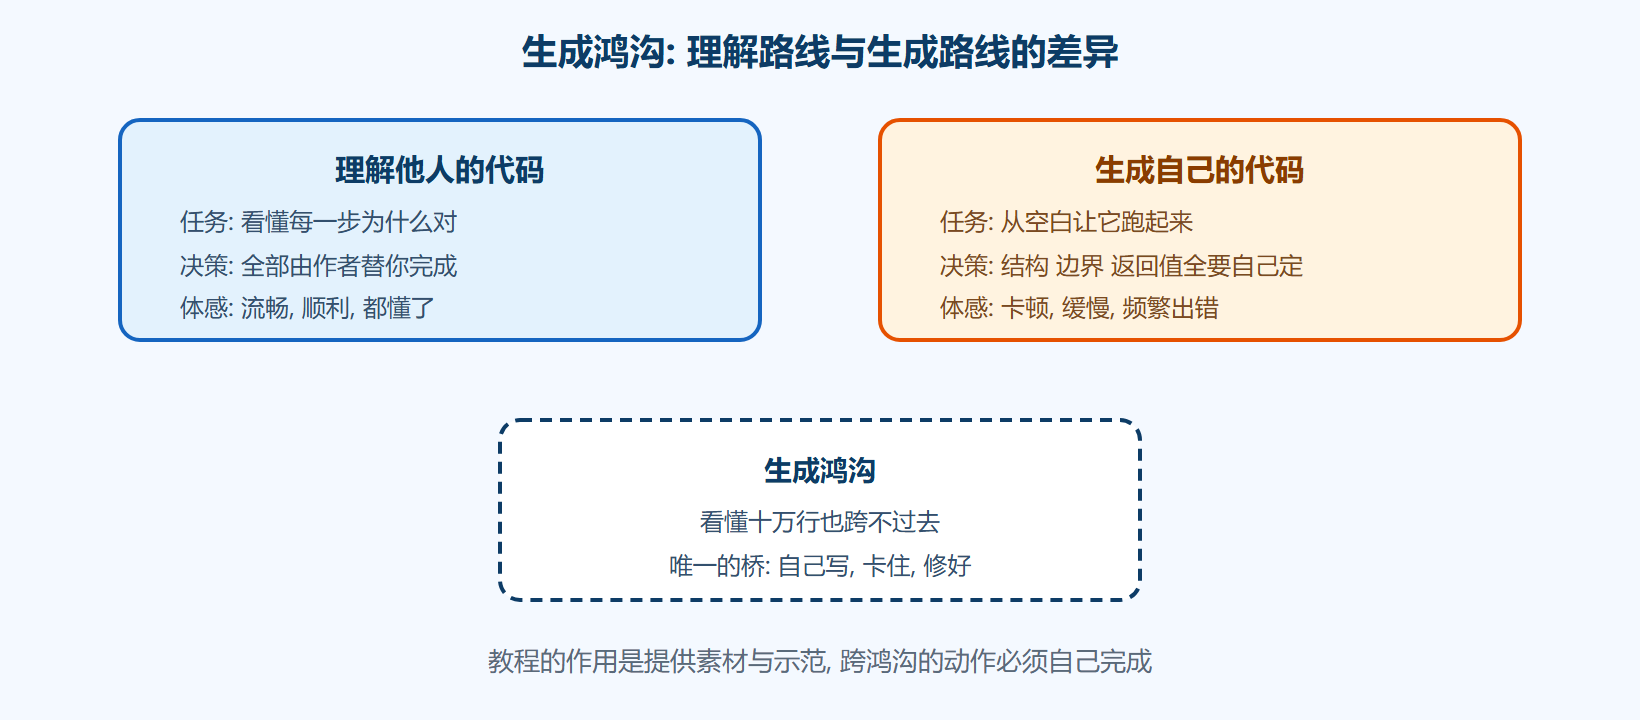
一个可以在自己身上立刻验证的现象:教程里的示例代码,逐行看都觉得明白;把屏幕关掉,让自己从零写出同样功能的程序,绝大多数初学者写不出来。这不是记性或智商问题,而是两种不同的认知任务:
- 理解代码:顺着别人搭好的路走。每一步都有提示,方向是"看懂它为什么对"
- 生成代码:在没有路的地方开路。你要自己决定用什么结构、先做什么后做什么,方向是"让它跑起来"
后者多出来的是决策负荷——数据用什么类型存?循环的边界在哪里?这个函数该返回什么?教程把这些决策替你做了,所以你从没练过它们。就像看别人开车时全程都觉得简单,自己握方向盘时才发现光是"什么时候看后视镜"就有无数决策要做。
这道"生成鸿沟"没有绕行的路,只有一个笨办法穿过去:自己写。写得慢、写得烂、频繁卡住,都是穿墙的正常代价。
从看懂到写出的能力断层
二、输入与实践的配比
那教程还看不看?看,但要控制比例。练习期的健康配比大约是一比二:每看一小时教程或文档,配两小时动手。可以落到更具体的颗粒度——教程每讲完一个完整示例,就暂停一次,做一个"微实践"。
微实践的规格:不超过二十行代码、围绕刚讲的一个知识点、有一个明确的预期输出。例如刚学完字符串分割与字典统计,微实践就是"统计一段文字里每个词出现的次数":
text = "to be or not to be that is the question" counts = {} for word in text.split(): counts[word] = counts.get(word, 0) + 1 print(counts)
{'to': 2, 'be': 2, 'or': 1, 'not': 1, 'that': 1, 'is': 1, 'the': 1, 'question': 1}
二十行以内的任务把"从零生成"的决策负荷压到刚好能承受的范围,又不至于像完整项目那样让人无从下手。
三、三级脱钩:从抄到写的平滑过渡
直接从"看教程"跳到"凭空写"落差太大,中间用三级脱钩铺坡:
- 照抄级:逐行抄示例,但抄之前先口述每行的作用,抄完改一处参数观察输出变化
- 半脱钩级:看懂示例后关掉它,凭记忆重写同样功能;卡住时只允许看"结构提示"(用了什么结构),不允许看具体代码
- 全脱钩级:只看需求描述(不看任何实现),自己写出程序,再对照示例找差距
三级之间自然晋级的标准是"不看参考能一次写对",而不是"抄得很熟"。同样以词频统计为例,全脱钩级的变式任务可以是"统计每个词频最高的前三个词":
top3 = sorted(counts.items(), key=lambda kv: -kv[1])[:3] print(top3)
[('to', 2), ('be', 2), ('or', 1)]
这个变式引入了排序与切片两个新决策点,难度就落在了上一节说的学习区。
四、案例:一次配比调整带来的变化
背景:小周每天下班看两小时编程视频,坚持两个月,笔记记了半本,但仍写不出一个完整的函数。
操作:她把流程倒过来——每天先用十五分钟看一小节视频,剩下时间全做该小节的微实践与变式;周末把一周的微实践拼成一个小工具。
结果:第三周她独立写出了一个能跑的记账脚本,虽然代码粗糙、重复不少,但它完整地跑起来了。两个月后回看,她自己都嫌第一版写得差——而"能看出自己的代码差"这件事本身,就是能力提升的直接证据。
解读:配比反转的关键不是视频看得少了,而是视频的角色变了——从"学习的主体"降级为"练习的素材"。同时注意她的晋级路径:微实践练单点,周末拼装练整合,正好对应三级脱钩的后两级。
变式:如果学的是框架或工具,微实践的形态换成"做一个最小功能页"或"写一条命令并观察输出",配比原则不变。
⚠️ 常见坑:用"再看一遍教程"来缓解写不出来的焦虑。看第二遍的边际收益极低,写不出来恰恰说明正处在生成鸿沟里——卡住的地方就是练习开始的地方。
四、写不出来时的应急动作
三级脱钩推进中总会撞上"彻底写不出来"的时刻:盯着需求,一个字都敲不出来。这不是故障,是生成鸿沟的正常坡度。应急动作按顺序试:
动作一,把问题写小。你面对的任务多半太大——"实现词频统计"不可见,"把一句话按空格切成列表"可见。把任务砍到"下一行代码就能写"的粒度,往往砍到第三刀就能动笔。
动作二,写注释再填肉。先把整个函数的步骤用注释铺满,每行注释是一个"空着的小任务",然后逐条把注释翻译成代码。决策被拆散后,每个决策都很小。
动作三,允许写烂的第一版。先让最丑陋的版本跑起来——变量名随意、逻辑冗长都行。改烂代码比写好代码容易得多,而空白编辑器最难下笔。
# 动作二的示例: 先注释后代码 # 1. 准备一段文本 text = "to be or not to be" # 2. 切成词列表 words = text.split() # 3. 数每个词出现几次 counts = {} for w in words: counts[w] = counts.get(w, 0) + 1 # 4. 打印结果 print(counts)
{'to': 2, 'be': 2, 'or': 1, 'not': 1}
这个例子里的注释甚至不需要删——它们就是最朴素的文档。三个动作的共同原理是降低单步决策的粒度:生成代码难,从来不是难在写,是难在"一次要做太多决定"。
本节要点回顾
- 生成鸿沟:理解是走别人的路,生成是自己开路,多出来的是决策负荷
- 配比一比二:每小时输入配两小时动手,教程是素材不是主体
- 微实践规格:二十行内、单知识点、有预期输出
- 三级脱钩:照抄改参、凭记忆重写、只看需求盲写
- 写不出≠没天赋:卡住的位置就是练习的起点,也是进步最快的位置