4.2 情报网:搜索引擎与官方文档
4.2 情报网:搜索引擎与官方文档
本节摘要:搜索与读文档是两项可以练到分钟级定位问题的终身内功。本节讲搜索词的构造方法(报错原文加语境词)、搜索结果的分层甄别,以及官方文档的"三层读法"——速查、精读、通读各取所需。
补给线的第二节。鉴定解决了"选什么资源",本节解决"怎么最快找到需要的那页信息"。这两项技能的差距极其显性:同一个报错,有人十分钟解决,有人一下午无果,分水岭几乎总在搜索词和文档读法上。
一、搜索词的构造:从描述到信号
新手搜索的典型做法是把自己的困惑原样输入:"程序打不开了怎么办"。这种搜索得到的是泛泛的营销页。高效的搜索词要给搜索引擎喂信号,构造公式是:
报错关键句 + 技术名 + 语境词
- 报错关键句:报错最后一行的异常类型与描述,去掉与你环境相关的具体数字和路径
- 技术名:涉及的库、框架、语言的准确名称与版本号
- 语境词:你在做什么操作时出现的——安装、迁移、并发,等等
构造过程演示。原始报错:
ModuleNotFoundError: No module named 'requests'
朴素搜索词是"找不到模块怎么办",命中率极低。按公式重构:
ModuleNotFoundError No module named requests pip 已安装
这个词组包含异常类型原文、缺失的模块名、以及语境词"已安装"(表明不是没装,而是装了却找不到——这指向环境错配、多解释器并存一类的原因)。搜索结果会直接命中一批同症状且根因相同的讨论帖。
语境词的取舍原则:加你自己已经排除掉的部分。"已重装仍报错"比"报错"多排除一个变量,能砍掉一半无关结果。这也是 3.3 节排查法的延续——搜索词质量取决于你对问题已经排除了什么。
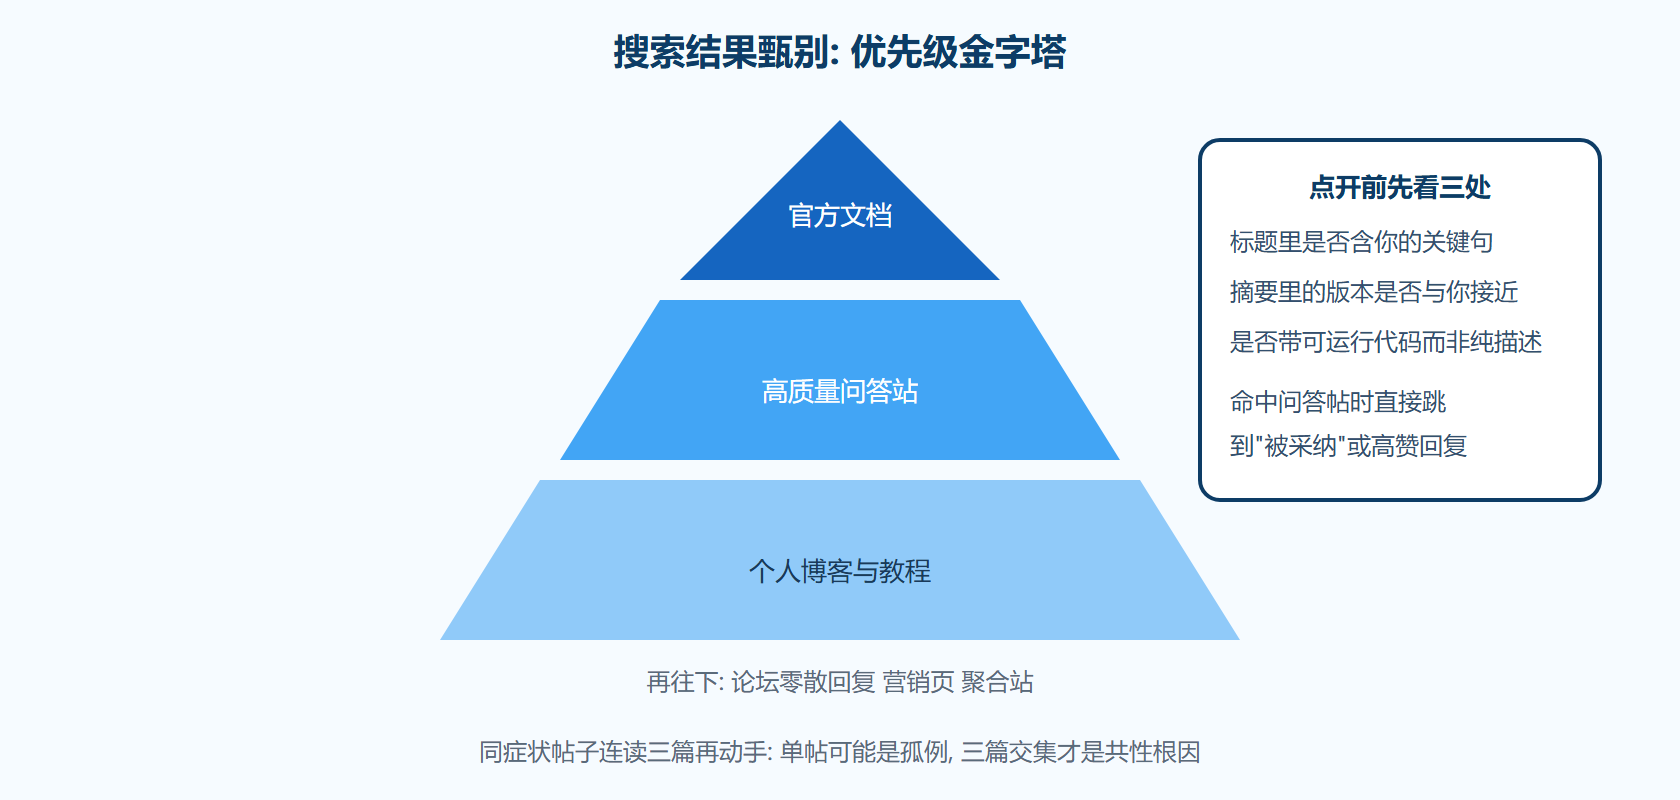
搜索结果的分层甄别
二、官方文档的三层读法
对官方文档的两种极端态度——"太干瘪不敢碰"和"当成小说从头啃"——都不可取。成熟的文档体系有不同的读法档位:
第一层,速查:你已经会用,只记不清细节。用文档站的搜索或索引直接跳到条目,看签名和示例就走。这一层占日常使用的七八成。
第二层,精读:学一个新特性。读它的"为什么存在"(多数文档条目开头都有动机说明)、参数表、以及最关键的边界条件——什么情况下行为不同、会抛什么异常、版本变更记录。示例代码务必亲手跑一遍并改一个参数。
第三层,通读:进入某个领域的入门期,把文档的教程部分(通常叫入门指南或快速上手)从头过一遍。这一层最像读书,但对象是官方教程部分而非参考手册——参考手册是字典,没人通读字典。
一个把读法用准的实例。想确认"列表的排序方法是否改变原列表",速查即可:
nums = [3, 1, 2] result = sorted(nums) # 返回新列表 print(nums, result) nums.sort() # 原地排序, 返回空 print(nums)
[3, 1, 2] [1, 2, 3] [1, 2, 3]
两个函数的差异(新建与原地、返回值有无)在文档的对比示例里就写着——但只有亲手跑过,"返回空"这个反直觉细节才会真正进入记忆。文档给事实,实验给记忆。
三、案例:一次二十分钟的检索定位
背景:小杨的脚本在本机正常,同步到另一台机器就报权限相关异常。她给自己二十分钟预算,目标是不求助别人自行解决。
操作:第一步按公式构造搜索词——异常原文加脚本类型加语境词"另一台机器正常";第二步按金字塔顺序浏览,先确认官方文档里该异常的说明(指向权限配置),再到问答站搜同异常,连读三篇命中帖,交集指向具体配置项;第三步按帖子给的验证命令在本机与故障机各跑一次,对比输出,确认差异就是根因,照帖调整配置后恢复。
结果:十九分钟解决,全程没有发帖求助。她把"症状、根因、修法"各一句记进排错手册——3.3 节的习惯在这里闭环。
解读:流程能走通靠的不是运气,是两个前置动作:搜索词里带了"另一台机器正常"这个排除信息(直接命中环境差异类讨论);连读三篇再动手(单帖顶部那个被标为解决的答案,恰好不适用于她的场景,第二篇的评论里才出现匹配情形)。
变式:查不到结果时,把搜索词里的语境词换掉再试一轮("安装时"换成"升级后"),或把报错逐段拆开搜——长报错里的中间帧往往指向真正的出错模块。连续三轮空手而归,就转入下一节的社区提问流程。
⚠️ 常见坑:照抄搜索到的命令与配置而不理解其作用。排错场景下这等于把陌生代码直接跑在自己环境里——至少要能说清"这条命令改什么、影响什么"再执行。
四、进阶检索技巧三则
基础公式之外,三则进阶技巧在关键时刻能翻盘:
技巧一,限定站点检索。想只搜问答站的内容,在搜索词后加限定站点的语法(多数引擎支持"站点限定词加域名"的写法),直接把结果锁定在高信源内。排错时这一招能把营销页全部滤掉。
技巧二,版本锁定。搜索词里带上确切版本号,比如库名加大版本号。不同大版本的行为差异常常正是问题根源,泛搜会被旧版本的答案误导。
技巧三,报错拆段。长报错的追踪栈里,中间帧指向的往往不是你写的代码,而是库的内部——把最底部你自己代码的那一帧单独拎出来搜,命中率远高于搜整段。一个演示:
原始报错(节选): File "lib/http/client.py", line 331, in _get_hostport File "app/main.py", line 58, in fetch ConnectionError: 连接尝试失败 低效搜索: 整段报错原文粘贴 高效搜索: fetch ConnectionError 连接尝试失败 库名 版本号
三则技巧的共同思想:搜索引擎不懂你的问题,只懂你的词——每一步优化都是在替它消除歧义。这也是检索能力无法被工具替代的原因:消除歧义需要的上下文,恰好就是你排查问题时积累的理解。
本节要点回顾
- 搜索词公式:报错关键句加技术名加语境词,语境词写你已排除的部分
- 结果金字塔:官方文档、高质量问答、个人博客,逐层降权
- 三篇交集才是共性:单帖结论可能是孤例或过时
- 文档三层读法:速查占八成,精读抓边界条件,通读只读入门指南
- 文档给事实,实验给记忆:示例代码亲手跑一遍才算读过