5.2 属性面板:算法与数据结构基础
5.2 属性面板:算法与数据结构基础
本节摘要:数据结构决定操作的成本,选型的依据是"你的程序对数据做什么操作最频繁"。本节讲复杂度的实用读法、常见结构的操作成本对照,并用两数之和的解法演进演示"结构选对,算法自然短"。
Boss 战第二场。上一节把问题分解成了带规格的子任务,本节解决子任务实现时的第一个选型决策:数据放什么结构里。这不是面试专用知识——选错结构的代码在真实项目里就是"数据量一大就卡死"。
一、复杂度:只看量级,不算常数
复杂度描述的是"数据量翻倍时,耗时怎么变"。实用层面记量级就够了:
- 常数阶:数据量再大,耗时不变(如哈希表查一个键)
- 对数阶:数据量翻倍,耗时只加一步(如有序数组的二分查找)
- 线性阶:耗时随数据量正比增长(如遍历一遍列表)
- 线性对数阶:良好排序的量级
- 平方阶:数据量翻倍,耗时变四倍(如双层嵌套遍历)
量的敏感度可以这样建立:十万条数据下,线性操作毫秒级完成,对数操作无感,平方操作要数秒起步——同一个问题,平方解法与线性解法在十万量级上的差距是肉眼可见的卡与不卡。这就是为什么"能跑"的代码和"能用"的代码之间隔着一张属性面板。
常见结构的操作成本对照
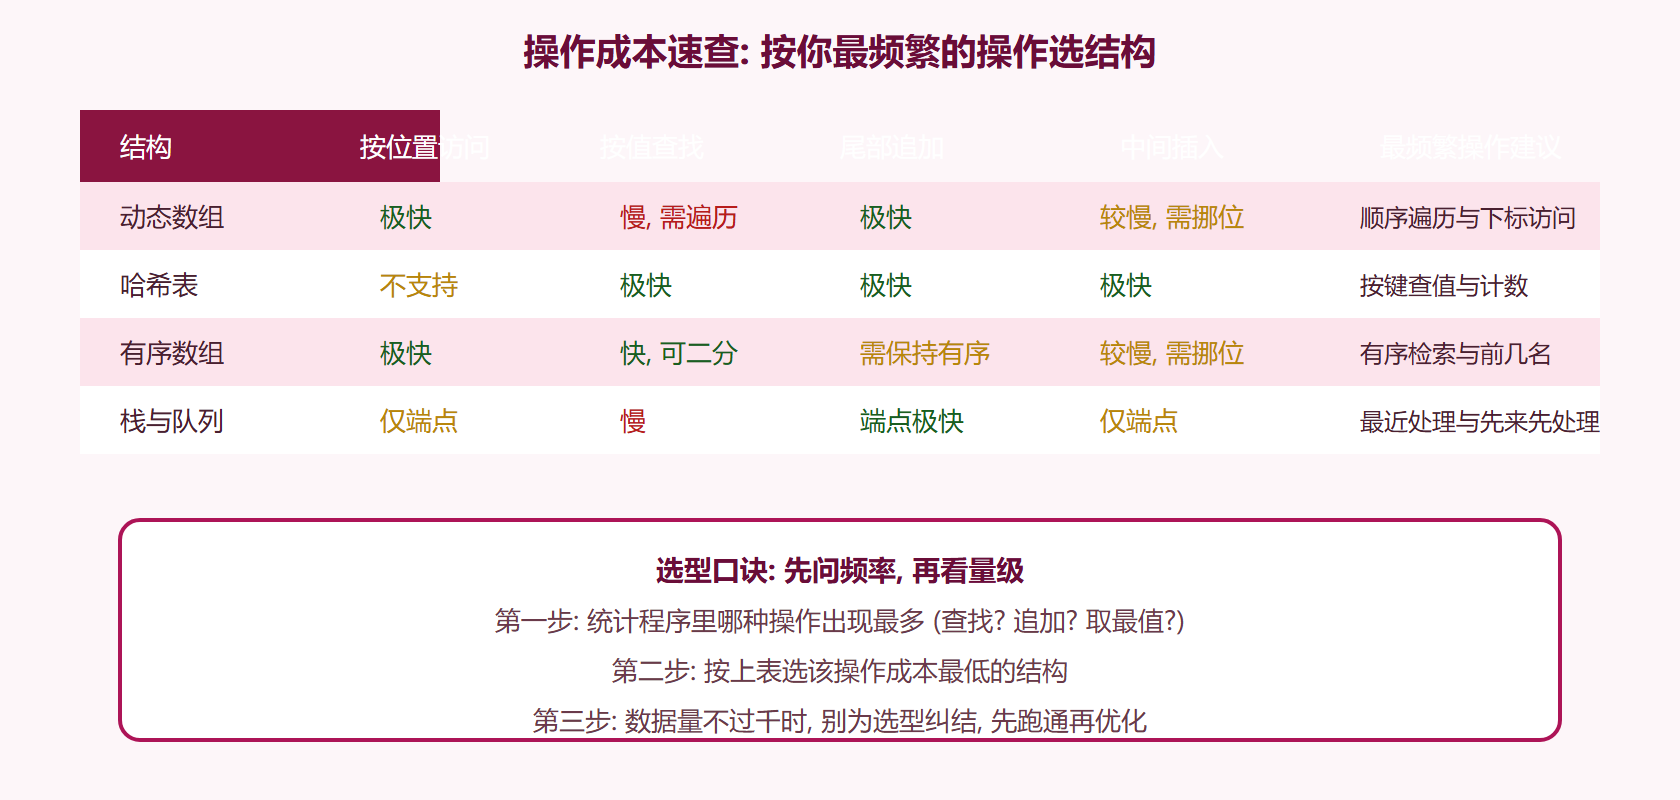
表里最后一行是重要的工程常识:小数据量下结构差异几乎测不出来,过早优化结构是新手另一个时间黑洞。结构选型的正确时机是:量级将超过万,或性能已实际成为瓶颈。
二、解法演进实战:两数之和
用一道经典题演示"结构升级如何驱动算法变短"。问题:给定整数列表与目标值,找出和为目标值的两个数,返回其下标。
第一版,穷举——对每个数,扫描其余所有数配对:
def two_sum(nums, target): for i in range(len(nums)): for j in range(i + 1, len(nums)): if nums[i] + nums[j] == target: return (i, j)
正确,但双层循环是平方阶:数据量翻倍,耗时翻四倍。千级数据尚可,十万级就会卡。
第二版,哈希换时间——把"找一个配对数"变成"查一次表":
def two_sum(nums, target): seen = {} # 记录: 数值 -> 下标 for i, x in enumerate(nums): if target - x in seen: # 配对数之前出现过吗 return (seen[target - x], i) seen[x] = i print(two_sum([2, 7, 11, 15], 9))
(0, 1)
循环只剩一层,每次迭代里的查找是常数阶——整体降为线性阶。注意算法思路也随之变短:不再是"两两试",而是"走到每个数时问一句:我要的搭档来过没有"。结构从数组换成哈希表之后,算法本身从嵌套思考变成了单次扫描,这就是"结构选对,算法自然短"的含义。
三、案例:一个真实项目的结构改版
背景:小杨的背单词工具新增"检查生词是否已在词库",她把词库存成列表,检查用逐个比对。词库两千条时无感,导入一本词书涨到五万条后,每录一个词都要卡顿数秒——她第一反应是"语言性能不行"。
操作:她按选型口诀走:第一步统计操作频率,录入场景里"按值查找"每次录词都发生,是绝对高频;第二步查对照表,哈希表的按值查找是极快档;第三步改造——词库加载时顺手建一个集合:
words_set = set(words) # 载入时一次性建好 new_word = "ephemeral" if new_word in words_set: # 常数阶判定 print("已在词库") else: print("新词, 已加入")
新词, 已加入
结果:五万条词库下,单次判定从数秒降到无感,代码改动两行。
解读:她最初的诊断("语言慢")方向就错了——性能问题先查操作成本,再怪运行时。这正是属性面板的作用:把"感觉慢"翻译成"高频操作落在慢档结构上",修法就自己浮出来了。注意她建集合放在加载时而非每次查询时,"一次构建、多次使用"是这类改版的通用形态。
变式:同族问题还有——排行榜取前几名(有序结构或堆)、任务按到期日处理(按日期排序后遍历)、撤销功能(栈)、消息排队(队列)。识别特征都是"某一种操作显著高频"。
⚠️ 常见坑:为显示时保持顺序而拒绝换结构——其实可以"存储用哈希、显示另排序",两份数据各司其职。结构不是身份,是工具。
三点五、学习算法的顺序建议
属性面板上的条目众多,全背下来再实战是最差的路线。按"使用频率乘理解收益"排一个推进顺序:
第一批,增删改查四件套:动态数组、哈希表、它们的组合使用。日常开发八成的数据操作由这两个结构承担,2.2 节的计数、5.2 节的两数之和都在此列。练到"看见按键查值就条件反射想到哈希表"即可过关。
第二批,有序的世界:排序的稳定性含义、二分查找的前提与写法、"排序加扫描"这个万能套路(排序后相邻比较、双指针夹逼)。这批的价值在于建立"先让数据有序,问题常常自己变简单"的直觉。
第三批,受控的顺序:栈与队列。它们出现在撤销功能、任务排队、树的遍历等场景里,概念极简,靠两三个手写练习(用栈实现括号匹配)即可内化。
第四批,按需选修:堆(取前几名问题)、树(层级与索引的底层)、图(关系类问题)。这批等真实项目用到时再学,带着问题学的效率是干背的数倍。
每批的练习规格沿用 2.3 节:十道题的自测分区、弱点标签、连对三次过关。算法学习的最大陷阱不是难,而是顺序错乱——在哈希表都没练熟时去啃图论,等于打高于自己二十级的怪。
六、用数据形态反推结构
选型口诀之外还有一个更快的直觉通道:看数据的形态。数据长什么样,往往直接暴露它该住进什么结构。
形态一,"成对的键与值"——配置项、计数器、缓存映射,一律哈希表,几乎没有例外。形态二,"有先后顺序的流"——待处理任务、历史记录,队列或列表。形态三,"需要回头处理的最近项"——撤销栈、括号匹配,栈。形态四,"天然有序且频繁查询"——排行榜、时间线,有序数组或按序插入的列表。形态五,"有隶属层级"——文件系统、组织架构,树。
这个反推通道的实用价值在于它先于量化分析:很多题在读完题目的瞬间,数据的形态就已经替你选好了结构,复杂度分析只用来复核。把五个形态各配一个你已经写过的程序对上号(比如词频统计对应形态一),下次读题时它们会自动浮现。
本节要点回顾
- 复杂度记量级:数据量翻倍时耗时的变化规律,决定十万级数据卡不卡
- 选型口诀:先统计最频繁的操作,再按成本表选结构
- 结构驱动算法:换对结构后算法常常自己变短,两数之和即例证
- 一次构建多次使用:集合、索引、排序结果都建在数据载入时
- 小数据别纠结:量级不过千先跑通,结构优化等瓶颈真出现