5.1 SLAM 问题与状态估计
5.1 SLAM 问题与状态估计
本节摘要:SLAM 是在未知环境中同时估计自身位姿与地图的联合状态估计问题。本节把它写成贝叶斯滤波的形式,讲清预测与更新两步、卡尔曼家族与粒子滤波两条求解路线,并点破真正的难点——数据关联。
远征最惊险的赛段开跑。设想队伍走进一片没有地图的峡谷:想知道自己在哪,得有地图;想画地图,得知道自己在哪。这对互为前提的循环不是逻辑悖论,而是可以联立求解的估计问题——把"位姿与地图"看成一个联合状态,用全部历史观测推断它的概率分布,这就是 SLAM 的数学本体。
把蛋鸡问题写成公式
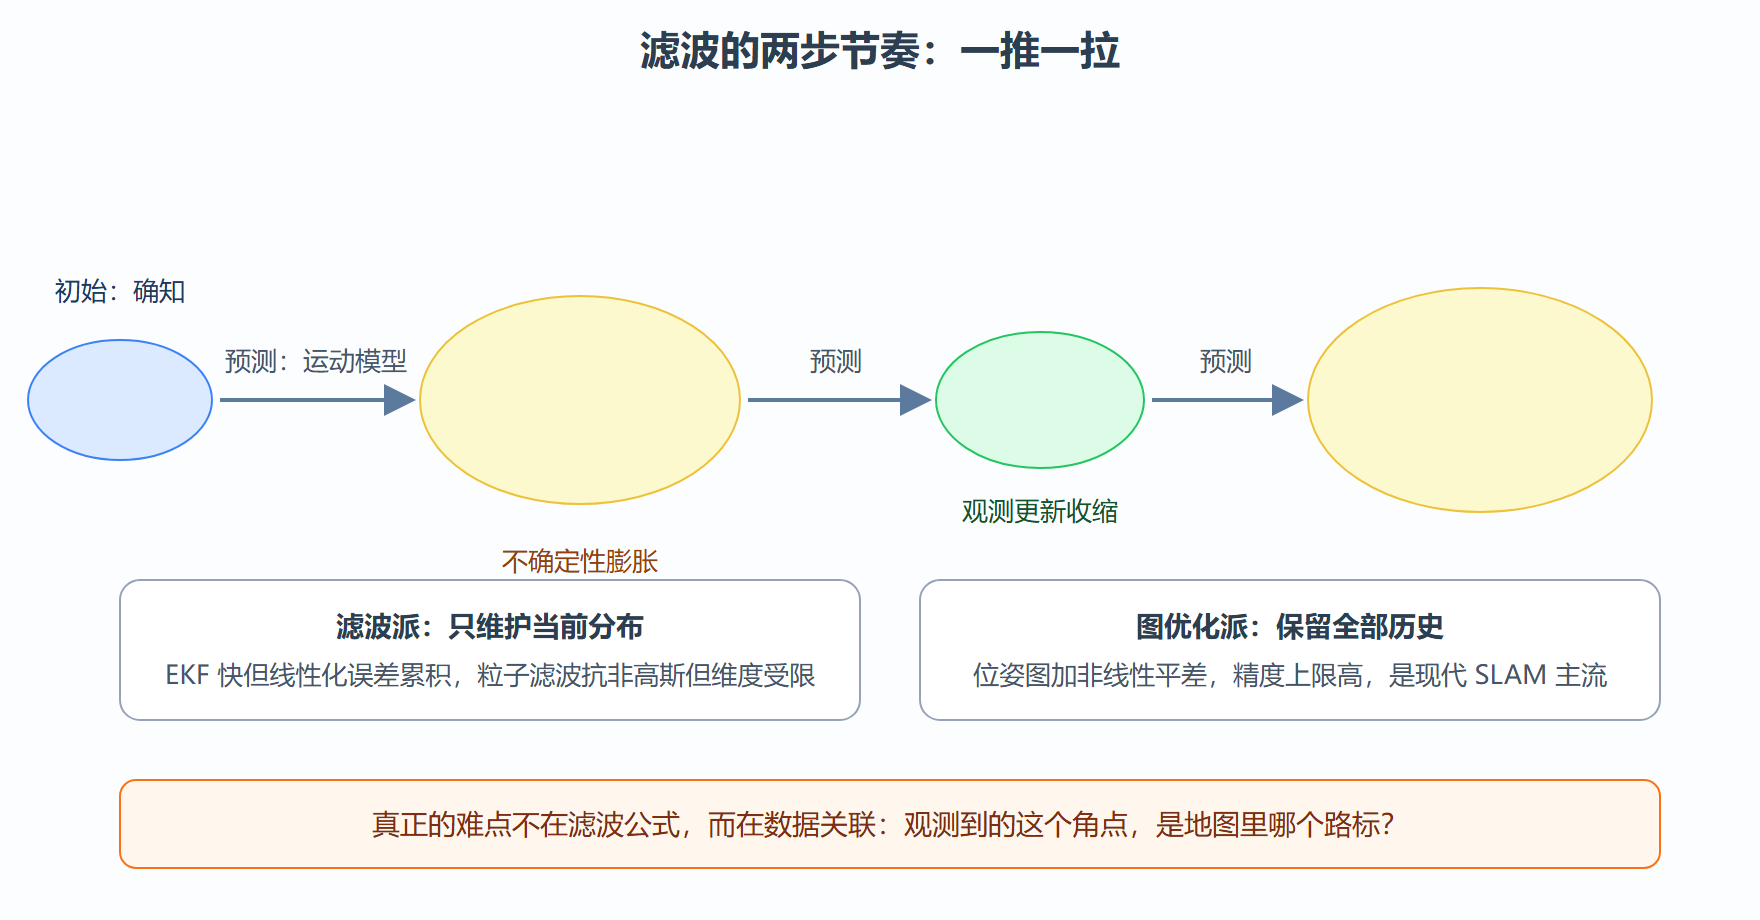
用概率语言:给定到当前时刻为止的全部控制输入(轮速、IMU 读数)与观测(图像、点云),求当前位姿与地图的联合后验分布。直接维护这个高维分布不可行,实用解法分两大家:滤波派只维护当前时刻的分布,用预测与更新两步滚动前进;图优化派保留全部历史,构成位姿图后离线(或关键帧级在线)做全局平差——5.5 节的主角。
滤波两步的直觉:预测步用运动模型把状态"向前推"(不确定性膨胀,因为轮子会打滑、IMU 有漂移);更新步用观测把状态"往回拉"(不确定性收缩,因为看到了认识的路标)。一推一拉,就是卡尔曼滤波的全部节奏。
一个能跑的一维滤波示例
背景:机器人沿走廊匀速走,IMU 有噪声,偶尔看到一面已知位置的墙(观测)。用一维卡尔曼滤波融合两者,体会"一推一拉"。数值可复算。
import numpy as np x, P = 0.0, 0.01 # 初始位置 0 米,方差 0.01 u, q = 0.5, 0.04 # 每步名义位移 0.5 米,过程噪声方差 0.04 r = 0.06 # 墙观测噪声方差 truth = 0.0 rng = np.random.default_rng(7) for k in range(1, 7): truth += 0.5 + rng.normal(0, 0.1) # 真实步长带扰动 x = x + u # 预测:均值前推 P = P + q # 方差膨胀 if k % 2 == 0: # 每两步看到一次墙 z = truth + rng.normal(0, np.sqrt(r)) # 观测 = 真值加噪 K = P / (P + r) # 卡尔曼增益 x = x + K * (z - x) # 更新:向观测收缩 P = (1 - K) * P print(f'步 {k}: 估计 {x:5.2f} ±{np.sqrt(P):.3f} 真值 {truth:5.2f}') # 输出: # 步 1: 估计 0.50 ±0.202 真值 0.46 # 步 2: 估计 1.03 ±0.203 真值 1.02 # 步 3: 估计 1.53 ±0.229 真值 1.48 # 步 4: 估计 2.02 ±0.230 真值 1.95 # 步 5: 估计 2.52 ±0.250 真值 2.51 # 步 6: 估计 3.01 ±0.250 真值 2.97
结果解读:没有观测的奇数步,不确定度从零点二涨到零点二五——纯推算必漂;偶数步的墙观测把估计拉回真值附近。六步后误差三厘米,而纯航位推算误差约十几厘米。这就是"定位需要外部锚点"的最小证明,也是 SLAM 必须建图的原因:荒野里没有现成的墙,就得自己造路标。
两条求解路线与数据关联
扩展卡尔曼(EKF):把非线性模型在当前估计处线性化后跑标准卡尔曼。快、省内存,但线性化误差累积、状态维度大了会爆炸,早期视觉 SLAM 的主流。粒子滤波:用一群带权样本表示分布,天然处理非高斯与多峰(比如"我在两个长得一样的走廊里的哪一条"),但样本数随维度指数增长,实用上限在三维上下。现代系统的选择:前端轻量滤波做高频预测(IMU 预积分,5.4 节),后端图优化做精确平差(5.5 节)——两派不是敌人,是分工。
真正的深水区是数据关联:把观测对应到错误的路标,滤波器会"自信地"收敛到错误位置——错误关联的代价不是精度下降,是整个解的报废。视觉里靠描述子距离筛(3.2 节),激光里靠几何一致性检验(5.3 节),回环检索则是全局尺度的数据关联(5.5 节)。
⚠️ 常见坑:调了三个月滤波参数,最后发现是特征关联阈值太松,把隔壁的路标配给了本帧。排查顺序永远是:先查关联质量,再查模型噪声参数,最后才动滤波器结构。
💡 关键直觉:SLAM 的"蛋鸡循环"破局靠的是相对观测——虽然不知道绝对位置,但"走三米后看到同一根柱子"这种相对约束本身就在收缩联合分布。
概念速查:这一节的名词地图
把本节出现的方法按"维护什么、算多快、怕什么"排一张速查表,方便与后续四节对照。扩展卡尔曼维护单个高斯分布,毫秒级,怕强非线性与错误关联;粒子滤波维护样本集合,取决于粒子数,怕维度诅咒;信息滤波维护稀疏信息矩阵,适合大量路标场景,怕稠密关联更新;图优化保留全部历史节点,秒级到分钟级,怕初值差与错误回环边。四者的共同输入都是"运动模型加观测模型",差别只在概率分布的表示方式。读后文遇到任何前端后端组合,都可以回到这张表问一句:它用哪种表示、为什么、代价是什么——这个问题问熟了,SLAM 的系统设计就入门了。再给一个课堂常见疑问的正面回答:"先定位还是先建图"的循环到底怎么起步? 答案是 bootstrap(自举)——从最可信的少量观测开始:第一帧定义世界原点(地图由此有了锚),第二帧用相对运动把地图撑出尺度(第二章双目同理),随后每帧都是"用现有地图定位自己、再用自己的观测增厚地图"的双向滚动。起点不完美没关系,滤波与优化的全部意义就是让不完美的起点在后续观测中自我修正——这恰是"估计"区别于"计算"的本质。带着这个视角再回看那行概率公式,你会发现它读起来更像一份合同:观测在右、信度在左,每来一帧数据,系统就按合同重签一次对世界的信任程度——SLAM 的全部工程,就是把这份合同签得又快又准。下一节先给系统装上眼睛,看视觉前端如何完成第一帧帧间的运动估计。
本节要点回顾
- SLAM 是位姿与地图的联合后验估计,蛋鸡循环靠相对约束破局;
- 滤波两步:预测膨胀、更新收缩,外部锚点是收缩的唯一来源;
- EKF 与粒子滤波各有边界,现代系统滤波做前端、图优化做后端;
- 数据关联是真正的难点,错误关联导致自信的错误;
- 本节框架装载 5.2 视觉前端与 5.3 激光前端两套传感器实现。