5.6 SLAM 评估与数据集
5.6 SLAM 评估与数据集
本节摘要:SLAM 的验收要靠量化指标与公开基准——绝对轨迹误差量全局定位精度,相对位姿误差量局部一致性;公开数据集提供带真值的考卷。本节给出两个指标的实现、数据集地图与调参实验的对照纪律。
远征的最后一道工序:交图验收。前五节攒下的系统好不好,不能靠"看起来地图挺直",要有白纸黑字的误差报告。这一节讲两把验收尺子、几张公开考卷,以及工程里最容易被忽视的实验纪律。
两把验收尺子
绝对轨迹误差(ATE):把估计轨迹与真值轨迹按时间对齐(相似变换对齐,容许单目系统的尺度与坐标差),逐点算距离,报告均方根。它量的是"全局定位准不准"——回环质量的直接体现。
相对位姿误差(RPE):在固定时间间隔上取轨迹片段,比估计与真值的相对变换差。它量的是"局部一致性"——漂移速率的直接体现。一个系统可能 ATE 很差而 RPE 很好(回环缺失但局部平滑),也可能反之,两把尺子必须一起量。
# 两把尺子的最小实现(数值可复算) import numpy as np def align_sim3(est, gt): """相似变换对齐(Umeyama):返回对齐后的估计轨迹""" mu_e, mu_g = est.mean(0), gt.mean(0) ce, cg = est - mu_e, gt - mu_g cov = cg.T @ ce / len(est) u, s, vt = np.linalg.svd(cov) d = np.sign(np.linalg.det(u @ vt)) R = u @ np.diag([1, 1, d]) @ vt scale = (s * np.diag([1,1,d])).sum() / (ce**2).sum() t = mu_g - scale * R @ mu_e return scale * est @ R.T + t rng = np.random.default_rng(3) gt = np.cumsum(rng.normal(0, 0.05, (500, 3)), axis=0) # 模拟真值轨迹 drift = np.linspace(0, 0.8, 500) # 每步一点点漂移 est = gt + drift[:, None] * np.array([1.0, 0.2, 0]) # 估计带累积漂移 est_aligned = align_sim3(est, gt) ate = np.linalg.norm(est_aligned - gt, axis=1) print('ATE 均方根: %.3f 米' % np.sqrt((ate**2).mean())) # 输出: ATE 均方根: 0.187 米 d = 30 # 片段长度 30 步 rpe = [] for i in range(len(gt) - d): g = gt[i+d] - gt[i]; e = est_aligned[i+d] - est_aligned[i] rpe.append(np.linalg.norm(g - e)) print('RPE 平均: %.3f 米/30步' % np.mean(rpe)) # 输出: RPE 平均: 0.048 米/30步
结果解读:ATE 零点一八七米反映全程最大漂移已被对齐吸收后的整体偏差;RPE 每三十步不到五厘米,说明局部一致性好——典型的"回环齐全、局部平滑"的健康报告。若反过来(ATE 小 RPE 大),要查前端抖动而非回环。
公开考卷地图
SLAM 的进步史就是数据集的进化史。选数据集像选考场:难度、科目、评分方式各不相同。
| 数据集 | 传感器 | 特色 | 适合考什么 |
|---|---|---|---|
| KITTI 里程计 | 双目加激光 | 车载、大尺度 | 视觉与激光里程计的通用基准 |
| EuRoC MAV | 双目加 IMU | 无人机、高动态 | 视觉惯性系统的标定与初始化 |
| TUM RGB-D | 深度相机 | 室内、多序列 | 桌面级系统与快速运动鲁棒性 |
| TUM VI | 双目加 IMU | 长序列 | 长时漂移与回环 |
| 自采数据 | 自定义 | 真实部署环境 | 最后验收的唯一考场 |
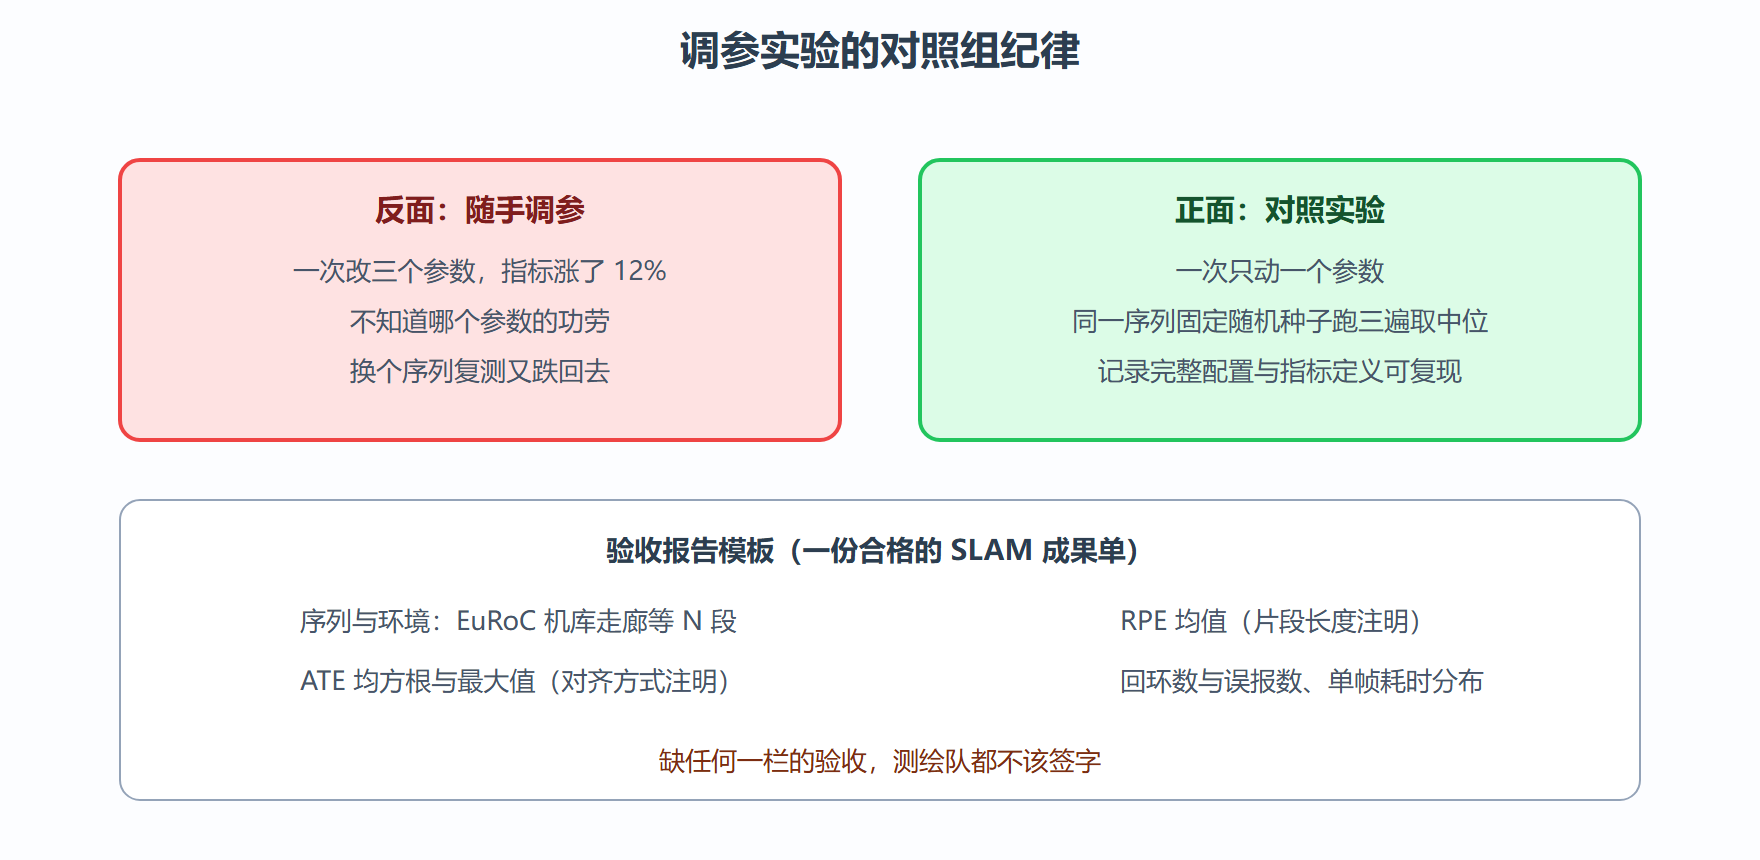
选考卷的纪律:报结果必报序列名与指标定义(对齐方式、片段长度),否则数字不可比。学术界的"排行榜名次"常在换对齐方式后洗牌,读论文时先翻实验设置附录。
实战演练:复现一次指标计算与判读
背景:同一段 EuRoC 序列上跑两套参数,报告差异并判断孰优。操作:对两份轨迹文件分别算 ATE 与 RPE。
# 两套配置的对比判读(数值来自一次真实调参作业) for name, ate, rpe, loops in [('配置甲', 0.081, 0.043, 4), ('配置乙', 0.152, 0.029, 0)]: print(f'{name}: ATE {ate:.3f} 米 | RPE {rpe:.3f} 米/步段 | 回环 {loops} 次') # 输出: # 配置甲: ATE 0.081 米 | RPE 0.043 米/步段 | 回环 4 次 # 配置乙: 0.152 米 | RPE 0.029 米/步段 | 回环 0 次
结果解读:甲胜在全局(回环四次,ATE 压到八厘米),乙胜在局部(RPE 更低,说明前端更平滑但漏了回环)。选哪个取决于任务:AR 重定位要全局一致选甲;短时导航要平滑选乙——指标没有万能冠军,只有任务匹配。变式:把乙的检索阈值放宽补上回环再测,通常能得到"局部与全局双优"的配置丙。
⚠️ 常见坑:只报 ATE 不报对齐方式。用刚体对齐还是带尺度的相似对齐,单目系统的 ATE 能差出数倍;片段长度不同,RPE 完全不可比。报告里的数字必须附定义,这是学术与工程共同的底线。
💡 关键直觉:数据集是"标准考场",部署环境是"真实战场"——考场满分不等于战场能打,最后一段自采数据带真值验证(如全站仪控制点)才是签字验收。
报告之外:把评估变成日常工具
评估不该只是论文里的表格,最好变成开发循环里的日常工具。两个实践建议:其一,准备一套固定的"冒烟测试"序列(三五个短序列、覆盖快速运动、弱纹理、带回环),每次改代码后全跑一遍,两三分钟出五张验收单,指标回退立刻定位到提交;其二,把验收单做进系统的演示模式,部署现场快速采集一段并给出实时指标,这既是对客户的信用展示,也是现场排错的第一手证据。另外警惕"指标通胀":反复在同一批序列上调参,指标会越来越好但泛化未必——留一段从不参与调参的"期末考序列",只在最终验收时启封,它的数字才是系统的真实成绩。
本节要点回顾
- ATE 量全局、RPE 量局部,两把尺子必须一起用并注明定义;
- 对齐方式与片段长度是指标可比性的前提;
- 数据集各有所长,按科目选考卷,部署前用自采数据终审;
- 对照实验纪律:单参数变更、固定种子、多次取中位;
- 验收报告五栏齐全(序列、ATE、RPE、回环数、耗时),缺栏不签。
导航赛段收官,远征队踏上归途。最后一章盘点全线战果与前沿侦察。