1.1 智能体的定义与构成
1.1 智能体的定义与构成
本节摘要:AI 智能体是能通过传感器感知环境、通过执行器作用于环境、并为目标持续选择行动的实体。更严的写法是:它实现从感知序列到行动的映射。构成上拆成硬件、软件与知识三层;软件里再拆传感器接口、推理/决策、执行与学习。没有目标的程序只是过滤器,没有闭环的模型只是函数。
学习目标
阅读完本节,你应当能够:
- 用感知、行动、目标三要素判断一个系统算不算智能体
- 写出感知序列到行动的映射在循环里对应哪一段
- 指出传感器、执行器、知识库、推理引擎、学习模块各自的职责
- 用仓库分拣或温室控制举一个最小闭环,而不是只背定义
先画循环,再下定义
把智能体想成仓库里的分拣车。车上有摄像头和重量传感器,轮子和抓爪是执行器,任务是「把货放到正确货位且不撞人」。它每时每刻都在做三件事:看、选、动。看的结果不是给人类看的报表,而是下一步还能不能开;选不是一次性考试,而是连续若干步;动会改变下一秒看到的画面。这三件事咬成环,才叫智能体。
教科书里常写:智能体 = 感知 + 行动 + 目标。三项缺一,名字就会滑。只有感知、没有行动,是监测探头;只有行动、没有感知,是定时开关;有感知和行动、没有目标,是随机扰动。目标不必是一句口号,可以是「到达货位」「室温维持在区间」「对局获胜」。重要的是:后续所有选择都朝它收拢。
更严的写法来自智能体作为函数:把到目前为止的感知序列映射成当下行动。感知序列强调记忆——同一帧画面,历史不同,行动可以不同。简单反射智能体假装序列长度为 1,只看当前帧;这在后文会变成一种刻意的简化,而不是「更高级」。
观测 o_t 环境 ──────────► 智能体 ▲ │ │ │ 行动 a_t └─────────────────┘ 奖励 r_t 可能同时回来
循环画出来之后,状态、奖励、策略才有地方坐。状态是智能体对「现在世界对我意味着什么」的内部压缩;策略是「在这个状态下我倾向选哪个行动」;奖励是环境或评判器对刚才那一步的评分。三者不是三个独立产品,是循环上的三个接口。第 4 章会讲怎么改策略,但改的前提是:你已经承认有这么一个环。
💡 关键直觉:问「这算不算智能体」时,不要先问它用了什么网络,先问它有没有与环境的闭环,以及闭环是不是朝某个目标收。
映射函数落在循环的哪一段
把映射写清楚,是为了后面不把「训练」和「决策」混为一谈。感知序列进来,行动出去——这是在线运行时发生的事。训练可以发生在环外(先用标注数据学一个感知器),也可以发生在环上(每一步拿奖励更新)。无论哪种,运行时仍然是:当前内部状态 → 行动。
概念上可以写成下面这段伪代码,它不是某个框架的 API,只是把循环钉死:
初始化 内部记忆 M 为空 循环: o = 环境.给出观测() s = 认知.把观测与记忆收成状态(o, M) a = 策略.在状态上选行动(s) 环境.执行(a) r = 环境.给出奖励() # 有的任务没有显式奖励 M = 学习.按需要更新(M, s, a, r, o)
这里有几处容易踩空。第一,观测不等于状态。摄像头的像素是观测;「货架 A 第三层有空位、前方 1.2 米有行人」才接近状态。第二,策略可以是一张规则表,也可以是一个网络,还可以是「先规划再取第一步」——形态不改变它在循环里的位置。第三,奖励可以缺失:基于目标的规划智能体用「是否到达目标」代替逐步奖励,那只是奖励接口的一种退化,不是循环消失。
| 循环接口 | 运行时含义 | 常见实现形态 | 缺了会怎样 |
|---|---|---|---|
| 观测 | 传感器此刻给出的原始信号 | 图像、点云、文本、API 返回 | 盲走 |
| 状态 | 对决策有用的压缩 | 特征向量、符号事实、隐向量 | 决策在噪声上跳 |
| 策略 | 状态到行动的倾向 | 规则、规划器、策略网络 | 只会随机或死循环 |
| 行动 | 执行器实际改写环境的指令 | 速度、抓取、发消息、下单 | 环断在出口 |
| 奖励 | 对刚才过渡的评分 | 稀疏到达、逐步塑形、人工打分 | 学习没有方向 |
SOURCE 里把构成拆成硬件、软件、知识,和上面这张表是同一件事的另一刀。硬件是传感器与执行器的物理或接口载体;软件是把观测收成状态、再选出行动的程序;知识是软件运行时要查阅的事实、规则、模型参数。知识可以写死在规则库,也可以从数据里长出来——长出来的过程叫学习,存放的地方仍是「知识」这一层。
五块零件怎么分工
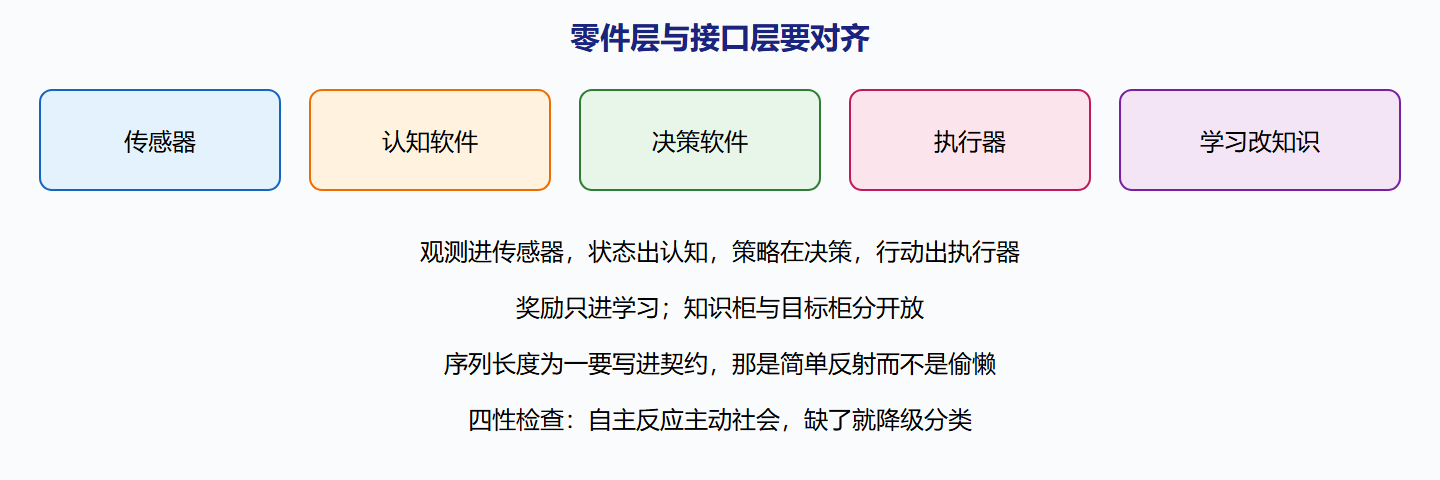
传感器不必是摄像头。对对话智能体,传感器是用户消息与工具返回;对交易智能体,是行情与持仓接口。执行器同理:可以是电机,也可以是「调用下单接口」「回复一句话」。选传感器时真正要问的是:观测是否足以支撑状态?部分可观测环境下,再贵的摄像头也补不齐墙后的行人,必须靠记忆或主动探测。
知识库在经典系统里是规则与事实;在学习系统里是参数与经验回放。不要把「有神经网络」理解成「没有知识」——权重就是压缩过的知识,只是人读起来费劲。推理引擎则是在知识上做一步:规则引擎做匹配,贝叶斯网络做概率传播,规划器做搜索,深度模型做一次前向。学习模块是唯一允许改知识的通道;若运行时乱改规则又没有约束,系统会自己把坐标系拧歪。
温室控制器是一个好用的最小例子。传感器:气温、湿度、光照。目标:把气温维持在白天 24 到 26、夜间 18 到 20。行动:开窗、加温、遮阳。知识:作物在高温下蒸腾加快、遮阳会降低光合。没有学习模块时,这是基于规则或基于模型的控制器;加上「根据过去一周的超温次数调整阈值」,学习模块才进场。零件齐全,并不等于智能高——简单反射也可以五块都有,只是知识是一张 if-then 表,推理是查表。
⚠️ 常见坑:把知识库理解成必须手写的专家系统。参数、经验回放、世界模型权重,都是知识的存放形态。真正要盯的是:谁有权改它,改完之后循环还稳不稳。
工程上还有一个容易忽略的点:目标写在哪。有人把目标写进奖励,有人写进终止条件,有人写进规划器的启发式。三种写法可以共存,但必须有一张表说清「成功」以哪一条为准。否则会出现感知很准、行动很勤、业务上却在优化错误东西——循环是闭合的,坐标系是歪的。
设计原则如何落到零件上
SOURCE 在定义节后补了自主、反应、主动、社会四条。四条不是道德口号,是零件有没有被外部手操死。自主:决策模块能在给定目标下自己选行动,不必每步等人。反应:传感器到执行器的短路径存在,超时也能动。主动:目标栈能自己提出下一步,而不是只等触发。社会:预留通信接口,即使当前任务是单车。仓库分拣车可以四条都弱——高度调度——那它更接近遥控设备,1.1 的定义会打折。打折不是侮辱,是分类:你知道自己少了哪条,后面才不会夸大「智能」。
映射 感知序列到行动 在实现上常被写成只看当前帧。若真只看当前帧,应在文档里写「序列长度为一」,这是简单反射的契约,不是偷懒没写记忆。金融交易若把盘口当观测、把下单当行动、把收益当目标,三要素齐,但是否自主取决于风控是否允许策略在合法集里自己选。风控熔断是执行器上的硬过滤器,属于硬件/软件里的约束层,不是把智能体取消。
最小实验:选一个你熟悉的系统,强制写出传感器清单、执行器清单、目标判定、知识存放处、谁允许改知识。五格有空,定义就还没落地。空在传感器,后面的认知章会无米;空在目标,决策章会无灯塔;空在改知识权限,学习章会变成偷偷覆盖。这张五格表比再背一遍「智能体等于感知加行动加目标」抗忘,因为每一格都能在代码或模块名上对上号——对上的是职责,不是文件路径。
PEAS 可以当作 1.1 的验收口诀:性能指标对应目标如何检验,环境对应下一节,执行器与传感器对应本节硬件。四项写不清就开会,最后往往得到一个「智能的某某」。先把口诀填完,再允许讨论用不用网络。
图:五块零件与四元组座位
本节检查清单
合上页面前问自己:能否不看标题说出三要素?能否指出映射发生在运行时而不是训练脚本里?硬件软件知识三层能否各举仓库里的一块?学习模块是不是唯一改知识的通道?目标写在奖励、终止还是启发式,有没有一张表说清以谁为准?感知序列长度若为一,有没有写成契约?PEAS 四格有没有空?四性里缺的那条有没有导致降级分类?五格零件表能否对着模块职责(不是路径)对上号?若有两问答不出,留在本节,不要用 1.2 的类型名词来遮。类型是下一节的简化,遮不住零件缺口。零件缺口会在后面每一章以不同别名出现,越晚越贵。
要点速记
- 三要素:感知、行动、目标同时在,才叫智能体;缺目标的闭环只是扰动发生器
- 映射:运行时是感知序列到行动;训练可以在环外或环上,但不取代运行时循环
- 状态 ≠ 观测:状态是对决策有用的压缩,认知的任务就是完成这次压缩
- 五块零件:传感器、执行器、知识、推理、学习;学习是改知识的通道
- 四元组接口:状态、行动、奖励、策略是循环上的座位,不是四个独立产品
- 最小例子:仓库分拣与温室控制都能画出同一张环,只是传感器与目标不同
下一节用类型与环境属性说明:同一套零件,换内部结构或换环境假设,设计会完全改样。