- 文集信息
- 目录大纲
- 最新文档
- 知识宇宙
文集详情
文集导读
教程导读
一句话定位:AI 智能体不是一堆互不相关的算法,而是一套感知—决策—行动循环;本教程用概念筑基把状态、奖励、策略这组坐标系立住,再讲认知、决策与学习如何嵌进循环。
这个教程解决什么问题
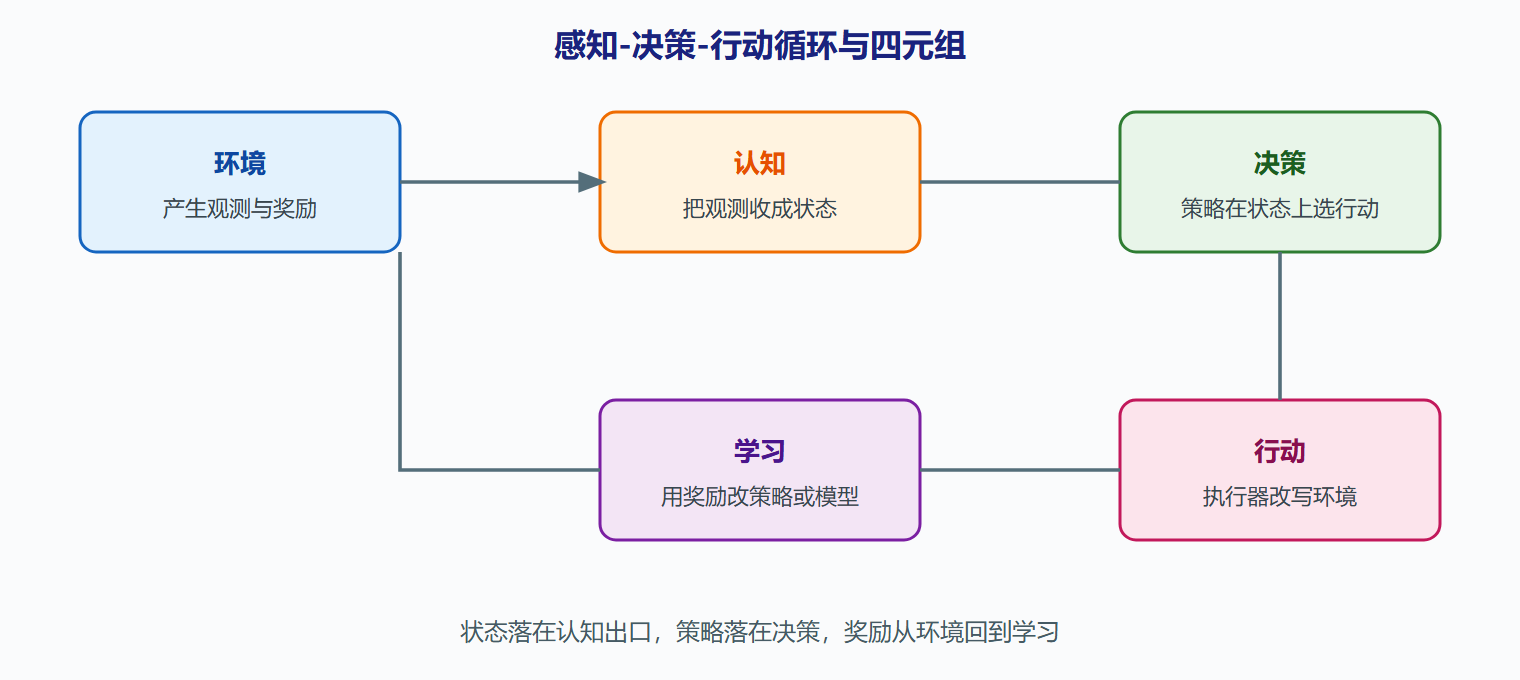
很多人第一次接触「智能体」会把词拆碎:这边是视觉模型,那边是规划器,再那边是强化学习。拆完之后说不清一件事——这些零件怎么拼成一个能在环境里连续活下去的东西?Russell 与 Norvig 把智能体写成从感知序列到行动的映射;强化学习又把它写成状态、行动、奖励、策略四元组。两套话如果不先对齐,后面读任何架构图都会飘。
本教程先把循环和坐标系讲透,再按「看见世界 → 选出行动 → 用经验改策略 → 把循环装进系统」往下走。感知、知识表示、世界模型属于认知,负责把原始信号收成状态;目标、效用、规划、行动选择属于决策,负责在状态上给出行动;监督、无监督、强化学习属于学习,负责改策略或改内部模型。第 5 章把循环装进反应式、慎思式、混合式架构;第 6 章才碰到多智能体与大模型——它们改变的是循环的实现形态,不是循环本身。
适合谁读
- 需要一张总图、而不是立刻上手某个框架的工程师与学生
- 已经会一点机器学习、但说不清智能体和「训练一个分类器」差在哪的人
- 读强化学习或大模型智能体之前,想先把术语钉死的人
不适合:只想抄一段可运行的对话机器人脚手架。那类动手教程请去智能体开发类文集。
学完你能做什么
- 用感知—决策—行动循环画任意一个智能体,并标出状态、奖励、策略落在哪一段
- 区分简单反射、基于模型、基于目标、基于效用、学习型五类智能体,并说出各自对环境的假设
- 解释知识表示、世界模型、规划、行动选择各自解决循环里的哪一截
- 判断一个问题该用规则、规划、还是从经验里学策略,而不是默认「上强化学习」
- 看懂混合架构和大模型智能体时,能指出哪一层在感知、哪一层在决策、哪一层在学习
学习路线
| 章 | 要立住的概念 | 读完应能画的图 |
|---|---|---|
| 第1章 | 循环、四元组、环境属性 | 感知到行动再回到环境 |
| 第2章 | 感知、表示、世界模型、推理 | 原始信号如何变成状态 |
| 第3章 | 目标、效用、规划、不确定决策 | 状态如何变成行动 |
| 第4章 | 三种范式、更新、泛化 | 经验如何改策略 |
| 第5章 | 反应式到混合式 | 循环如何落成模块 |
| 第6章 | 多智能体、大模型、可解释 | 循环在边界上怎么变形 |
图:智能体坐标系总览
怎么用这个教程
按章顺序读。第 1 章是坐标系,后面每章都在同一张图上加一层。遇到算法名(Q 学习、MCTS、Transformer)先问:它改的是状态、策略,还是奖励的用法?不要跳去背公式。每节约 25–40 分钟;章支柱页先读摘要和概念图,再进节。
⚠️ 常见坑:把「训练一个模型」直接叫智能体。没有与环境的闭环,只是函数拟合。
💡 关键直觉:智能体的智能不在某一个模块最强,而在循环能否稳定地把观测变成更好的下一步行动。
阅读时手里该有的一张纸
建议准备一张纸,左边画环,右边留空填字段。每读完一节,只往空里加东西,不另起炉灶。第 2 章结束时应能写出某场景的状态清单;第 3 章结束应能写出目标是到达还是维持、冲突怎么公度;第 4 章结束应能写出学习改的是策略、模型还是表示;第 5 章结束应能标出谁拥有执行器否决权。第 6 章是把这张纸拿到客服或仓储上对照,不是另学一套行业黑话。
纸上禁止出现「智能」「赋能」「大脑」这种占位符。写得出「观测是轮速与前视图像」「状态是相对距离与货位占用」「合法集禁止在未确认时调用下单工具」,才算坐标系立住。写不出时,回到对应节,不要用后一章的算法名来填空。
不需要编程环境。若你想动手,用纸面伪代码走完温室或仓库一圈即可:给出一帧观测,写出状态,选出行动,标明奖励是否出现。真要训练网络,请去强化学习或开发类教程;本教程若开始贴训练曲线,就把主调带偏了。
与相邻教程的边界:强化学习入门文集把马尔可夫决策过程与 Q 学习讲深;智能体开发文集讲工具链与落地;AI 伦理文集从事故切入。本文集停在概念坐标系,算法与治理点到即止。同批对话式框架教程走对比选型,本文集不评框架品牌。坐标系立住之后,任何新名词都应能坐回状态、策略、奖励三个座位之一。
目录大纲
最新文档
知识宇宙
正在加载知识图谱...