2.3 世界模型构建
2.3 世界模型构建
本节摘要:世界模型是智能体对「环境如何随行动与时间变化」的内部模拟,不只是当前状态快照。它包含状态变量、动态规则、因果关系与可复用知识,用来预测、预演规划、把经验迁移到新情境。构建路径有手写规则、从数据学习、以及两者混合。没有世界模型的智能体并非不能动,只是每一步都只能用真环境当实验室。
本节地图
阅读完本节,你应当能够:
- 说出世界模型比状态快照多了哪些部件
- 解释规划为何依赖「行动如何改变状态」的模型
- 比较基于规则、监督、无监督、强化学习间接学模型的适用边界
- 指出模型偏差会如何让决策自信地错
快照不够,还要会演
闭眼仍能大致知道房间家具——那是当前状态。你还能预估「往前走两步会撞桌」——那是动态。SOURCE 把世界模型写成状态信息、动态模型、因果关系与知识。四块里,工程上最容易只做第一块:把检测结果写进黑板,以为有了世界模型。黑板是记忆,不是模拟器。模拟器要回答反事实:若我现在刹车,三秒后相对距离是多少?
因果关系比相关更苛刻。「开窗」与「气温下降」在数据里一起出现,可能只是因为傍晚既开窗又降温。世界模型若把相关当因果,规划会学到「想降温就等到傍晚」,在正午失效。智能体需要的是干预意义下的因果:我执行这个行动,状态哪几维会变。做不到完全因果时,至少把「我能干预的变量」和「只会观测的变量」分开存。
当前状态 s 行动 a 模型 T 给出下一状态的预测 规划在 T 上搜序列,真环境只执行第一步
💡 关键直觉:世界模型的价值是把试错从真机挪到内部。挪得动的前提是 T 在决策关心的变量上够准,而不是在所有像素上都能重建。
棋盘是几乎精确的世界模型:规则公开、确定性高。温室是中等:物理大致可知,干扰随机。城市道路很难:行人意图不可完全建模。因此「要不要学世界模型」不是信仰,是环境属性。确定性高、试错贵,值得投模型;随机性极强、模型永远过时,可能更该用无模型的反应策略,并承认规划视野必须短。
怎么建:规则、数据、混合
基于规则:把物理或业务写成显式转移。棋规则、仓库货位占用、交通灯相位,适合这一路。优点是可检查、可审计;缺点是例外与连续非线性很难写全。基于学习:从轨迹里拟合下一状态。监督学习直接预测下一状态或下一观测;无监督学习找潜在因子,再在因子上做预测;强化学习表面上在学策略,但有的算法会顺带学模型,或用模型加速策略更新。混合:规则给出不可违反的骨架(不能穿墙),学习补残差(地面摩擦、行人加速度)。
SOURCE 的流程图是:感知数据 → 特征 → 规则引擎或学习模型 → 世界模型 → 决策行动 → 再感知。关键反馈是:模型预测与真实下一观测的误差,应回到学习,而不是只当日志。很多系统有模型,却没有「模型误差」这条学习通道,于是模型会静静过期。
| 构建路径 | 需要什么数据 | 预测什么 | 典型失效 |
|---|---|---|---|
| 手写规则 | 专家知识 | 离散后继与约束 | 例外写不全 |
| 监督下一状态 | 成对的状态-行动-后继 | 短视动态 | 分布外崩 |
| 潜在世界模型 | 大量无标注轨迹 | 压缩后的动态 | 潜变量对不齐决策变量 |
| 在规划中学 | 与环境交互 | 对回报有用的部分 | 只在常走路径上准 |
| 规则加残差 | 规则骨架加误差数据 | 骨架外的偏差 | 骨架本身错则残差救不了 |
模型给谁用,误差算在谁头上
决策里至少有三种用法。短视预测:只看一步,用来避障。开环规划:在模型上滚出一条序列再执行。闭环重规划:每步用新观测校正状态,再重新滚。第三种对模型误差更宽容,因为它不断拿真观测当锚。第一种最省,但看不了绕路。选哪种取决于动态有多快、模型有多差。
误差归属是调试核心。规划失败,可能是模型把可行路判成墙,也可能是状态估计把墙看成空。前者修 T,后者修感知与滤波。若把两者焊在一个端到端网络里,梯度不知道该怪谁,你会看到「再训练一次又好一点」的幻觉。概念筑基的立场是:允许端到端实现,但心里要有模块边界,才能设计探测实验——冻结感知只训模型,或反过来。
⚠️ 常见坑:用像素级重建质量当世界模型验收。决策需要的是「刹车后距离」这类变量准,不是把树叶纹理生成得像。
想象力在 SOURCE 里被写成世界模型的能力之一。工程对应是:在模型里采样没执行过的行动,发现新策略。这要求模型在分布外别太疯。安全相关行动(急刹、急转)若只在模型里漂亮、真机上过激,必须用约束把可采样行动限制在经过真机验证的集合里。世界模型不是让你少做真机试验,是让你把真机试验用在刀刃上。
仓库例子:模型需要预测「插入货位后占用变化」「窄道会车是否卡死」,不必预测包装上印刷的字。状态变量选错,模型再准也帮不了规划。这把我们送回 2.1:状态清单是世界模型的坐标系,模型只是在这份清单上写动态。
图:快照、动态与规划预演
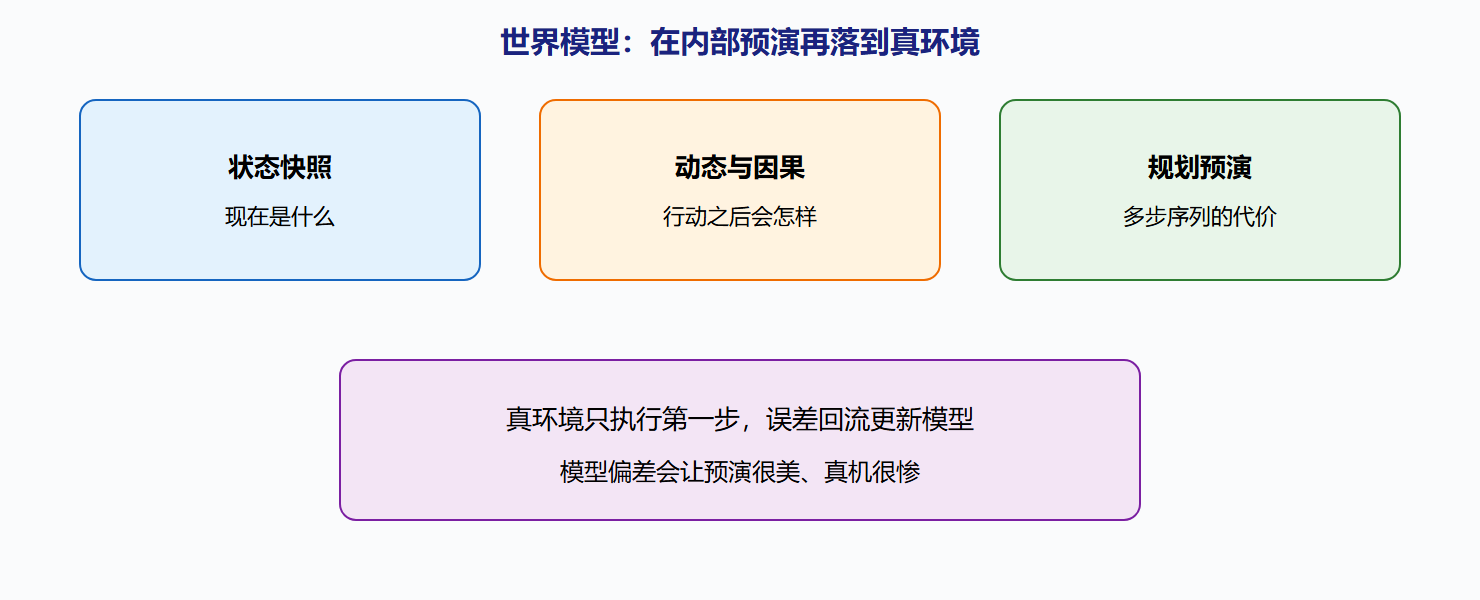
学模型时学的是哪一段动态
短视模型只预测下一秒距离,够避障,不够绕路。任务层需要的是「插入后货位占用如何变」「窄道会车是否卡死」,时间尺度完全不同。一个 T 包打天下通常会在某一层撒谎。分层世界模型与分层架构配套:反射用几何与速度,技能用通道占用,任务用订单与地图版本。各层 T 独立更新、独立验收,预测误差才有归属。
无模型方法并不是没有世界,只是拒绝显式 T,把动态的有用部分吸进策略。试错便宜、动态极乱时合理。试错贵、要解释「为什么这条路不行」时,显式模型更值。不要道德化:有模型不是更科学,无模型不是更端到端美德。看试错代价与解释需求。棋的 T 几乎免费且完美,不学模型才奇怪;股票的 T 几乎买不到,硬学一个会在分布外幻想趋势。
因果最小集:列出我能干预的行动维,只为这些维建效果模型。天气不是干预维,当条件变量。把天气当行动来「规划下雨」,是类型错误。温室里开窗是干预,室外气温是条件。模型图上用不同形状区分,能少很多假因果。SOURCE 把因果关系单列,就是怕动态拟合把相关当可规划的旋钮。
预演预算要写进契约:技能层允许向前看多少步、超时怎么办。超时则缩短视野或把控制交给反射,而不是输出半截计划。半截计划比没有更危险,因为它看起来像深思熟虑。2.3 与 3.2 的接口在此咬合:模型不仅要准,还要在时限内准到能用。
本节检查清单
快照与模拟器有没有分开?可干预维与条件维在图上有没有不同形状?各层 T 是否按时间尺度拆开验收?预测误差有没有回流到构建而不是只当日志?像素重建有没有冒充决策变量精度?预演预算与超时默认写进契约没有?半截计划会不会被执行?无模型策略是否承认自己没有显式 T,因而不该自称规划?棋与市场两种极端有没有被你用来判断「该不该学 T」而不是用来站队?误差归属实验(冻感知只训模型或反过来)做过没有?没做过就不要用端到端成功率宣布世界模型成功。成功可能发生在感知侧,模型只是搭便车。
用决策变量误差当模型分数
像素重建很美,刹车后距离仍偏一米。分数应记距离误差,不记树叶。树叶不进合法集。距离进。进了才是世界模型的业务。业务用这一条实验:冻结感知,只看 T 在决策维上的误差,规划成功率跟着误差走才承认模型有功。不跟着,功在感知。功在感知就去 2.1,别改 T。改错科室。科室在误差归属。归属实验是本节作业。作业不做,端到端成功率会把搭便车当世界模型成功。成功是假的。假的会在换仓后崩:感知还能认托盘,T 还在旧摩擦上。旧摩擦是过期知识。过期走 4.3。4.3 要知道过期的是 T 不是检测。知道来自归属。归属来自本节。本节毕业标准是决策维误差表。表比重建视频重要。视频可以进演示。演示不放行。放行看距离。距离准了,预演才配缩短真机试错。试错贵,才值得模型。值得写在环境轴上:试错贵且动态可建模,才建 T。建了要用决策维验收。验收这一条。这一条过,2.3 过关。过关不要求会学潜变量。要求不把树叶当分数。树叶分数是错灯塔。错灯塔会让学习改纹理。纹理不刹车。刹车看距离。距离是本节的 G。G 很土。土的动态才规划。规划要 T。T 要准在 G 上。G 是距离一类。一类写进状态清单。清单来自 2.1。2.1 与 2.3 接头。接头是决策维。决策维准了,预演有意义。有意义才叫世界模型,而不是视频生成器。生成器可以美。美不刹车。刹车看误差表。表过关。过关后再允许预演缩短真机试错。试错仍要留在校准过的行动集里,分布外的想象力必须被约束拦住。拦住之后,模型才配缩短真机试错,而不是用幻觉代替试验。
要点串联
- 模型 ≠ 快照:还要动态、因果、可干预变量
- 价值:把试错从真机挪到内部,前提是决策变量上够准
- 三条构建路:规则、数据拟合、规则加残差
- 用法:一步预测、开环滚序列、闭环重规划,对误差容忍不同
- 误差归属:分清是 T 错还是状态估计错
- 验收:用决策变量误差,不用像素重建好看
下一节用推理在已有结构上补全没直接看见的事实。