4.1 学习范式
4.1 学习范式
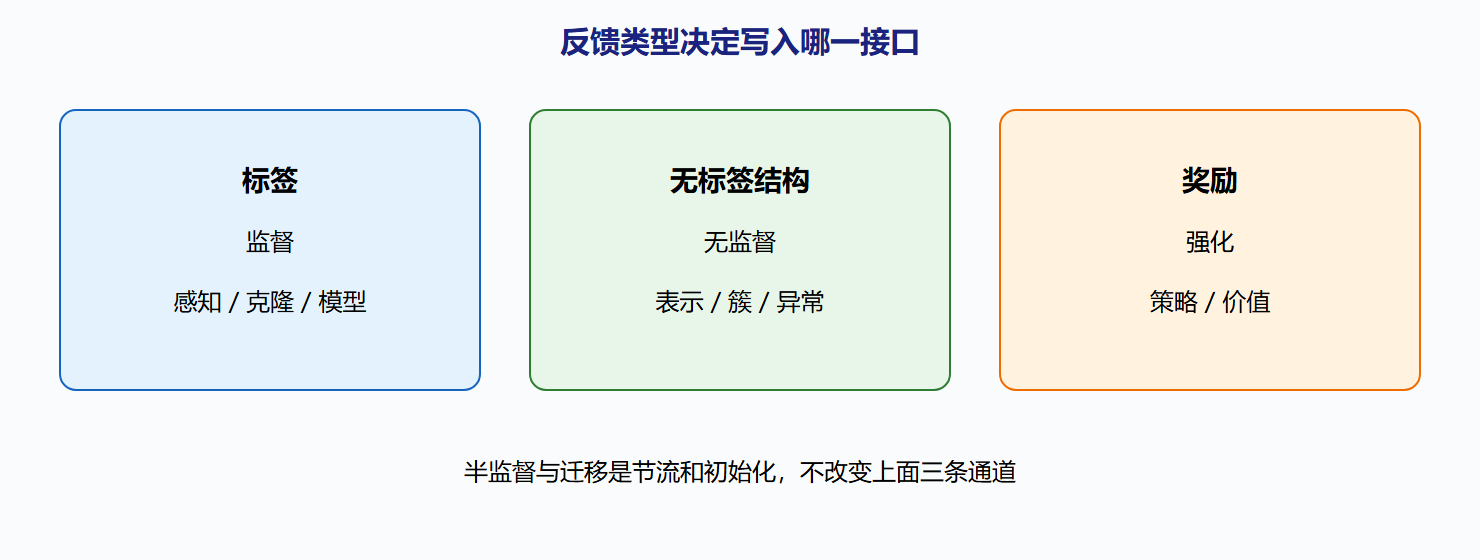
本节摘要:学习范式按反馈类型划分。监督学习用标签教映射,适合感知分类、回归、模仿专家行动。无监督学习没有标签,找簇、压缩、异常,常为认知提供表示。强化学习用奖励教策略,适合序列决策、标签昂贵但互动可得。半监督与迁移是数据不足时的组合技。选范式先问:你手里的反馈是标签、是结构,还是奖励?不要先问「哪个模型最火」。
阅读收获
阅读完本节,你应当能够:
- 用反馈来源给任务选范式,而不是按行业习惯默认强化
- 指出监督可以改感知也可以做行为克隆,两者风险不同
- 说明无监督很少直接出策略,它通常改表示
- 解释强化为何依赖 3.1 的奖励与循环的在线交互
反馈决定你能改什么
学绘画时老师改每一笔,是监督。自己在画里看出远近层次,是无监督。画完被人打分再改手法,是强化。智能体同理。SOURCE 把监督写成分类、回归、神经网络、支持向量机;把无监督写成聚类、降维、异常、自编码器;把强化写成 Q 学习、深度 Q 网络、策略梯度、行动者-评论者。名词是机制层的,范式层只认反馈。
监督的标签从哪来,决定它在循环中的落点。图像类别标签 → 改感知。专家示范的行动 → 改策略(行为克隆)。下一状态标签 → 改世界模型。三种都叫监督,接错接口会 silently 错:用示范学策略,专家没演示过的状态会乱;这不是网络不够深,是监督覆盖不到的状态没有反馈。
💡 关键直觉:强化不是「更高级的监督」。它解决的是标签是序列回报、且必须自己产数据。能便宜拿到逐步标签时,监督通常更省。
三种范式的适用与错配
感知里的分类与检测,标签可标注,监督是默认。异常检测有时无标签,只能无监督或弱监督。对话意图既可监督也可规则。真正逼你上强化的,是行动的对错要等很久才揭晓,中间没有逐步标签:下棋、控制、广告出价。即便如此,仍常混合:感知监督预训练,策略再强化微调。混合不是墙头草,是接口不同。
无监督在循环里最常见的贡献是表示:自编码器、聚类把原始观测收成更稳的状态维。它几乎不直接告诉你「该开窗还是关窗」。若有人声称无监督策略,多半是在簇上贴了事后规则——那规则才是策略,簇是认知。异常检测可以当评判的辅助:异常高则奖励加罚或触发保守策略,它仍不是策略本身。
| 范式 | 反馈 | 典型改的接口 | 错配症状 |
|---|---|---|---|
| 监督 | 标签 | 感知、模型、克隆策略 | 专家没覆盖的状态乱动作 |
| 无监督 | 无 | 表示、异常分 | 以为簇号就是行动 |
| 强化 | 奖励 | 策略、价值、偶尔模型 | 奖励没写对就钻空子 |
| 半监督 | 少量标签加大量无标 | 感知 | 伪标签确认偏误 |
| 迁移 | 源任务知识 | 表示或策略初始化 | 负迁移,源任务拖后腿 |
半监督与迁移不要当成并列宇宙。半监督是监督在标签贵时的节流。迁移是把源任务学到的表示或策略当初始化。负迁移很真实:在仿真里学的驾驶策略,真机动力学不同,初始化可能比随机更糟。迁移前先问状态清单是否对齐——2.1 的坐标系又出现了。
强化与循环的绑定
强化假定:你能与环境交互,能收到奖励,状态满足或近似满足「未来与过去无关、只与当前状态与策略有关」。这把 1.1 的循环变成数据发动机。没有循环,只拿离线日志拟合,叫离线策略学习,约束完全不同。本教程不展开算法;只需记住评判元件给出的 r,必须能对上 3.1 的目标,否则学习会闭合地优化错的灯塔。
⚠️ 常见坑:任务能标注逐步正确行动,却上强化「更端到端」。样本效率、奖励设计、探索安全的成本,通常高于多标一点数据。
仓库拣货:货位识别用监督;货架排列结构用无监督或图谱;路径与插货角度在仿真里强化,真机上用安全规则过滤。三种范式同时在线,不丢人。丢人的是用同一次「再训练」同时改三个接口,出了破损不知道该回滚哪一层。4.3 会谈写入纪律;这里先立:范式选择要能写进模块边界。
学习型四元件在此对号。执行元件始终在。评判在强化里最显眼,监督里评判是损失函数对标签的偏差,无监督里是重构误差或簇内距。学习元件执行更新。问题产生器在强化里是探索,在监督里是数据挖掘与主动标注,在无监督里是采样哪些无标数据。四元件不随范式消失,只是反馈管道变了。
图:三种反馈三条写入通道
行为克隆不是强化的便宜替代
有专家轨迹时,监督克隆策略很香,也很容易在专家没去过的状态上乱。克隆覆盖的是示范分布,不是任务到达集。示范里从不靠近货架边缘,克隆就不会处理边缘。这时要么补示范,要么在合法集内用强化填洞,要么用规划在模型里补。三种都比「再克隆久一点」诚实。克隆还有因果问题:专家因看见行人而刹车,克隆可能学成「在那块地板纹理上刹车」。状态清单若不含行人而含纹理,监督会学到假相关。这把 4.1 绑回 2.1:标签再准,字段错了也是假监督。
无监督异常分可以当评判辅助:异常高则降低探索或触发保守。它仍不是奖励本身。若把异常分直接当负奖励,智能体会学会躲避所有新状态,适应死亡。异常应进监控与合法集收紧,进奖励要非常克制。半监督的伪标签同样:高置信才进监督池,否则确认偏误会自我加强。伪标签是节流,不是免费劳动力。
迁移前对齐三件事:状态字段、行动语义、奖励量纲。仿真速度与真机速度若单位不同,初始化比随机更糟。对齐是 4.1 的隐式作业,常被模型选型抢走注意力。选完范式之后,先写对齐表,再谈要不要冻层。冻层是 4.4 的工艺,对齐是 4.1 的前提。
强化的样本来自循环。没有循环的离线日志,叫离线策略学习,假设更苛刻:日志策略要覆盖将要部署的状态,否则外推。不要把离线拟合回报曲线当成已经拥有学习型智能体。曲线漂亮只说明在旧策略造访过的地方拟合得好。
本节检查清单
任务的反馈到底是标签、结构还是奖励,有没有写在模块边界上?监督三个落点(感知、克隆、模型)有没有覆盖不到的状态?克隆有没有学成地板纹理刹车?无监督簇号有没有被当成行动?异常分有没有直接当负奖励导致躲避一切新状态?半监督伪标签有没有确认偏误?迁移三对齐(字段、行动语义、奖励量纲)做了没有?能标注逐步正确行动却上强化,理由写了成本对比没有?四元件在当前范式里分别吃什么?离线日志拟合有没有被当成已经拥有在线学习型智能体?没有循环的曲线,只是拟合。拟合可以很漂亮,循环可以不存在。4.1 的第一问永远是反馈从哪来,第二问才是模型叫什么。颠倒两问,范式节白读。
别用强化去学已经能标注的灯色
灯色分类有标签,走监督。走强化会花探索预算在已经能便宜标注的映射上,还可能用进度奖励把闯灯学成捷径。捷径是 3.1 代理加上 4.1 错配。错配的检验:若逐步正确行动能标,先算标注成本,再算强化的探索与安全成本。后者通常更高。更高就不要为了端到端好看而选强化。好看不是范式。范式是反馈。反馈是标签时坐监督。坐对了,感知管道干净,决策仍用合法集挡闯灯。挡在规则,不在奖励里买。买会漏。漏是错配的典型症状。症状用这一条实验:同样灯色数据,监督分类错误率对上闯灯次数。强化若闯灯更多,不是网络不够深,是灯塔进了奖励。奖励不该承担分类。分类有标签。标签用监督。监督完,强化若还要上,只许动技能层合法集内的残差。残差不是灯色。灯色是认知。认知有标签就不要用奖励教。教错科室。科室在 1.3 已经分过。分过还走错,4.1 白读。白读的标志是会议里说「我们用强化把感知也打通」。打通是焊。焊可以,但要探针分开记分类与闯灯。分开记仍会显示:有标签的部分用监督更省。更省是范式选择的审美。审美对准反馈来源,不对准潮流。潮流爱强化。强化爱循环。循环爱奖励。奖励爱歪。歪之前问有没有标签。有标签,先监督。先监督是本节作业。作业很不像智能。不像才对。对的范式选择经常不像智能,像会计:什么反馈走哪条管道。会计做完,算法名才配出现。出现仍要坐座位。座位在本节四问第一问:反馈是什么。第一问答错,后面全错。全错的漂亮曲线是拟合。拟合可以不闯灯,也可以闯灯。闯灯时曲线仍可能涨——若奖励爱进度。进度涨、闯灯涨,就是错配现场。现场用这一条抓住。抓住了,4.1 过关。过关不要求会推策略梯度。要求会拒绝用强化学灯色。拒绝是判断。判断是概念筑基。筑基在反馈。反馈在标签时,强化是错科室。错科室不进循环的学习通道。通道要干净。干净从这一条开始。开始很便宜:看有没有标签。有,走监督。走了,再谈无标与奖励。奖励留给真的序列决策。真的序列决策没有逐步标签。没有才轮到强化。轮到之前,先把灯色学对。学对用监督。监督是老师。老师在时,不要用奖惩代替改作业。改作业更准。更准更省。省下来的探索预算留给真的未知。未知在合法集内。集内才探索。集外的灯色不是未知,是已有标签的映射。映射走监督。监督完本节。
要点串联
- 范式按反馈分:标签、结构、奖励,不是按模型品牌分
- 监督有三个落点:感知、行为克隆、世界模型,覆盖不到的状态会乱
- 无监督主攻表示:簇号不是行动
- 强化绑定循环:奖励必须对上目标,探索要有安全集
- 混合是接口不同:感知监督、策略强化是常态
- 四元件仍在:只是评判的输入从标签换成奖励或重构误差
下一节把常见算法按机制坐到这些通道上,仍不展开推导。