第二章:机器学习基础编队
第二章 · 机器学习基础编队
本章要回答的三个问题:拿到一个已归类的任务,损失函数该怎么配?模型做完实验,用什么指标下结论才不会被自己骗?指标不好看时,如何判断该加数据、加特征还是加正则?这是全册战术密度最高的一个编队。
为什么会有这一章
上一章练的是"归类",这一章练的是"落地"。工程现场最常见的翻车不是模型选错,而是评估用错:一个正类占比千分之一的风控模型,准确率高达九成九以上,团队欢庆上线,实际上一个欺诈交易都没抓到。这类事故的共同根因是:只认识指标的名字,不理解指标在度量什么、在什么分布下会失效。
同理,损失函数选错也很隐蔽:用均方误差去做多分类,训练能跑通,收敛却慢且差;把逻辑回归的输出当概率直接校准,风控阈值就定歪了。本章把这三块基本功放进关卡里反复锤打,每道题的数值都要求亲手复算。
读完能解决什么
- 给定任务(回归、二分类、多分类),正确选配损失函数,并说出选错的症状;
- 手工从混淆矩阵推出精确率、召回率、F1,并按业务代价决定两者的优先级;
- 用偏差—方差框架诊断模型,开出"过拟合药方"(正则化、早停、数据增强)并知道每味药的副作用。
各节怎么分工
| 节号 | 回答哪个问题 | 关键产出 |
|---|---|---|
| 第一节 监督学习算法与损失函数关卡 | 模型怎么配损失 | 算法特性对比表 + 损失选型自测代码 |
| 第二节 模型评估指标与交叉验证关卡 | 结果怎么下结论 | 混淆矩阵手工计算全流程 + 分层抽样验证 |
| 第三节 欠拟合过拟合与正则化关卡 | 差的时候治哪里 | 偏差方差诊断表 + 正则化对比实验 |
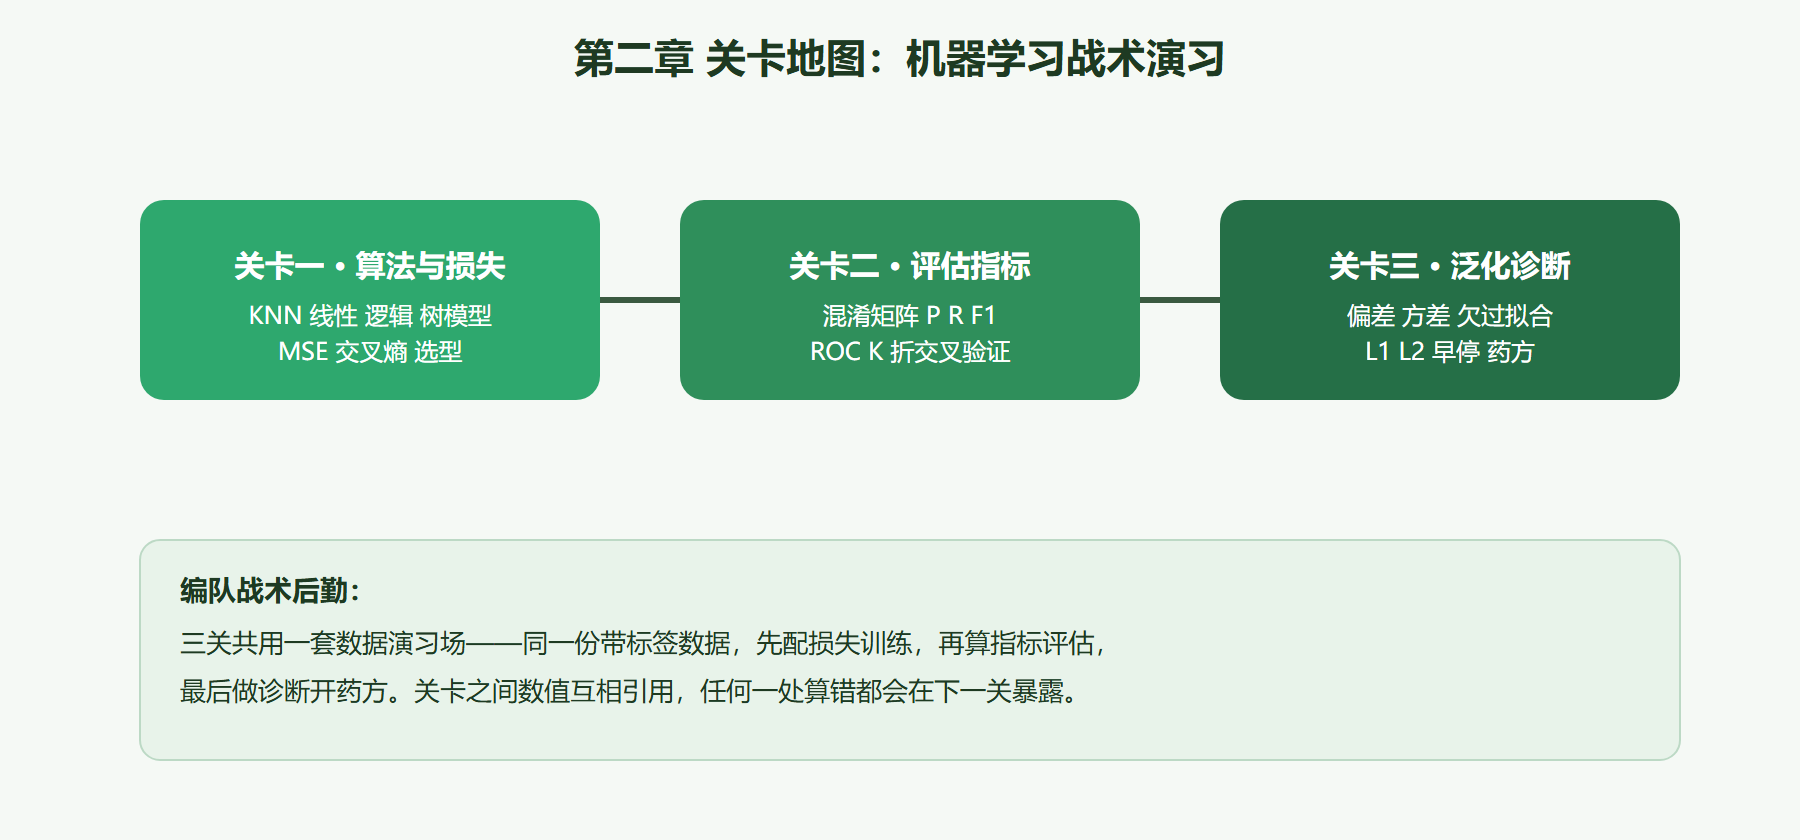
本章关卡地图
评估流程全景
这张流程就是三个关卡的联合作战图:损失选型在 C,指标计算在 E,诊断分支在 F 与 H。第三节的诊断结论会回到 C 重新配置——机器学习的迭代本质就在这个回环里。
本章可考核知识点清单
| 知识点 | 达标线 | 对应关卡 |
|---|---|---|
| 算法特性边界 | 给场景说清 KNN、线性回归、逻辑回归、树模型各自的取舍 | 关卡一 |
| 损失选配 | 给任务配对"算法 + 损失",并说出配错的症状 | 关卡一 |
| 混淆矩阵指标 | 手工从混淆矩阵推出精确率、召回率、F1 | 关卡二 |
| 指标按代价选型 | 说不均衡场景弃准确率的理由并给出替代指标 | 关卡二 |
| 交叉验证流程 | 说清 K 折切分与分层抽样的必要性 | 关卡二 |
| 偏差方差诊断 | 按训练与验证误差的组合开出诊断书与药方 | 关卡三 |
| 正则化对比 | 说清 L1 与 L2 对权重分布和稀疏性的不同影响 | 关卡三 |
这张清单是本章的"验收单":逐条自测,哪条答不利索就回哪关重打,不要带着含糊的指标概念进入后续编队。
先决条件
- 掌握第一章的任务分类(每题第一步都要亮决策卡);
- 会基础 Python 与简单求导;指标计算全程只涉及加减乘除;
- 建议准备纸笔:混淆矩阵与偏差方差分析必须手工推一遍再跑代码核对。
往下走到哪
本编队练出的"指标手感"是后续所有编队的通用弹药:第三章反向传播推的就是损失对参数的导数,第四章大模型的训练目标仍是交叉熵,第五章的检测指标是本章混淆矩阵思想在二维框上的推广。把本章三关打牢,后面四个编队的公式推演至少省一半力气。
评论区
(0)
U