第四章:自然语言处理编队
第四章 · 自然语言处理编队
本章要回答的三个问题:文字怎么变成数字才能进模型?注意力机制用一次矩阵运算解决了什么老问题?BERT 与 GPT 两条预训练路线为何走向不同的下游用法?序列阵地上的攻坚战,从此打响。
为什么会有这一章
NLP 理论题的核心矛盾是"离散符号对连续向量"。模型只认数字,语言却是符号系统,中间的翻译层(文本表示)决定了整个技术路线。更微妙的是,这个领域在几年内完成了从"循环网络加词向量"到"注意力加预训练"的换代,新旧考点叠加出现在同一张卷子上:面试官既可能问词向量的老问题(独热编码为何不行),也可能追问注意力矩阵的数值细节。两头都得能打。
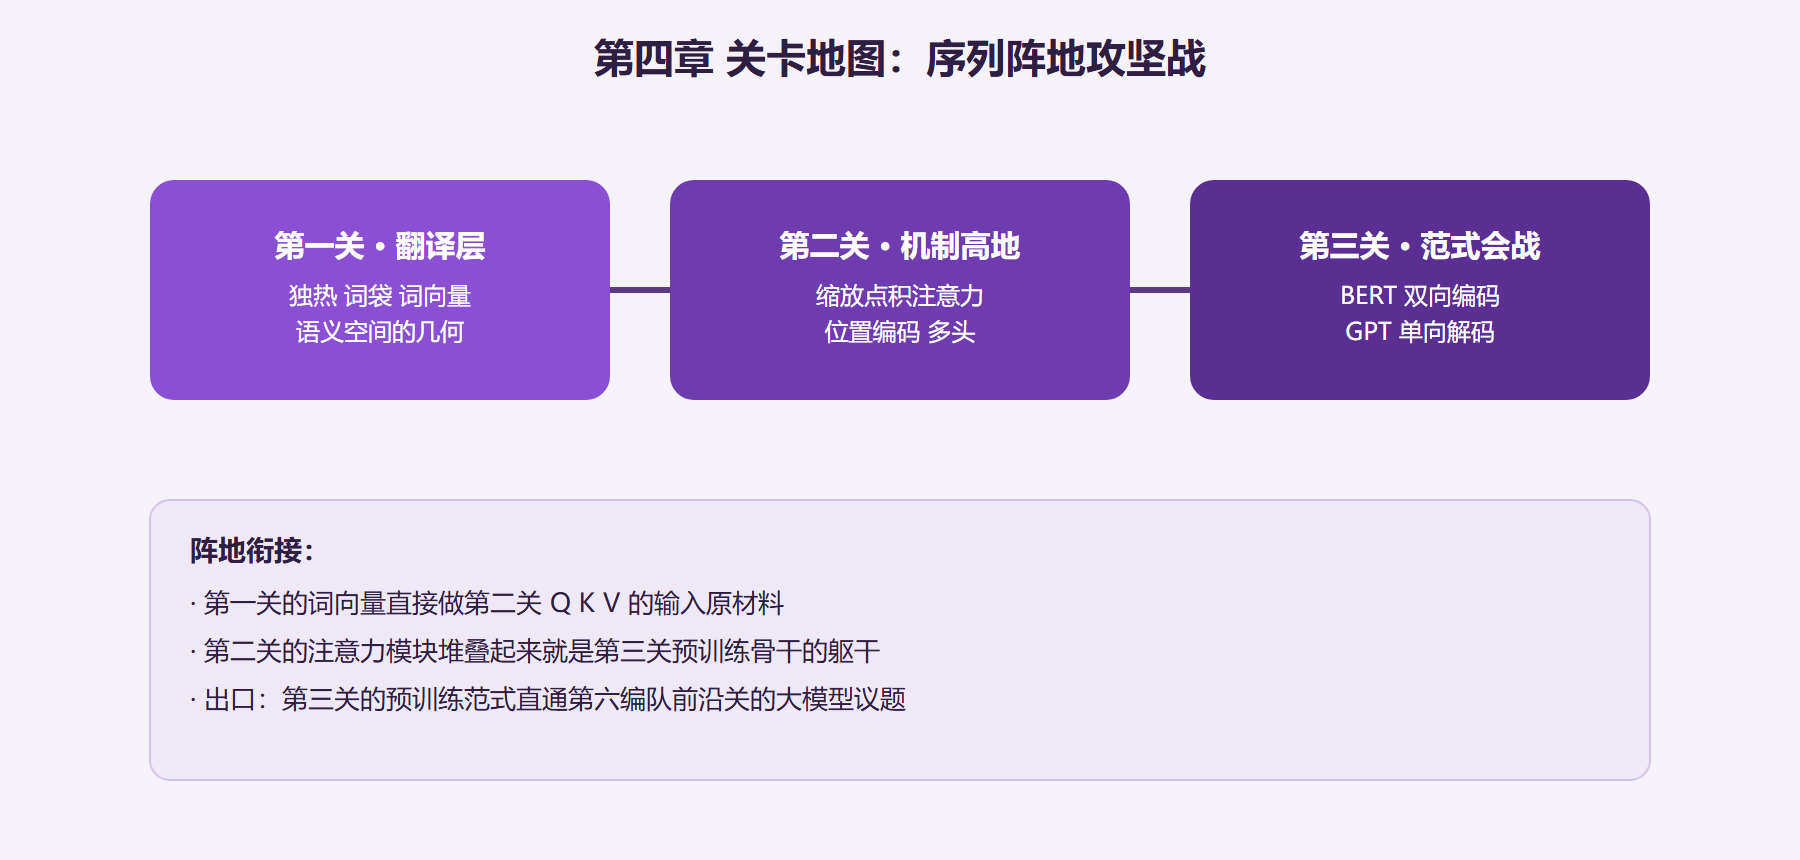
本章三关按"表示 → 机制 → 范式"推进:先解决文字到向量的翻译,再攻下注意力的计算细节,最后辨析两条预训练路线的分野。第三章的 softmax 与梯度直觉在本章全程参战。
读完能解决什么
- 说清独热编码、词袋、词向量的表示能力层级,以及"国王减男人加女人"类语义运算的来历;
- 手工算一遍缩放点积注意力(含缩放因子的来历);
- 辨析 BERT(双向编码、填空式预训练、擅长理解类任务)与 GPT(单向解码、预测下一词、擅长生成任务);
- 解释位置编码为什么是注意力的必需配件。
各节怎么分工
| 节号 | 回答哪个问题 | 关键产出 |
|---|---|---|
| 第一节 文本表示与词向量关卡 | 文字怎么变数字 | 表示方法对照表 + 词向量几何运算验算 |
| 第二节 注意力机制与Transformer关卡 | 老问题怎么被一次矩阵运算解决 | 缩放点积注意力手工全算例 |
| 第三节 BERT与GPT辨析关卡 | 预训练路线怎么选 | 双向与单向的机制对比 + 任务适配决策 |
本章关卡地图
从词到模型的演进全景
每个箭头都是一次"旧表示的局限被新表示化解":独热的稀疏与无语义,被词向量的稠密与几何化解;循环结构的时间衰减,被注意力的全局直连化解;从零训练的昂贵,被预训练加微调化解。读题时先定位考点在链条的哪一环,答案的结构自然浮现。
本章可考核知识点清单
| 知识点 | 达标线 | 对应关卡 |
|---|---|---|
| 表示能力层级 | 排出独热、词袋、词向量、上下文表示的阶梯并说清各级缺陷 | 第一节 |
| 分布式语义假设 | 用一句话说清词义从共现统计里来的机制 | 第一节 |
| 语义几何运算 | 用余弦相似度解释"国王减男人加女人"类运算的来历 | 第一节 |
| 注意力全流程 | 合上资料手算缩放点积注意力并解释缩放因子 | 第二节 |
| 位置编码必然性 | 用置换等变性论证语序信息必须额外注入 | 第二节 |
| 预训练路线选择 | 按任务形态在双向编码与单向解码之间做选择并给依据 | 第三节 |
这张清单是本章的"验收单":序列阵地的战斗全在这六条上,哪条含糊就回哪关重打,特别是注意力的手算,必须做到不查资料数值不错。
先决条件
- 第三章的 softmax 数值性质与梯度直觉(第二关的缩放因子与梯度分析直接复用);
- 会矩阵乘法:注意力就是三次矩阵乘法加一次逐行归一化;
- 对"词""词表""向量"有朴素认识即可,语言学背景完全不需要。
往下走到哪
本章练出的注意力算力是全册通用主力:第五章视觉编队的检测与分割骨干同样由注意力组装(视觉 Transformer 是直接移植);第六编队的前沿关将追问大模型训练里的预训练目标与对齐问题,正是本章第三关战果的延伸。序列阵地拿下后,整张 AI 地图只剩视觉与决策两块高地。
评论区
(0)
U