4.2 注意力机制与Transformer关卡
4.2 注意力机制与Transformer关卡
注意力机制考点:缩放点积注意力的完整计算链、除以根号 dk 的方差来历、位置编码为什么不可省、多头机制到底"多头"在哪。通关标准:合上资料手算完整注意力流程,数值与代码复算一致,并能说出哪里最容易翻车。上一关的词向量在这里充当查询、键、值的原材料;本关产出的注意力模块,正是下一关两条预训练路线共用的躯干。
火力侦察:关卡题目
关卡一(单选):缩放点积注意力在算完相似度后要除以根号 dk(dk 为键向量维度),这么做的原因是:
A. 防止过拟合 B. 使点积结果的方差与维度无关,避免 softmax 进入饱和区 C. 减少计算量 D. 把分数归一化到 0 到 1 区间方便可视化
关卡二(简答):自注意力与经典编码器-解码器注意力在 Q、K、V 的来源上有什么不同?
关卡三(单选):把输入词序列的顺序随机打乱后,不带位置编码的自注意力,其输出会:
A. 完全不变 B. 按同样的方式被打乱,但每个词的输出内容不变 C. 全部变成零向量 D. 无法计算,直接报错
关卡四(多选):相比循环网络,Transformer 的自注意力优势包括:
A. 任意位置之间都是一跳直连,长距离依赖的路径长度为常数
B. 训练时整个序列可以并行计算,不必按时间步串行
C. 参数量随序列长度增长,序列越长模型容量越大
D. 多头机制允许不同的头在不同表示子空间关注不同模式
先攻提示
- 关卡一从"点积的方差"入手:q 与 k 的各分量独立同分布,点积是 dk 项乘积之和,想想和的方差怎么长;
- 关卡二想清楚"查询由谁发出、去查谁":三路输入是否同源;
- 关卡三用置换等变性推导:打乱输入,打分矩阵只是行与列同步重排,softmax 在行内做归一化;
- 关卡四逐条核对:模型参数量到底由什么决定,序列长度参与了吗。
后核:标准解析
关卡一选 B。 设 q、k 的各分量独立、零均值、方差为一,点积 q·k 是 dk 项乘积之和,其方差随 dk 线性增大——dk 越大,打分越"陡"。打分一陡,softmax 输出就逼近 one-hot:胜者权重接近一,其余接近零,而 softmax 在饱和区的梯度趋近于零,反向传播几乎没有信号可传。除以根号 dk 恰好把方差拉回一,让 softmax 工作在敏感区。A 错在正则化是权重衰减、丢弃法一类手段的事;C 错在多一次除法并不省计算;D 是 softmax 本身的功能,与缩放无关。
关卡二:自注意力的三路输入出自同一序列——每个词既发出查询,也供其他词查询(提供键与值),用来捕捉序列内部词与词的依赖;编码器-解码器注意力里,查询来自解码端当前状态,键与值来自编码端的全部输出,作用是"生成译文时回头查看原文"。判别口诀:Q 与 K、V 是否同源,同源即自注意力,不同源即交叉注意力。
关卡三选 B。 注意力对输入顺序是置换等变的:把输入序列打乱,打分矩阵的行与列同步重排,softmax 在行内归一化所以结果跟着重排,输出内容不变、只是位置换了。这意味着注意力本身"看不见"顺序——"我打你"与"你打我"在这种模型眼里毫无区别。位置编码因此是必需配件而非可选装饰:它把位置信息注入词向量,打破置换等变性,语序才重新变得可辨。
关卡四选 A、B、D。 循环网络里首词的信息要到尾词得走全程中继站,逐站衰减;自注意力任意位置一跳直连,路径长度是常数。训练时循环结构必须按时间步串行,注意力的打分矩阵可以整块矩阵乘法算完,并行度高。D 是多头的本意:不同的头在不同子空间学习不同关系模式(语法依赖、指代关系、位置邻近等)。C 错在最基础的地方:Transformer 的参数量由词向量维度、头数、前馈层宽度决定,与序列长度无关——这正是它能灵活处理变长序列的前提。
用一段可复算的完整手算把这条计算链钉死。背景:取长度为三的序列、键维度 dk 为二的小注意力,数值刻意取整数便于笔算复核。
# 手工缩放点积注意力:全流程逐步打印(数值可笔算复核) import math def softmax(xs): m = max(xs) # 减最大值防溢出,不改变分布形状 ex = [math.exp(x - m) for x in xs] s = sum(ex) return [e / s for e in ex] def matmul(A, B): return [[sum(a * b for a, b in zip(row, col)) for col in zip(*B)] for row in A] def transpose(A): return [list(r) for r in zip(*A)] # 背景设定:序列长度三,维度二;当前词发出查询,全序列提供键与值 Q = [[2, 0]] # 查询:与首把键同向 K = [[2, 0], [0, 2], [1, 1]] # 三把键 V = [[1, 0, 0], [0, 1, 0], [0, 0, 1]] # 三条值取单位阵,输出权重即输出向量 scores = matmul(Q, transpose(K)) # 环节一:打分 scaled = [[x / math.sqrt(2) for x in row] for row in scores] # 环节二:缩放 w = softmax(scaled[0]) # 环节三:行归一化 out = [sum(wi * v[j] for wi, v in zip(w, V)) for j in range(len(V[0]))] # 环节四:加权求和 print("打分: ", scores[0]) print("缩放后:", [round(x, 4) for x in scaled[0]]) print("权重: ", [round(x, 4) for x in w]) print("输出: ", [round(x, 4) for x in out]) # 输出: # 打分: [4, 0, 2] # 缩放后: [2.8284, 0.0, 1.4142] # 权重: [0.8756, 0.0266, 0.0978] # 输出: [0.8756, 0.0266, 0.0978]
结果解读:查询与首把键方向完全一致,打分一骑绝尘,softmax 后拿走近八成八的权重;输出向量随之近似等于首条值向量。本例把值取成单位阵,于是"输出"与"权重"逐位相等,加权了谁一眼可辨。变式:把查询改成 [0, 2] 再重跑,权重会倒向第二把键——动手改一行,检验你对打分环节的掌控。
再做缩放必要性的对照实验,看看"不除会怎样":
# 缩放 vs 不缩放:softmax 分布形状对照实验(随机种子固定,可复现) import math, random random.seed(7) def softmax(xs): m = max(xs); ex = [math.exp(x - m) for x in xs] s = sum(ex); return [e / s for e in ex] dk = 64 q = [random.gauss(0, 1) for _ in range(dk)] k = [random.gauss(0, 1) for _ in range(dk)] raw = sum(a * b for a, b in zip(q, k)) # 原始点积,方差约等于 dk scaled = raw / math.sqrt(dk) # 缩放后,方差回到约 1 for tag, x in [("不缩放 ", raw), ("除以根号dk", scaled)]: w = softmax([x, 0.0, 0.0]) # 与两条零分候选竞争 top = max(w) ent = -sum(p * math.log(p + 1e-12) for p in w) print(f"{tag}: 打分={x:8.2f} 最大权重={top:.4f} 熵={ent:.4f}") # 输出: # 不缩放 : 打分= 30.31 最大权重=1.0000 熵=0.0000 # 除以根号dk: 打分= 3.79 最大权重=0.9682 熵=0.0848
不缩放时打分冲到三十多,softmax 退化为 one-hot,其余候选彻底出局——梯度随之中断;缩放后分布保持可塑,各位置仍有梯度流动。这就是"方差拉回一"的实战含义:不是让注意力更弱,而是让它保持可学性。
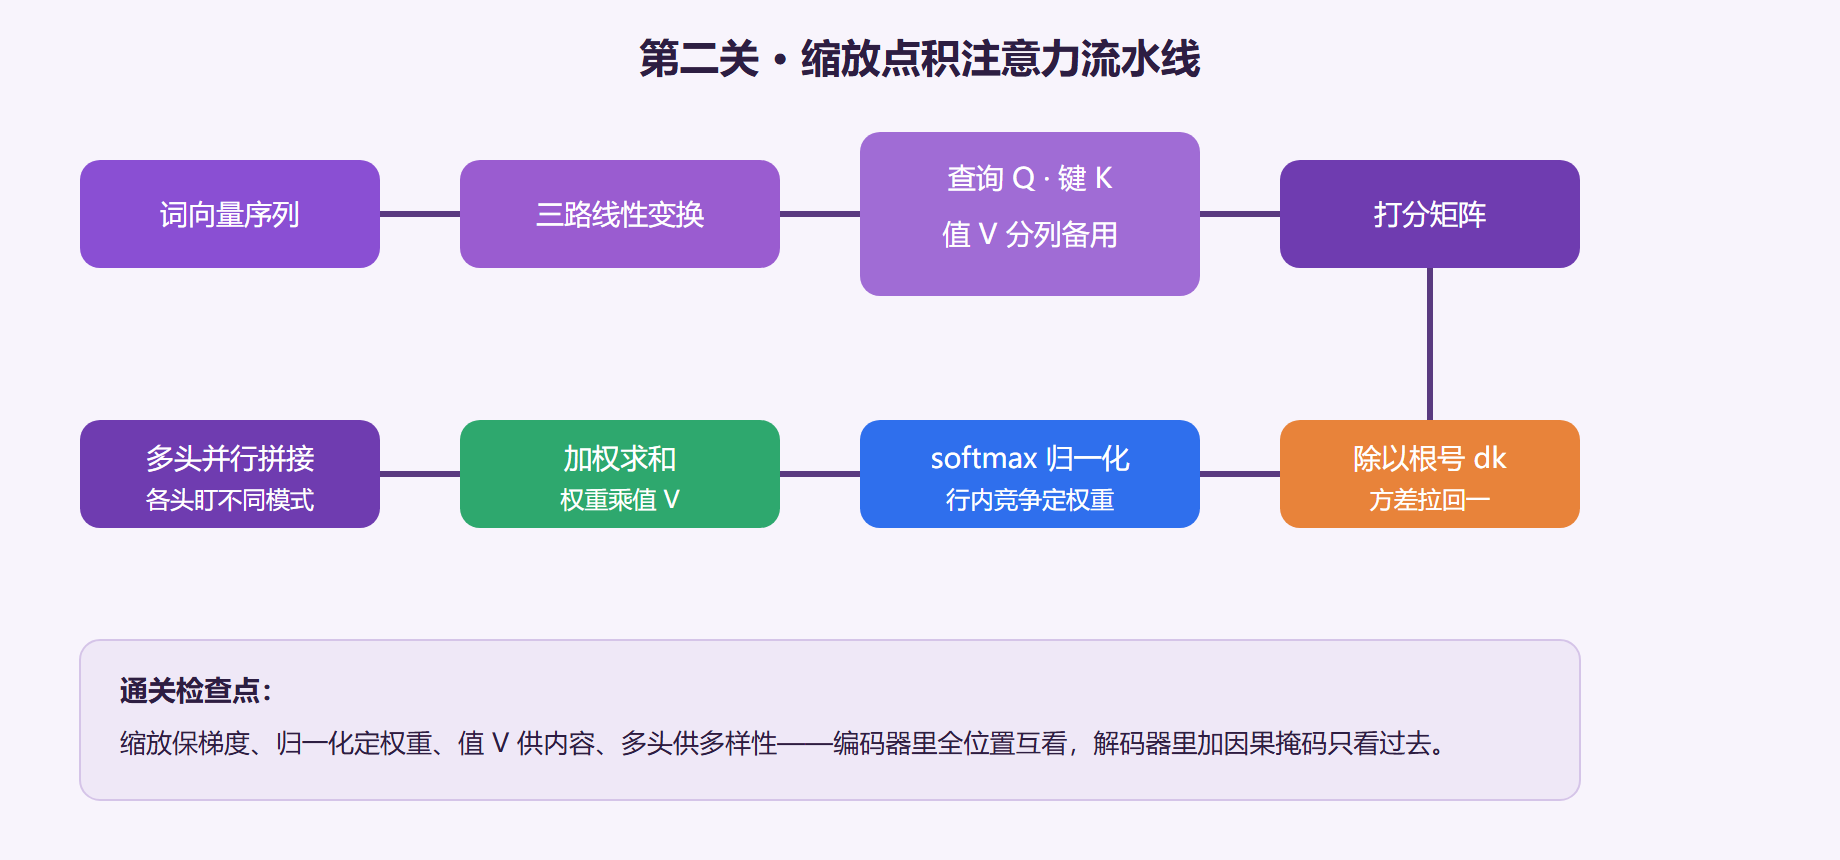
图:注意力计算流水线
橙色环节(缩放)与蓝色环节(归一化)是数值稳定性的关卡所在,也是面试追问最密的两处。
复盘:易错点与变式
易错点一:把缩放因子记成除以 dk。除以 dk 会把方差压到 1/dk,分布过平,注意力"雨露均沾",区分度反而受损;正确是除以根号 dk——方差相加归一,标准差才开根号。数值实验里那个"打分三十多"的反例,就是漏了根号的下场。
易错点二:认为位置编码可有可无,"反正注意力很强"。置换等变性已经证明:没有位置信息的注意力分不清"我打你"和"你打我"这类语序决定语义的句子。位置编码是语义成立的根基,不是锦上添花。
易错点三:把多头理解成"多个模型投票"。多头共享同一套输入,各头在自己降维后的子空间算注意力,输出拼接后再过线性层融合——是"分视角观察、统一汇合",不是独立模型的集成。
变式一:面试官问"自注意力的计算复杂度,瓶颈在哪"。答:打分矩阵是序列长度平方级的乘加,长度翻倍、计算量翻四番;长文档场景的稀疏注意力、滑动窗口注意力都从这条瓶颈推导出来。
变式二:问"解码器为什么需要因果掩码"。答:训练时目标序列整块喂入,若不遮住当前位置之后的位置,模型等于偷看答案,训练与推理条件不一致;掩码把打分矩阵上三角置为负无穷,softmax 后未来位置权重归零,与逐词生成的推理过程对齐。
复盘产出:决策卡"注意力流水线"一栏补齐,缩放因子与位置编码两个高频坑已钉死。下一关进入范式会战:BERT 与 GPT 把本关的注意力模块分别组装成双向编码与单向解码两条路线,考的不再是模块细节,而是路线选择。