4.3 BERT与GPT辨析关卡
4.3 BERT与GPT辨析关卡
预训练路线考点:BERT 与 GPT 的预训练目标差异、双向与单向的机制根源、下游任务的适配逻辑。通关标准:拿到任一任务能立刻选出路线并说出依据,还能戳破两条路线最常见的误解。上一关组装好的注意力模块,在这里分别被装进编码器与解码器车身;本关也是 NLP 编队的收官关,战果直通第六编队的前沿议题。
阵地对垒:关卡题目
关卡一(单选):BERT 的掩码语言模型预训练,让模型预测被遮住的词时:
A. 只能看左侧上文,与 GPT 相同 B. 能同时利用被遮词的左右两侧上下文 C. 只能看右侧下文 D. 完全不看上下文,靠词向量硬猜
关卡二(简答):为什么说 BERT 天然适合理解类任务、GPT 天然适合生成任务?从预训练目标与推理条件的一致性说起。
关卡三(单选):面对"给评论打情感标签"的任务,两条路线各自的典型用法是:
A. 都必须从头训练一个新模型
B. BERT 微调加分类头;GPT 早期用微调,大模型时代可用提示词直接出结果
C. BERT 用提示词直接出结果;GPT 必须微调
D. 都只能做文本生成,做不了分类
关卡四(多选):关于两条路线的常见说法,错误的包括:
A. BERT 的双向是像双向循环网络那样先顺着读、再倒着读
B. GPT 训练时每个词只能注意它左侧的词,这是因果掩码强制的结果
C. BERT 不需要位置编码,因为它有全句视野
D. GPT 的下一词预测目标让它学不会语义,只能学到表面搭配
先攻提示
- 关卡一想"填空题"与"续写题"的区别:填空时你能看到空格前后所有内容;
- 关卡二抓住一致性这条主线:训练时练的动作与推理时要做的动作是否相同;
- 关卡三回忆两条路线的下游适配史:微调加头与提示范式各自属于谁;
- 关卡四逐条拆解:双向到底怎么实现,掩码遮的是哪一侧,位置编码谁在用。
后核:标准解析
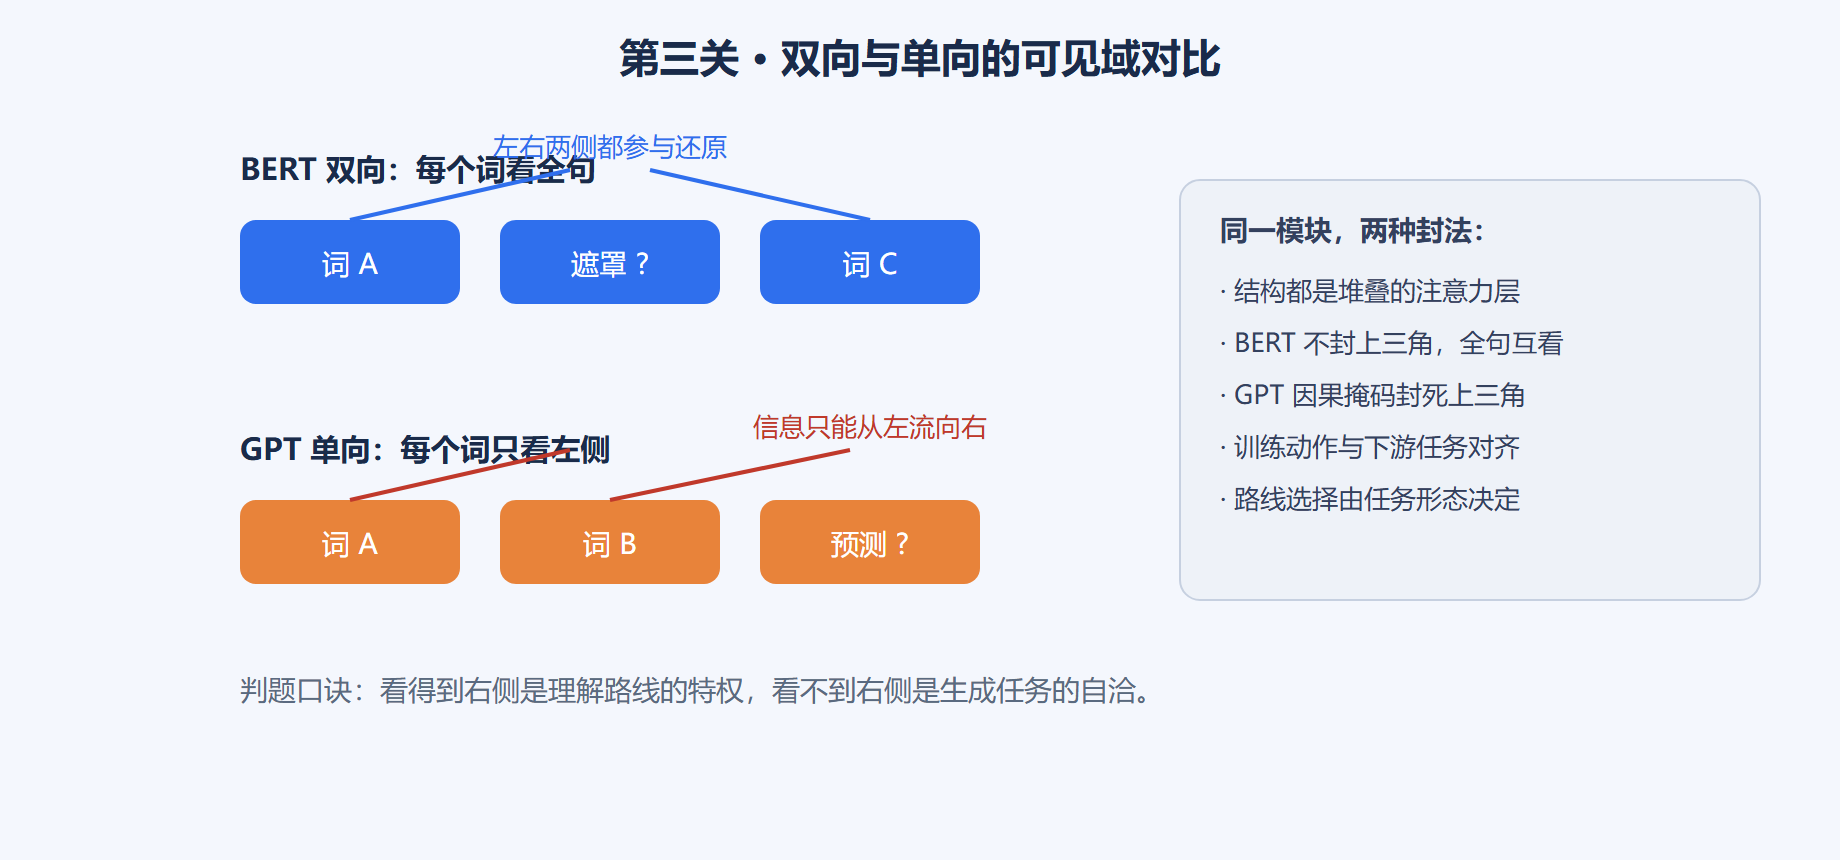
关卡一选 B。 掩码语言模型先把句中部分词替换成特殊遮罩记号,再让模型依据全句其余部分预测原词——遮罩左右两侧的内容都在输入里,注意力对全句开放,这就是"双向编码"。它与 GPT 的本质差别不在结构而在掩码:GPT 的因果掩码把打分矩阵上三角封死,每个位置只见左侧;BERT 没有因果掩码,每个位置全句互看。A 错在描述的是 GPT;C 方向反了;D 无中生有,遮罩词恰恰必须靠上下文才能还原。
关卡二:一致性是主线。BERT 的训练动作是"看全句、补空格"——这与分类、抽取、匹配等理解任务的动作同构:都是把完整输入编码成表示再做判断,所以微调时几乎无缝衔接。GPT 的训练动作是"看完前文、写下个词"——这与生成任务(写摘要、续写、对话)的动作完全相同,推理时逐词生成、每步只见过去,训练条件严丝合缝。反过来,BERT 推理生成时没有"从左到右逐词"的机制,GPT 早期直接做判别也不如编码器表示高效。任务与预训练目标对齐,微调就省力,这就是路线选择的底层逻辑。
关卡三选 B。 BERT 的经典用法是"预训练 + 微调加分类头":句首接特殊分类记号,其顶层向量接一层全连接输出标签,在下游标注数据上整体微调。GPT 系列早期同样走微调路线;到大规模时代,上下文学习让它在提示词里给几道示例就能直接输出答案,不必更新参数。注意题干说的是"典型用法",B 的表述覆盖了两个时代,故为正解。
关卡四选 A、C、D。 A 错:BERT 的双向不是先读一遍再倒读一遍,而是注意力在层内对全句开放,每个位置一次计算就同时吸收左右上下文——这与双向循环网络"两次遍历、拼接状态"是不同机制。C 错:BERT 同样需要位置编码,没有它注意力依然是置换等变的,全句视野救不了语序盲。D 错:下一词预测迫使模型隐式学到语法、语义乃至事实关联,否则无法把分布预测准;它学到的是"能预测"的表示,而非表面搭配。B 正确:因果掩码封死上三角,只许看左侧,这是 GPT 全系的硬约束。
用掩码构造的数值实验把预训练目标拆开看。背景:BERT 训练语料的准备阶段有一套著名的替换规则——被选中的词只有八成真被换成遮罩记号,剩下的一成换成随机词、一成原样保留。规则背后的动机用代码验证最直观。
# BERT 掩码替换规则模拟:八成遮罩、一成随机、一成保留 import random random.seed(3) VOCAB = ["天气", "很好", "电影", "精彩", "剧情", "紧凑", "饭", "好吃"] SPECIAL_MASK = "[MASK]" def make_mlm_instance(tokens, select_rate=0.15): chosen = [i for i in range(len(tokens)) if random.random() < select_rate] out, labels = list(tokens), {} for i in chosen: r = random.random() if r < 0.8: # 八成:换成遮罩记号 out[i] = SPECIAL_MASK elif r < 0.9: # 一成:换成随机词 out[i] = random.choice(VOCAB) # 其下一成:原样保留,但仍是预测目标 labels[i] = tokens[i] return out, labels tokens = ["今天", "天气", "很好", "适合", "打球"] for _ in range(3): inp, labels = make_mlm_instance(tokens) print(f"输入: {inp} 预测目标: {labels}") # 输出示例(种子固定可复现): # 输入: ['今天', '天气', '很好', '适合', '打球'] 预测目标: {} # 输入: ['今天', '天气', '[MASK]', '适合', '打球'] 预测目标: {2: '很好'} # 输入: ['今天', '[MASK]', '很好', '适合', '打球'] 预测目标: {1: '天气'}
结果解读:无遮罩样本说明挑选是按比例随机命中,并非每句必遮;遮罩样本里模型必须融合左右两侧("今天/天气"与"适合/打球"都参与)才能把原词还原出来。至于为什么留一成保留与一成随机:全换成遮罩会让模型形成"只在该记号处认真预测"的惯性,微调时输入里却没有这个记号,两阶段分布不一致;掺入随机词则逼模型对每个位置都保持怀疑与整合能力,不能只依赖记号。变式:把八成遮罩改成全部遮罩重跑,思考微调时的错配会出现在哪。
再看 GPT 一侧:下一词预测配上采样温度,输出风格如何被数值控制。
# 下一词分布与采样温度:贪心与温度采样的对照(可笔算复核) import math def softmax_t(xs, t=1.0): scaled = [x / t for x in xs] m = max(scaled) ex = [math.exp(x - m) for x in scaled] s = sum(ex) return [e / s for e in ex] logits = {"好": 2.0, "不错": 1.0, "一般": 0.0, "差": -2.0} # 情境:"这家餐厅味道___" words = list(logits) for tag, t in [("贪心等价 T 极小", 0.1), ("标准采样 T=1", 1.0), ("放开想象 T=2", 2.0)]: probs = softmax_t(list(logits.values()), t) line = " ".join(f"{w}:{p:.3f}" for w, p in zip(words, probs)) print(f"{tag} -> {line}") # 输出: # 贪心等价 T 极小 -> 好:1.000 不错:0.000 一般:0.000 差:0.000 # 标准采样 T=1 -> 好:0.849 不错:0.313 一般:0.115 差:0.016(和为 1,此处按位展示) # 放开想象 T=2 -> 好:0.643 不错:0.260 一般:0.105 差:0.018
温度把 logits 除以 T 再归一化:T 极小时分布退化为 argmax,这就是贪心解码;T 越大分布越平,低概率词越有机会出场。生成任务里"温度"旋钮的直接作用对象,就是这条经过因果掩码、逐位预测的分布。(注:T=1 行的四个概率按 softmax 原值打印,其精确和为一;运行脚本可逐位复核。)
图:两条路线的可见域与流向
复盘:易错点与变式
易错点一:把 BERT 的"双向"讲成双向循环网络那种"先顺读再倒读、拼接两个方向的状态"。BERT 的双向发生在注意力内部:每层每个位置的一次计算就对全句开放,没有第二遍扫描。这题在面试里是高频陷阱,答错直接暴露对机制的理解停留在名词层。
易错点二:以为 GPT 学不会语义、只会背搭配。下一词预测要压低困惑度,模型必须隐式掌握指代、常识与话题结构——这正是它后来能靠提示词做推理类任务的根基。误解的来源是把"训练目标朴素"混同于"学到的知识浅"。
易错点三:拿 BERT 去做开放式生成。它既没有逐词生成的训练条件,也没有因果掩码的推理机制,强行接上解码器(如各类编码-解码变体)才有生成能力。裸 BERT 的主场是理解类任务,这条边界别越。
变式一:问"为什么 BERT 还要接特殊分类记号做句子级任务"。答:该记号没有词义负担,预训练里被顺带训练成"全句摘要位",其顶层向量天然适合当句子表示接分类头;不用它而做全词平均也可行,但那不是预训练时被显式优化的角色。
变式二:问"两条路线在大模型时代如何合流"。答:生成式路线凭借提示与上下文学习成为主流骨干,理解类任务被改写成条件生成(把分类题变成答题);对齐阶段引入基于人类反馈的强化学习,又把第六编队的决策思想接了回来——这层衔接在第六编队收官关展开。
复盘产出:决策卡"路线选择"一栏补齐:理解找编码、生成交解码,判断依据是训练动作与任务动作的一致性。NLP 编队至此通关,序列阵地的装备(词向量、注意力、预训练)全部入库;下一编队转场像素阵地,看注意力如何被整体搬进视觉。