5.1 图像表示与经典网络关卡
5.1 图像表示与经典网络关卡
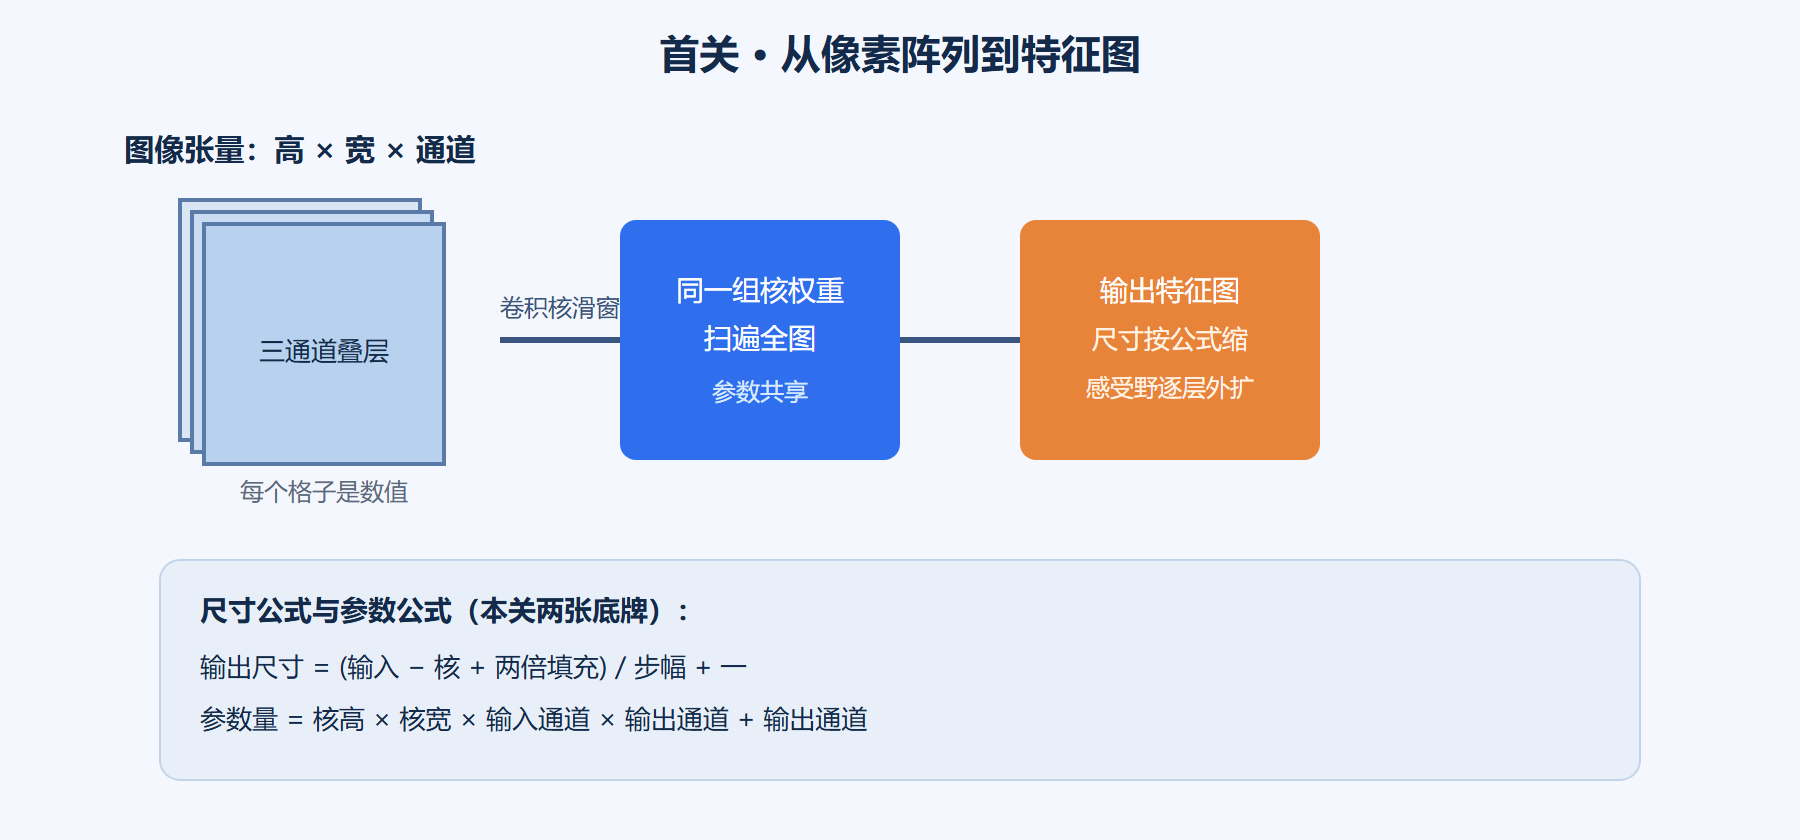
图像表示考点:图像的张量形状与存储量、卷积输出尺寸公式、参数共享与感受野。通关标准:给出网络配置能逐层报出特征图尺寸与参数量,误差为零。视觉编队首关:先把图像翻译成模型能消化的数字,账本算不清后面全乱。
前哨布题:关卡题目
关卡一(单选):一张高宽各为二百二十四、通道为三的图像进入模型时的张量形状,以及不考虑批量的数值总个数是:
A. 形状为高、宽、通道的三阶张量,数值个数约十五万
B. 形状为高、宽的二维矩阵,数值个数约五万
C. 形状为高、宽、通道的三阶张量,数值个数约五万
D. 一条长度约十五万的一维向量
关卡二(计算):输入特征图尺寸为三十二乘三十二,用五乘五卷积核、步幅一、不填充,输出特征图的尺寸与该层参数量(输入通道三、输出通道六)分别是多少?
关卡三(简答):卷积层的参数共享省参数的机制是什么?它与感受野有什么关系?
关卡四(单选):批处理维度为八时,一批上述图像的张量总维度是:
A. 八乘高乘宽乘通道,共四阶 B. 高乘宽乘通道乘八,共三阶 C. 八乘高乘宽,共三阶 D. 与批量无关
先攻提示
- 关卡一抓住"三阶张量"这个关键:高、宽、通道缺一不可,数值个数是三者相乘;
- 关卡二直接套输出尺寸公式,参数量只与卷积核尺寸、输入输出通道有关,与特征图大小无关;
- 关卡三从"同一个卷积核扫遍全图"这句话展开,再想感受野如何随层数叠加;
- 关卡四想批量维加在最外侧,维度总数加一。
后核:标准解析
关卡一选 A。 图像进模型是高、宽、通道三阶张量,数值个数 = 高乘宽乘通道,约十五万出头。B、C 错在丢通道或数错乘积;D 错在"拉平成向量"是进入全连接层之后的事,卷积层看到并利用的是二维邻域结构——把图拉平恰恰丢掉了空间关系,这也是卷积路线存在的理由。
关卡二:输出尺寸 = (三十二 − 五) / 一 + 一 = 二十八,即二十八乘二十八。参数量 = 卷积核高乘宽乘输入通道乘输出通道 + 输出通道(偏置)= 五乘五乘三乘六 + 六 = 四百五十六。注意参数量与输入特征图大小无关——这正是参数共享的威力:全图扫一遍,用的始终是同一组核权重。逐层尺寸用代码推演:
# 卷积输出尺寸公式 + 经典首层推演(全部整数运算,可笔算复核) import math def conv_out(size, kernel, stride=1, pad=0): return (size - kernel + 2 * pad) // stride + 1 def conv_params(in_ch, out_ch, kernel, bias=True): return in_ch * out_ch * kernel * kernel + (out_ch if bias else 0) # 背景:LeNet 式首层,输入灰度图 32x32,5x5 卷积核,输出通道 6 print("输出尺寸:", conv_out(32, 5)) # 输出: 28 print("参数量: ", conv_params(1, 6, 5)) # 输出: 156 # 推演链:卷积后接 2x2 池化,尺寸减半 size = 32 chain = [("输入", size, (1,))] for i, k in enumerate([5, 5], start=1): size = conv_out(size, k) pooled = size // 2 chain.append((f"卷积{i}", size, (k, k))) chain.append((f"池化{i}", pooled, (2, 2))) for name, s, ks in chain: print(f"{name}: {s}x{s} 核:{ks}") # 输出: # 输入: 32x32 核:(1,) # 卷积1: 28x28 核:(5, 5) # 池化1: 14x14 核:(2, 2) # 卷积2: 10x10 核:(5, 5) # 池化2: 5x5 核:(2, 2)
结果解读:尺寸沿"卷积缩边、池化减半"两条规则推进,全程可笔算复核——考场上先画这条链再答题,尺寸类题目零失误。变式:给卷积一加上填充二重跑,卷积后尺寸变成三十二((三十二 − 五 + 四) + 一 = 三十二),这就是"same 填充"维持尺寸的机制。
关卡三:机制是"一个核扫全图":检测竖直边缘的那个卷积核,在图像左上角和右下角用的是同一组权重——先验假设是"边缘检测规律与位置无关",于是参数量从"每个位置一套权重"的天文数字降到只与核尺寸和通道数相关。感受野则是输出的一个数值能看到多大输入区域:单层卷积的感受野等于核尺寸,两层三乘三叠加后,视野并不是简单相加,而是按公式逐层外扩(三层三乘三的感受野达到七乘七)。共享管"参数多不多",感受野管"看得多宽",两者正交。
关卡四选 A。 批量维加在最外侧:八乘高乘宽乘通道,维度总数为四。B 把顺序与维度数都弄错;C 丢通道;D 忘了批处理只是把样本叠一摞,每个样本内部形状不变。
再算一笔参数量对照账,看参数共享到底省了多少。背景:同样的分类任务,全连接与卷积两种接法参数量差距悬殊,这一笔账是"为什么视觉先用卷积"的核心论据。
# 参数量对照:全连接直连 vs 卷积共享(数值可笔算复核) H, W, C = 224, 224, 3 # 输入图像 OUT = 10 # 分类数 # 方案一:拉平后直接接全连接 flat = H * W * C fc_params = flat * OUT + OUT print(f"拉平后维度: {flat}") # 输出: 150528 print(f"全连接参数量: {fc_params:,}") # 输出: 1,505,290 # 方案二:单层卷积核 3x3、输出通道 64,再全局池化接 10 类 conv_k = 3 conv_params = C * 64 * conv_k * conv_k + 64 # 3*64*9 + 64 head_params = 64 * OUT + OUT print(f"卷积层参数量: {conv_params:,}") # 输出: 1,792 print(f"分类头参数量: {head_params:,}") # 输出: 650 print(f"参数比: {fc_params / (conv_params + head_params):.0f} 倍") # 输出: 参数比: 617 倍
结果解读:全连接对每个输入位置单独配权重,参数量随图像分辨率平方级膨胀;卷积只配一组核权重,与分辨率解耦,差距达数百倍。更关键的隐性收益是归纳偏置:卷积天然平移不变——猫在图里挪个位置,同一组核照样响应。变式:把分辨率翻倍重跑,观察全连接参数量涨到四倍而卷积参数量纹丝不动。
复盘:易错点与变式
易错点一:把张量布局的通道顺序当成铁律。有些框架按高宽通道读图、按通道高宽进网络,入模前要换轴——面试里说"形状"时务必带上维度顺序,只报三个数字不给顺序等于没答。
易错点二:以为池化层有参数。池化只是取最大或平均,没有任何可学习权重,参数量贡献为零;把池化计进参数账是新手卷积账本最常见的错行。
易错点三:把感受野等同于卷积核尺寸。单层确实如此,但深层网络的实际感受野是逐层叠加外扩的——判断"这个特征能看到多远的上下文"时,要沿层数推算,不能只看最后一层的核。
变式一:问"步幅二和池化都能降采样,怎么选"。答:步幅卷积带可学习权重、能顺带改变通道数,池化零参数、纯降采样;现代网络更倾向步幅卷积,经典网络多用池化——考的是"降采样发生在哪一层"的读图能力。
变式二:问"为什么输入要做归一化"。答:把像素从零到二百五十五压到零附近的窄区间,各通道量纲一致,损失面更圆、梯度更稳;不归一化的网络前期更新会被大数值通道主导,收敛明显变慢。
复盘产出:决策卡"卷积账本"一栏补齐,尺寸与参数两条公式已入库。下一关把镜头拉远:单层卷积怎么长成整部架构演化史,代际突破各有各的账。