第六章:强化学习与前沿编队
第六章 · 强化学习与前沿编队
本章要回答的核心问题:决策问题怎么写成数学模型?不靠地图的智能体怎么靠试错学出最优路线?深度网络接管感知之后,强化学习又通向了哪里?全册最后这支编队,负责收拢决策与前沿两块高地。
为什么会有这一章
强化学习理论题的核心矛盾是"试错信号对最优决策"。监督学习有标准答案可抄,决策问题只有奖励这种延迟、稀疏、带噪声的评价——怎么从"当时感觉还行"反推"长远哪个动作最好",是整章的主轴。它还是全册综合性最高的阵地:建模靠概率直觉,求解靠迭代计算,深度化靠卷积读画面,前沿化靠预训练与对齐思想接力。前面编队的家底(梯度、注意力、骨干网络)在这里全部上桌。
本章三关按"建模 → 试错求解 → 深度与前沿"推进:先把决策写成马尔可夫决策过程并算通贝尔曼方程,再让智能体在未知环境里用 Q-learning 迭代出最优路线,最后登顶深度强化学习并把前沿概念挂接回全册地图。
读完能解决什么
- 把决策问题翻译成状态、动作、转移、奖励、折扣因子这套元组,并判别马尔可夫性是否成立;
- 手算折扣回报与贝尔曼方程的迭代收敛过程;
- 徒手算一轮 Q 值更新,完整跑通网格世界的 Q-learning 求解并读出贪心路径;
- 说清 Q 表走向深度网络的三步动机:状态爆炸、样本相关性、目标漂移;
- 把大模型时代的预训练、提示与对齐概念挂回本册知识树,答得出"从哪里长出来的"。
各节怎么分工
| 节号 | 回答哪个问题 | 关键产出 |
|---|---|---|
| 第一节 MDP与贝尔曼方程关卡 | 决策问题怎么数学化 | 小型 MDP 的价值迭代手算 + 折扣敏感性实验 |
| 第二节 Q-learning数值迭代关卡 | 不看地图怎么试错学路线 | 网格世界 Q 表全量迭代 + 时序差分单步拆解 |
| 第三节 DQN与前沿概念关卡 | 网络接管后走向哪里 | 深度化三件套动机 + 全册概念收拢图 |
本章关卡地图
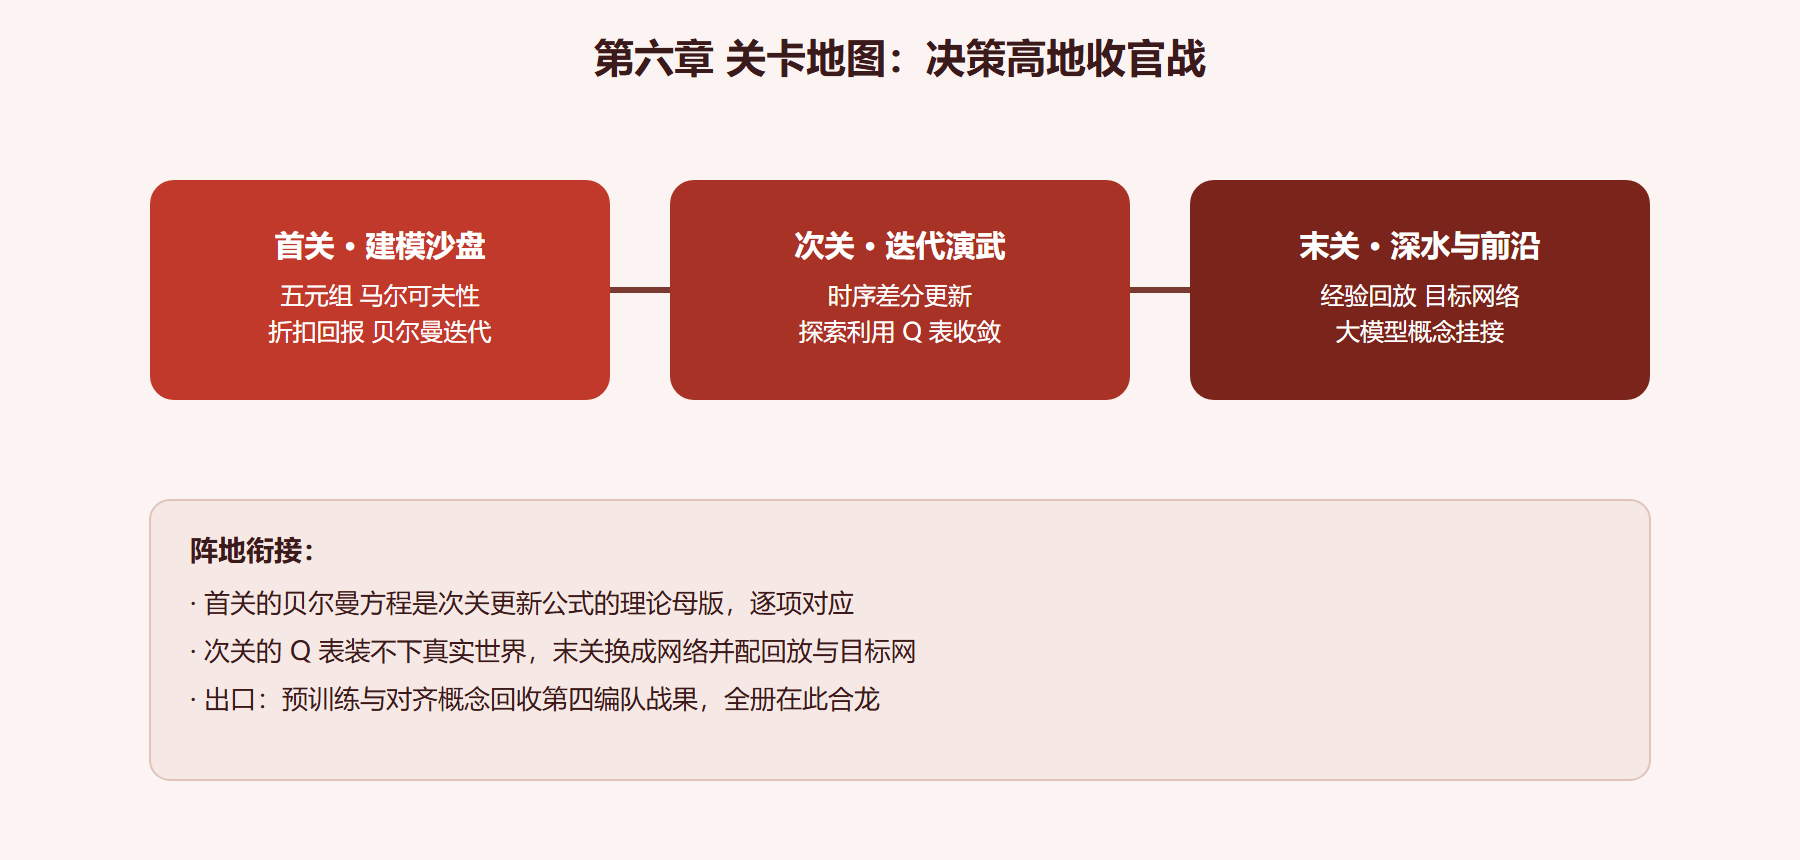
从建模到前沿的演进全景
链条读法:每换一段就是一次"假设被放松"——已知转移假设被无模型试错放松,表格假设被函数逼近放松,单智能体假设被人类偏好对齐放松。前沿概念看似散乱,挂回这条"放松假设"的主线就都各归其位。
本章可考核知识点清单
| 知识点 | 达标线 | 对应关卡 |
|---|---|---|
| 五元组与马尔可夫性 | 把场景翻译成元组并判别状态刻画是否充分 | 首关 |
| 折扣回报 | 给定奖励序列与折扣因子手算累积回报 | 首关 |
| 贝尔曼方程迭代 | 手推小型 MDP 价值函数收敛过程 | 首关 |
| 时序差分更新 | 徒手算单步 Q 值并解释每项含义 | 次关 |
| 探索与利用 | 设计并解释 epsilon 贪心调度 | 次关 |
| Q-learning 对 SARSA | 说清目标值用最大还是用实际动作 | 次关 |
| 深度化三件套 | 状态爆炸、样本相关性、目标漂移逐条对应解法 | 末关 |
| 前沿概念挂接 | 预训练、提示、对齐各自从哪条线长出 | 末关 |
先决条件
- 第三章的梯度与网络训练直觉(末关的函数逼近需要它);
- 第五章的卷积骨干(末关讲"用卷积读画面做决策"直接征用);
- 第四章的预训练概念(末关的前沿挂接回收该战果);
- 不需要概率论进阶:全章验算只用加减乘除与取最大值。
往下走到哪
本章是全册的合龙口:建模语言(MDP)、试错机制(时序差分)、深度装备(回放与目标网)三件套到手后,第六编队末关把前沿概念一一挂回前五章的知识树,全册地图闭环。学完本册的正确姿势是回到导读的知识地图,把每道关卡的产出卡摆回原位——检验理论掌握程度的最后标准,是你能把这张地图讲给别人听。
评论区
(0)
U