第1章 热身现场:基础代码题
第1章 热身现场:基础代码题
章节摘要:本章跟着一场"电话面到现场面"的热身线走——三道看似人畜无害的 Python 题,各自把一批候选人挡在了下一轮之外。词频统计筛掉不熟悉字典细节的人,LRU 缓存筛掉没写过生产代码的人,迭代器类筛掉只会用类当结构体的人。三道题连起来,就是热身现场的完整心电图。
一条主线
主线是一位候选人的热身轮实录:开局一道词频统计,他两分钟写完,却在追问"如果要取前 k 个高频词"时暴露了对堆的不熟;第二题 LRU,他第一版用了列表扫描,在面试官提示"get 也要常数复杂度"后才想起 OrderedDict;第三题手写迭代器,他卡在了 yield 与 __next__ 的区别上。本章按这三道题推进,每一节都是一次完整的现场还原。
热身题的价值不在难度,而在"追问空间"。一道十行代码的题,面试官可以从时间复杂度一路问到线程安全。后面第 3 章的卷积现场、第 6 章的动态规划现场,本质上都是把这里的推演方法放大到更复杂的题目上。热身轮的评分表其实也只有两行:代码习惯是否稳定,被追问时是否诚实——答不上来时说"这里我不熟",比硬编一个答案的印象分高得多。
沿途站点
图 1-1 第 1 章三道热身题的能力考查分层
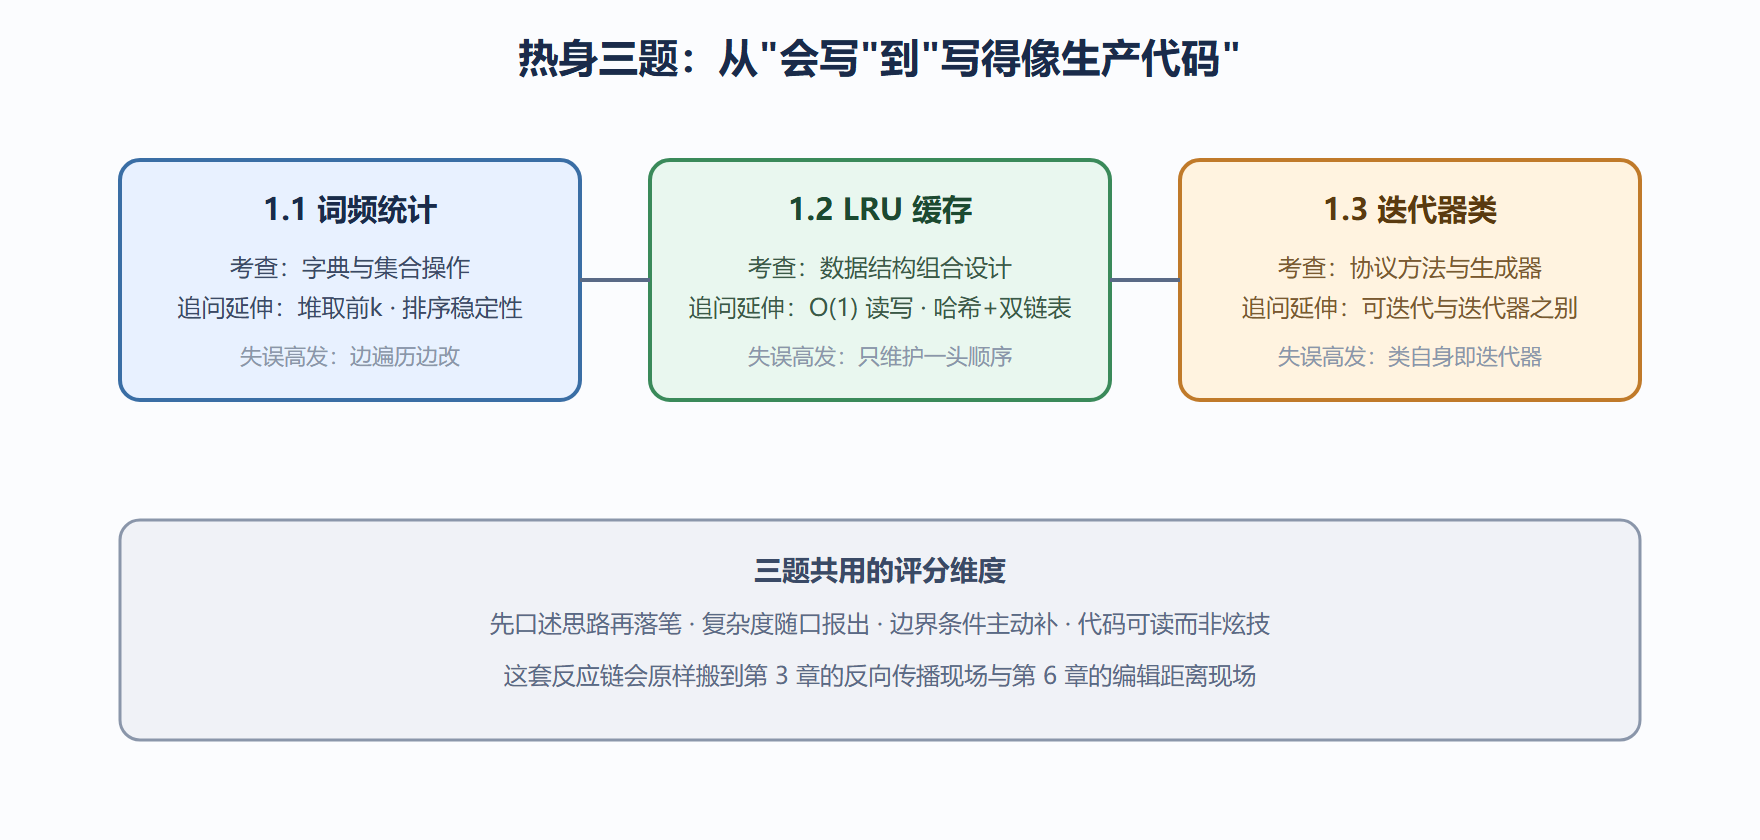
现场一(词频统计) 推进到"字典功力":从 Counter 一行解,到手工 reduce,再到堆取前 k 个,追问链一路通向排序稳定性。它建立的是本章的方法论——先用最直白的方式写对,再逐层优化。
现场二(LRU 缓存) 推进到"结构设计":单靠一种内置结构写不出读写都常数时间的缓存,必须组合哈希表与双链表。这是热身轮里第一次出现"设计"而非"实现"的考查。
现场三(迭代器类) 推进到"协议理解":可迭代对象与迭代器的分界、yield 的惰性求值、为什么 for 循环不会越界。它收束本章,也直接铺垫第 5 章 NLP 现场里的数据加载器写法。
拐点与结论
本章真正的认知拐点在 LRU 那一节:很多候选人以为热身题考"背 API",做到 LRU 才明白考的是"当你需要的操作没有现成结构支持时,你敢不敢自己组合一个"。这个拐点之后,看第 3 章手写反向传播的眼光会完全不同——反向传播也不过是"框架替你做了,现在要你自己组合"。
结论有三条:热身题的评分重心在追问环节;复杂度要随口报出而不是被问了才算;第一版代码宁可朴素,也要正确、可读、有边界处理。
读完你应该
- 能用 Counter 与手工字典两种方式完成词频统计,并说明各自适用场景
- 能用 heapq 在无序词频里取前 k 个高频词,复杂度报到对数级别
- 能独立写出读写均为常数时间的 LRU 缓存,解释哈希表与双链表各自承担的操作
- 能说清可迭代对象与迭代器的区别,并手写一个支持 for 循环的类
- 能把词频统计的流式 top-k 变体讲清楚:固定规模小顶堆在线维护,内存从词种数压到 k
- 面对追问时先复述问题确认理解,再给方案,不抢答
下一章的接力
热身现场结束后,主线候选人进入了机器学习专场。面试官会拿着他刚写过的梯度下降口述,要求"这次不用任何库,纯 numpy 写出来"。第 2 章就把这个接力棒接过来:手写线性回归、手写 KNN、手写交叉验证与 AUC,考查方式从"语言功力"切换到"算法落地"。