第5章 NLP代码现场
第5章 NLP 代码现场
章节摘要:本章是方向专场的第二站。NLP 面试的代码题围绕"变长序列怎么变成规整张量"展开:分词把字符串切成词,词频与 TF-IDF 把词变成向量,注意力把向量序列变成互相感知的表示,位置编码补上顺序信息,最后由一个手写的文本分类器把整条流水线串起来。与 CV 章的形状之弦相对,本章的主弦是掩码。
一条主线
主线候选人走进文本组面试官的房间,开场白只有一句:"视觉的麻烦是形状多了一个通道维,文本的麻烦是长度根本不固定——你的模型参数是死的,句子是活的,中间那道桥怎么搭?"接下来的三个现场,就是这道桥的三段桥墩。
现场十三从最原始的桥墩考起:把一句中文切成词,再把词变成带权重的向量,考查的是字符串处理与统计功底;现场十四把桥修到现代:手写缩放点积注意力与位置编码,追问从 softmax 一路压到掩码与多头;现场十五收束整章——不依赖任何预训练模型,把分词、词表、特征、训练、评估接成一条完整流水线,跑通一个情感二分类。
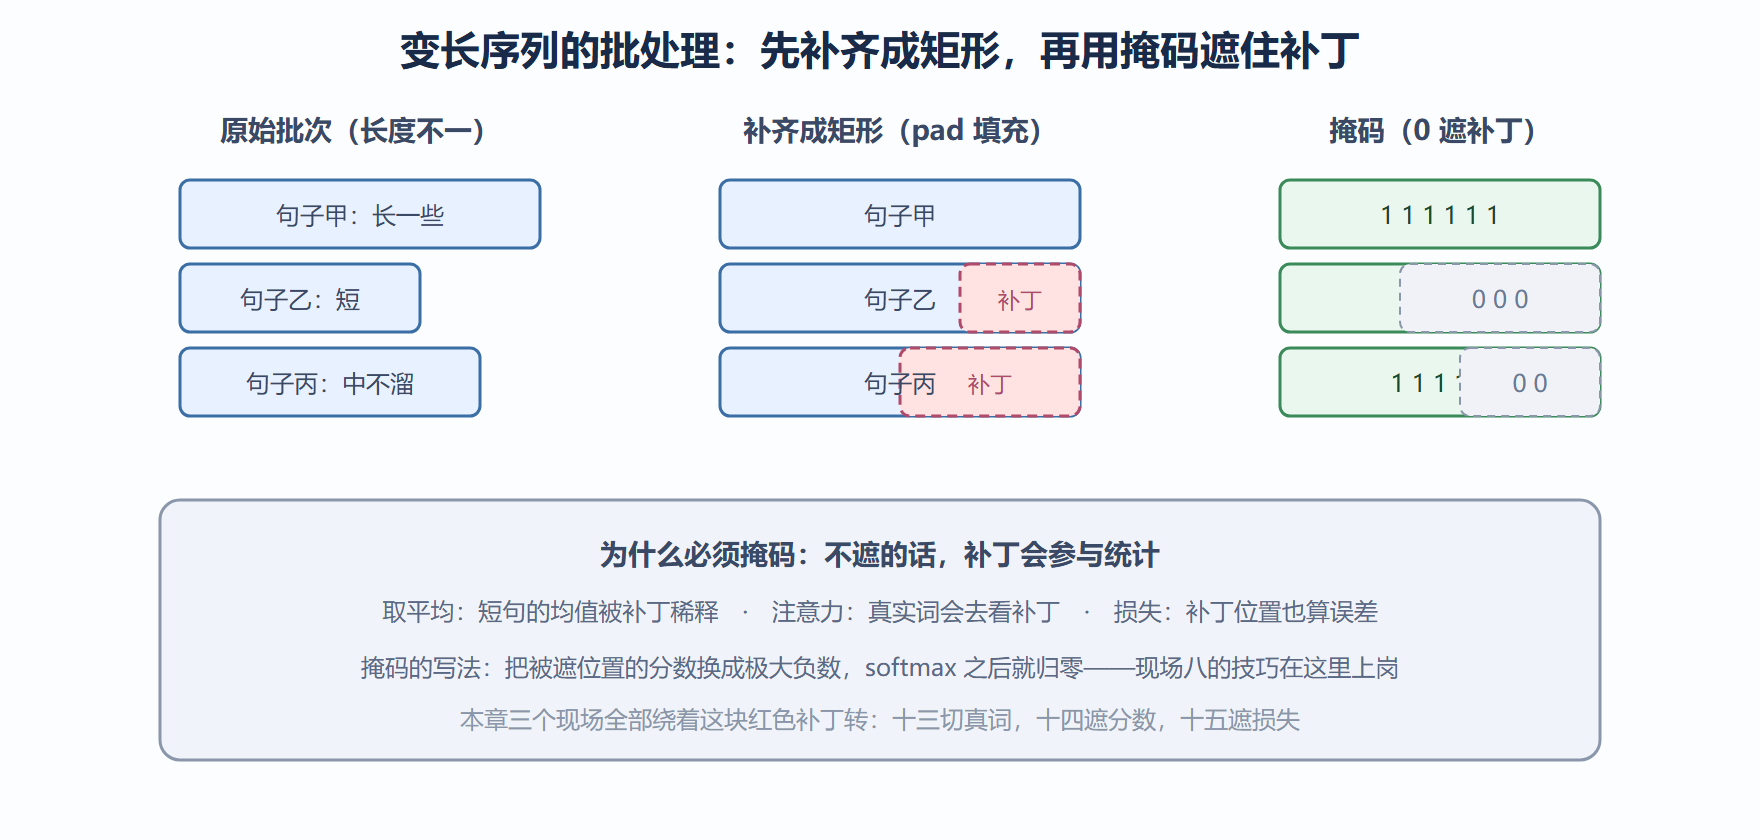
NLP 现场没有 CV 那种"画框自检"的福利,取而代之的是画矩阵:掩码画成下三角,注意力权重画成热力图,变长批处理画成补齐后的矩形。能不能把序列问题"矩阵化"再落笔,是文本组面试官眼里与 CV 等价的那个好习惯。
沿途站点
现场十三(分词与词频向量) 走表示段:正向最大匹配的分词器、词典覆盖与歧义、TF-IDF 的手写与余弦相似度。它直接承接第 1 章现场一的英文词频统计——那一场用正则切英文单词,这一场换成没有空格的中文,切分本身成了考点。
现场十四(手写注意力与位置编码) 走建模段:缩放点积注意力、因果掩码、多头拆分、正余弦位置编码。它承接第 3 章现场八的 softmax 数值稳定——那一场埋下的减最大值技巧,在注意力里每一步都要用。
现场十五(文本分类全流程) 走集成段:构建词表、二值特征、逻辑回归训练、留出集评估,一条线跑通。它是全册的"接线现场":训练循环来自第 2 章现场四,泄漏话题来自现场六与第 4 章现场十,特征化思路来自本章现场十三。
图 5-1 变长序列如何被批处理:补齐与掩码
拐点与结论
本章的拐点在现场十四的后半段:候选人把掩码分数从"负的一亿次方"改成负无穷再改回极大负数,面试官才点头——三种写法里只有最后一种既数值安全又不会在整行全被遮住时算出 nan。掩码写得对不对,光看输出形状看不出来,必须靠扰动实验:把被遮位置之后的值改掉,确认前面的输出纹丝不动。
结论三条:变长序列先补齐再掩码,掩码的正确性靠扰动实验验证;softmax 的数值技巧是 NLP 代码题的公共地基;词表、统计量、特征维度这类"从数据里学出来的东西",只能在训练集上算——这条纪律从表格数据一路管到文本。
读完你应该
- 能手写正向最大匹配分词器,举出词典歧义句(南京市长江大桥式)并解释歧义来源
- 能手写 TF-IDF:词频归一化、逆文档频率取对数,并用余弦相似度比较两篇文档
- 能用 numpy 写缩放点积注意力,报出 Q、K、V、权重、输出的每个形状
- 能写因果掩码与填充掩码,解释为什么用极大负数而不是负无穷
- 能写出正余弦位置编码,说明相邻位置相似、远距位置接近正交的性质
- 能把分词、词表、特征、逻辑回归、评估接成完整流水线,并指出词表泄漏的隐患
下一章的接力
NLP 现场结束时,面试官合上笔记本:"代码题到这里考完了基本功。终面不会让你默写任何算法——它会拿你写过的代码继续往下钻:这段代码复杂度多少?数据量翻百倍怎么办?上线会出什么事?"第 6 章的三个现场——编辑距离、回溯剪枝、工程追问——就是这最后一轮压力测试的完整还原。