5.2 现场十四:手写注意力与位置编码
5.2 现场十四:手写注意力与位置编码
本节摘要:NLP 现场的重头戏:numpy 手写缩放点积注意力,叠上因果掩码,再拆多头、写位置编码。这道题是第 3 章 softmax 数值稳定的直接续集,也是检验"懂不懂 Transformer"的分水岭——背过架构图的人很多,能报出每个矩阵形状并解释掩码写法的人很少。
注意力机制最初不是为今天的那些大模型而生的:它出生在机器翻译里,任务是当对齐器——让译出的每个词回头去看源句子的每个词,决定该"抄"哪里的信息。后来它被简化成自注意力,成为整个序列建模的地基。文本组面试官把这道题放在现场十三之后,用意很明确:词袋 representation 没有顺序、没有交互,注意力一样一样地补上这两个缺口。
题面与考点
"用 numpy 写缩放点积注意力,不要用任何深度学习框架。要求:形状随意但要用真实的小尺寸跑出权重;加上因果掩码——每个位置只能看它自己和它左边的位置;再回答两个问题:为什么点积要除以根号维度?位置编码解决什么问题,写一个能跑的版本。"
考点拆开是四块:注意力的三步计算(打分、归一化、加权求和)、掩码的正确写法、缩放因子的概率动机、位置信息的注入方式。每一块都有现成的背法,也都有背不对的坑。
现场推演
候选人在白板顶上先钉形状:查询 Q、键 K、值 V 各是 (批, 长度, 维度),分数矩阵是 (批, 长度, 长度),权重与分数同形,输出回到 (批, 长度, 维度)。形状钉住了,代码只是翻译:
import numpy as np def softmax(x, axis=-1): x = x - x.max(axis=axis, keepdims=True) # 现场八的技巧在此上岗 e = np.exp(x) return e / e.sum(axis=axis, keepdims=True) rng = np.random.default_rng(7) Q = rng.normal(size=(1, 4, 8)) K = rng.normal(size=(1, 4, 8)) V = rng.normal(size=(1, 4, 8)) def attention(Q, K, V, mask=None): d = Q.shape[-1] scores = Q @ K.transpose(0, 2, 1) / np.sqrt(d) # (1,4,4) 打分并缩放 if mask is not None: scores = np.where(mask, scores, -1e9) # 被遮位置换成极大负数 w = softmax(scores) # 每行归一化 return w @ V, w # 加权求和 + 权重留作检查 out, w_full = attention(Q, K, V) print('无掩码权重首行:', w_full[0, 0]) causal = np.tril(np.ones((4, 4), dtype=bool)) # 下三角:只准看左边 out_c, w_c = attention(Q, K, V, mask=causal) print('因果权重首行:', w_c[0, 0]) print('因果权重次行:', w_c[0, 1])
无掩码权重首行: [0.148 0.33 0.372 0.15 ] 因果权重首行: [1. 0. 0. 0.] 因果权重次行: [0.443 0.557 0. 0. ]
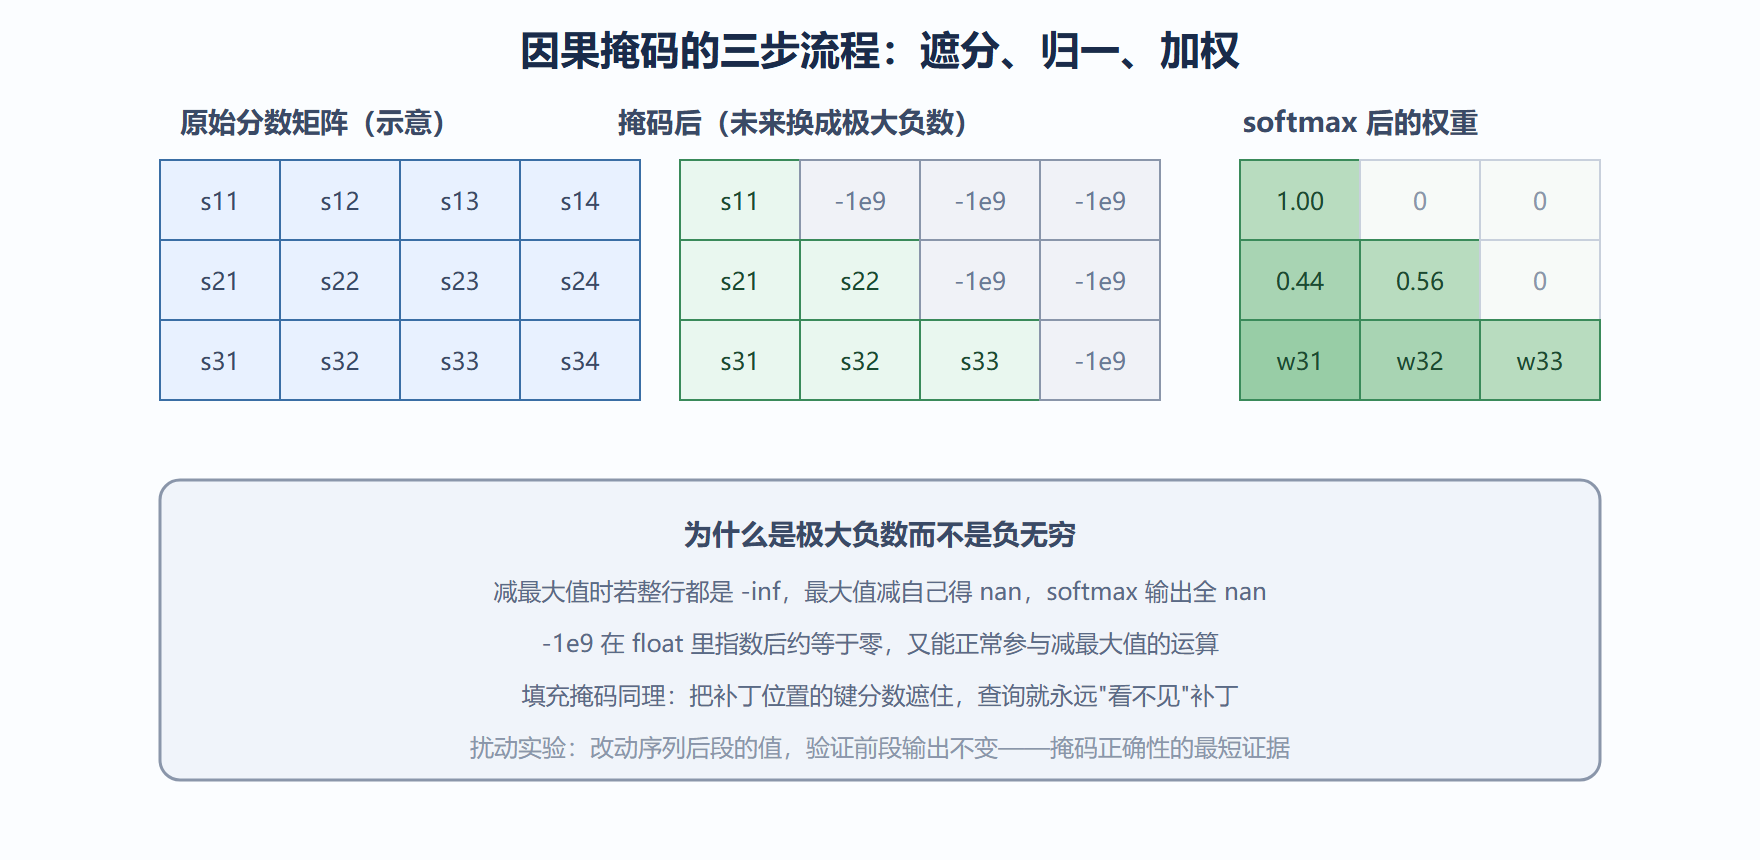
上下两段输出摆在一起,对比一目了然。因果版首行权重是一、零、零、零:第一个位置谁都看不见,只能全押自己。次行只剩前两列非零,且合计为一——softmax 的行归一化在掩码之后依然成立,因为被遮位置换成了极大负数,指数后趋近零。
掩码写得对不对,光看形状和归一化还不够。候选人主动做了扰动实验:
V2 = V.copy() V2[:, 2] += 100.0 # 只改动第 3 个位置的值向量 out_c2, _ = attention(Q, K, V2, mask=causal) print('前两行输出不变:', np.allclose(out_c[:, :2], out_c2[:, :2])) print('第三行起被影响 :', not np.allclose(out_c[:, 2], out_c2[:, 2]))
前两行输出不变: True 第三行起被影响 : True
改了第三位置的值,只有第三行之后的输出变化,前两行纹丝不动——信息流确实被限制在下三角里。这一步实验花了他二十秒,却把"掩码写对了"从感觉变成了证据,面试官在这里第一次抬头。
图 5-2 因果掩码:把未来位置的分数压成零
多头与位置编码是本题的下半场。多头不改变计算,只改变视角的个数:把十六维表示拆成四份,每份八维独立做注意力,最后拼回来。候选人的做法是先验证拆分与还原互为逆操作,再谈动机:
X = rng.normal(size=(2, 5, 16)) # 批2 长度5 维度16 B, L, D = X.shape h = 4 # 拆成4个头,每头4维 heads = X.reshape(B, L, h, D // h).transpose(0, 2, 1, 3) print('拆分后形状:', heads.shape) back = heads.transpose(0, 2, 1, 3).reshape(B, L, D) print('还原一致:', np.allclose(back, X)) def pe(max_len, d): pos = np.arange(max_len)[:, None] i = np.arange(d // 2)[None, :] ang = pos / np.power(10000, 2 * i / d) # 波长从 2π 到 10000·2π return np.concatenate([np.sin(ang), np.cos(ang)], axis=1) P = pe(64, 16) print('p0前四维:', P[0, :4].tolist()) print('p6前四维:', P[6, :4].round(3).tolist()) near = float(P[0] @ P[1] / (np.linalg.norm(P[0]) * np.linalg.norm(P[1]))) far = float(P[0] @ P[8] / (np.linalg.norm(P[0]) * np.linalg.norm(P[8]))) print('p0与p1夹角余弦:', round(near, 3), ' p0与p8:', round(far, 3))
拆分后形状: (2, 4, 5, 4) 还原一致: True p0前四维: [0.0, 0.0, 0.0, 0.0] p6前四维: [-0.279, 0.947, 0.565, 0.189] p0与p1夹角余弦: 0.936 p0与p8: 0.587
数字印证了位置编码的两条性质:相邻位置的编码向量夹角很小(零点九三六),离得越开越接近正交(零点五八七并随距离继续下降)——"相对距离可度量"正是自注意力需要的顺序信号。至于 p0 全零,候选人主动指出:"位置零的编码是零向量,不携带绝对信息,别慌——它跟其他位置的点积依然可分,而且这只是加性注入,语义主要还在词向量里。"
追问链
追问一:为什么除以根号维度? "点积的方差随维度线性增长——两个独立标准正态向量做八维点积,方差是八。分数一宽,softmax 就会走进饱和区:最大的那个趋近一、其余趋近零,梯度随之消失。除以根号维度把方差拉回一,让分布保持'软'的状态,这是从第 2 章初始化一路延续下来的尺度纪律。"面试官点头补了一句:这一问答不出,基本判定是背架构。
追问二:填充掩码和因果掩码同时存在怎么办? "两个掩码逐元素与一下:因果掩码管'不看右边',填充掩码管'不看补丁'。写法上都是把不要的位置分数换成极大负数,只是掩码矩阵的来源不同——一个是下三角,一个是长度表。批量实现里掩码形状要广播成 (批, 头, 长度, 长度),现场最常见的事故就是忘了广播,长度维对不上还以为代码对了。"
追问三:多头到底多了什么? "同一序列的多套子空间投影——每个头在自己的低维子空间里决定'谁该关注谁',有的头学句法依存,有的头学共指。拆分与合并只是 reshape 的功夫,计算量与单头同维几乎持平。验证拆分正确性的办法我刚做过:拆开再拼回,与原矩阵逐元素相等。"
优化与变式
推理阶段的优化是高频变式:生成式解码每步只新增一个位置,历史位置的键值不必重算,缓存起来即可——键值缓存把每步的计算从全长降到一步,代价是显存换时间。再往深一层是注意力本身的计算优化:分块计算让大矩阵不必整体驻留显存,配合在线 softmax 归纳,这就是近年流行的闪念注意力的核心思路,面试里说出"分块加在线归一"这一句就能接住追问。位置编码的变式方向是相对位置:与其给每个位置一个绝对编号,不如在打分时直接注入相对距离信息,长度外推更稳。这些变式的共同点都值得点破:没有任何一个改动推翻注意力的三步骨架——打分、归一、加权。
失误复盘
高频翻车点:transpose 与 reshape 的顺序搞反,多头拆出来的是错位的切片——输出形状全对、数值全错,这是注意力题最隐蔽的坑,防它只靠"拆开拼回逐元素相等"这一招;掩码忘了广播到批与头两个维度,长度维对不上报错还算走运;掩码用负无穷,遇到整行全遮的填充行直接输出 nan;除以根号维度忘了,权重糊成一团极值还找不到原因;softmax 手写版漏了减最大值——上一场刚复盘过的错误在这里复发,属于最伤的失误。
主线候选人这一场的高光正是扰动实验与拆分还原验证两个动作:他把"我觉得对"变成"我证明了没错",用的都是二十秒级的小实验。面试官评语:"代码是及格线,实验习惯才是加分项。"
关键直觉:注意力就是把"相关度"变成"权重"再变成"混合"的三步——掩码决定谁能参与竞争,缩放决定竞争是否激烈,位置编码决定打分时知不知道先后。