5.3 现场十五:文本分类全流程
5.3 现场十五:文本分类全流程
本节摘要:NLP 专场的集成题:不碰预训练模型,从分词、建词表、做特征,到手写逻辑回归训练,再到留出集评估,一条流水线跑通情感二分类。它本身不难,难在每一环都要答出"为什么这么做",以及词表泄漏这个全场埋得最深的坑。
纯手写的分类器在情感二分类上能走多远?这道题的答案经常让候选人意外:不微调任何预训练模型,只用词袋特征加逻辑回归,小样本数据集上就能跑到远超多数人预期的准确率。文本组面试官把它放在专场最后,考的不是单点知识,而是工程串联能力——上一场的分词、第 2 章的训练循环、第 3 章的交叉熵、现场六的评估纪律,全都要在这道题里接上。
面试官出题
"给你六条训练影评、两条测试影评,正面负面都有。从原始字符串开始:分词、建词表、做特征、写训练循环、评估,全部手写,不许调机器学习库。最后告诉我:你的词表是在哪个数据集上建的?为什么?"
最后那问是题眼。前面所有环节候选人几乎都练过,唯独"词表在哪建"能瞬间分辨谁是照流程跑、谁是懂原理跑——答案错了,等于全盘泄漏。
现场推演
候选人先在白板上画流水线:字符串 → 分词 → 词表映射 → 特征向量 → 训练 → 概率 → 阈值判决。画完才落笔,六个环节对应六段代码:
import numpy as np train = [ ('这部 电影 情节 紧凑 演员 卖力', 1), ('剧本 扎实 台词 有味 节奏 明快', 1), ('好看 二刷 画面 配乐 都 不错', 1), ('剧情 松散 演员 出戏 尴尬', 0), ('浪费 票钱 节奏 拖沓 看不下去', 0), ('烂片 口碑 崩塌 而且 剧情 混乱', 0), ] test = [('情节 紧凑 值得 二刷', 1), ('节奏 拖沓 尴尬 浪费 票钱', 0)] vocab = sorted({w for d, _ in train for w in d.split()}) # 只在训练集上建! def feat(text): v = np.zeros(len(vocab)) for w in text.split(): if w in vocab: v[vocab.index(w)] = 1.0 # 出现记一(演示版) return v X = np.stack([feat(d) for d, _ in train]) y = np.array([l for _, l in train], float) W, b = np.zeros(len(vocab)), 0.0 for epoch in range(300): # 逻辑回归训练循环 z = X @ W + b p = 1 / (1 + np.exp(-z)) # sigmoid 出概率 gw = X.T @ (p - y) / len(y) # 交叉熵的梯度 gb = float((p - y).mean()) W -= 0.5 * gw b -= 0.5 * gb for d, l in test: p = 1 / (1 + np.exp(-(feat(d) @ W + b))) print(d, '预测概率 %.3f' % p, '判决', int(p > 0.5), '真值', l)
情节 紧凑 值得 二刷 预测概率 0.940 判决 1 真值 1 节奏 拖沓 尴尬 浪费 票钱 预测概率 0.011 判决 0 真值 0
两条测试样本全对,而且概率姿态漂亮:正面句零点九四、负面句零点零一一,离判决阈值都有距离,说明模型不是蒙的。候选人逐段讲解:特征用的是二值而不是词频——几百条样本的小数据里,一个词出现与否比出现几次信号更稳,还天然抗个别词的刷频;训练循环就是第 2 章现场四的骨架,把均方误差换成对数损失、把线性输出过一道 sigmoid,梯度形式恰好还是"预测减真值"乘特征;零点五这个判决阈值是类别均衡时的默认约定,不均衡就得挪。
图 5-3 手写文本分类流水线:六个环节与两条纪律
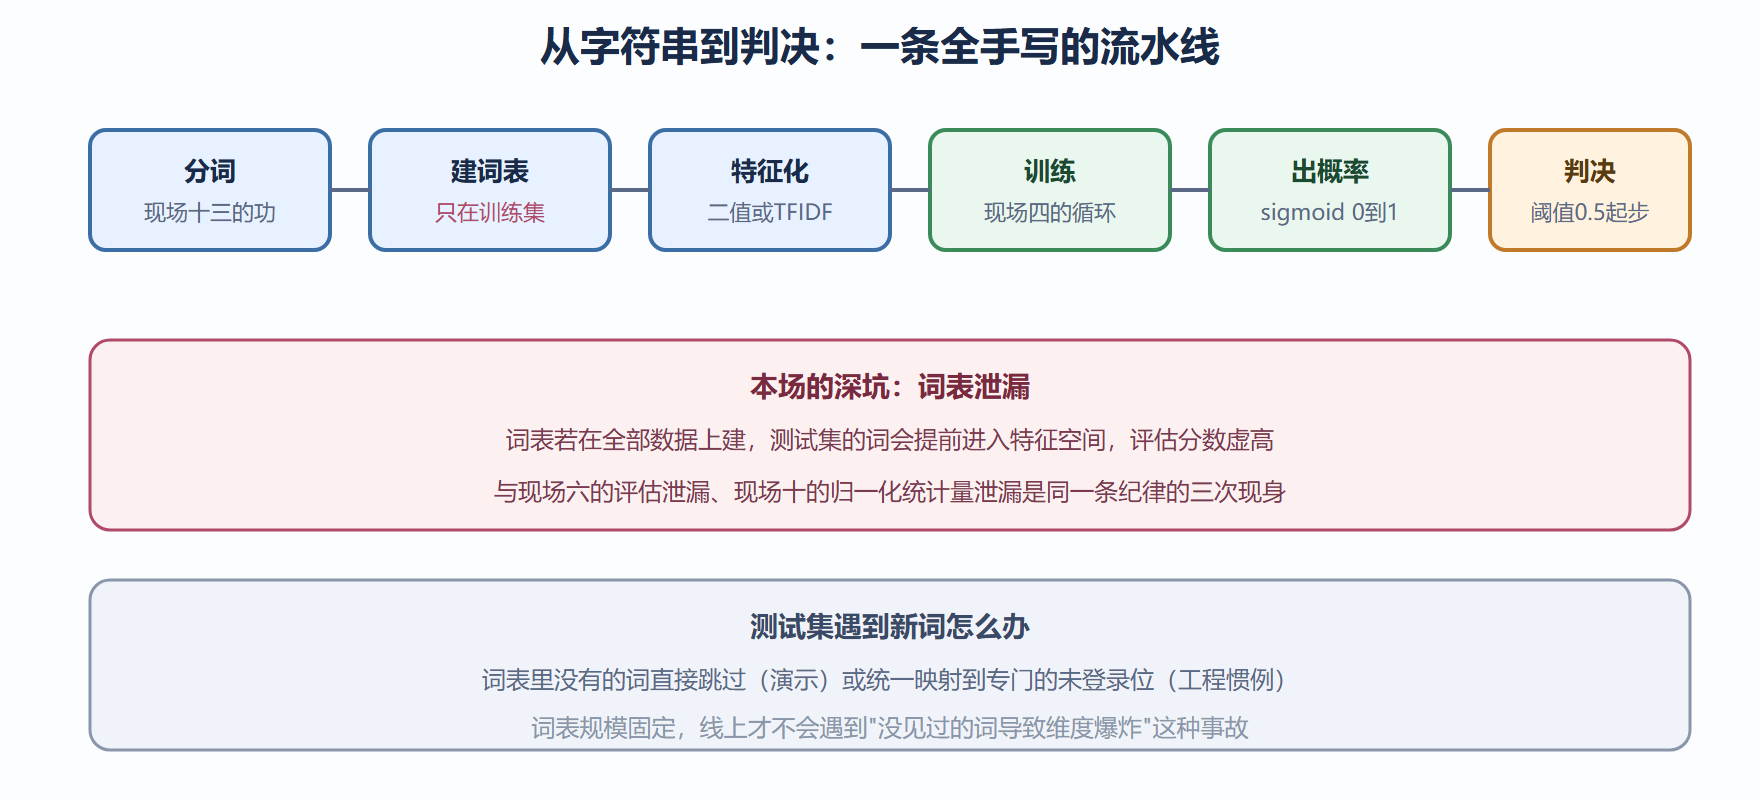
面试官接着问:"你词表在哪建的?"候选人指着代码里那行注释答:"训练集。词表是从数据里学出来的统计量,跟归一化的均值方差一个性质——测试集只能被映射,不能参与构建。测试句里的新词,词表里没有就跳过,工程上会统一映射到一个未登录专用位。"这正是面试官要听的那句:他把词表、均值、文档频率归成同一类东西,识破了题眼。
追问链
追问一:概率零点零一一怎么向业务方解释? "不是'正确率百分之一'——它是模型对这句话为正面的置信度。判决是阈值化的产物,概率才是模型的原始输出;要更高的召回就把阈值降到零点三,要更高的精度就升到零点七,移动阈值不改模型本身。汇报时给概率分布和阈值曲线,比只报一个准确率有信息量得多。"
追问二:正负样本不均衡怎么改? "三步走:损失里给少数类加权,等价于改变梯度里两类错误的代价;阈值跟着类别先验挪,不再用零点五;评估指标换掉准确率——九成负样本的数据里,全猜负也有九成准确率,要看精确率、召回率或者 AUC。AUC 的排序法手写在第 2 章现场六练过,直接搬。"
追问三:想涨点,下一步动哪里? "按性价比排序:先把二值特征换成现场十三的 TF-IDF;再试词的 n 元组,让'不 好'这种否定组合被看见;然后是词向量取平均,把语义相似性带进来;最后才是预训练模型微调——它替换的是特征段,流水线骨架不变。每动一处都要回到同一个留出集上比,控制变量。"面试官对"骨架不变"这个说法很受用:这正是本章想立的那个视角——流程是常量,每一环的实现是变量。
优化与变式
同一道题有三个常见变式壳:多分类(softmax 换掉 sigmoid,损失换成对数损失的多类形式,代码只动输出层)、层次标签(先判领域再判情感,两级流水线)、流式场景(词表定期重建、新词进未登录位,模型热更新)。变式之外还有一条倒推路径值得在复盘时走一遍:从预训练模型的微调脚本里,把特征化的部分一层层剥掉换成手写件,能剥到什么程度,就说明这条流水线里哪些环节是数据、哪些环节是归纳偏置——这道题真正的考点是让人看清:所谓模型,是流水线上最可替换的那一段。
失误复盘
高频翻车点按环节排:分词后忘了统一小写(英文混合场景);词表建在全量数据上——本题题眼,答错直接暴露评估纪律缺失;特征里用词频却忘了截断长文档的影响;sigmoid 数值溢出,正是现场八的考题在这场复现;梯度忘了除以样本数,学习率等效失调;判决时把概率四舍五入当成准确率口径向面试官汇报。还有一个表达层面的失误:被问"为什么对"时只说"跑通了"——跑通是及格线,说出每个环节的动机才是这道集成题的得分点。
主线候选人这一场稳在两点:先画流水线再写代码,每一段代码都能指回前面某一场的出处;词表问题脱口而出"训练集",还主动补了未登录位的工程惯例。面试官的收尾评语:"全流程的每一环你都欠着前面现场的债,今天算是连本带利还清了。下一章终面,考的就是往这段代码上泼冷水。"
关键直觉:文本分类的全流程没有新知识,只有旧知识的接线——分词来自现场十三,训练循环来自现场四,数值稳定来自现场八,评估纪律来自现场六;集成题考的是你能不能报出每一根线的来源。